RAVE von IRCAM: VST, vortrainierte Modelle und Training
Das RAVE-Modell von IRCAM ist ein neuronales Audiomodell für Echtzeitverarbeitung, das beliebige Klänge in die Klangfarbe überträgt, auf die es trainiert wurde. Sie können vortrainierte RAVE-Modelle mit Neutone FX oder dem RAVE VST in Ihrer DAW spielen, sie mit nn~ in Max/MSP oder Pure Data laden oder mit dem Python-Paket acids-rave eigene Modelle trainieren.
RAVE verwenden: Schnellstart
| Ziel | Werkzeug | Voraussetzungen |
|---|---|---|
| RAVE-Modelle in einer DAW spielen | Neutone FX (kostenloses VST/AU) | Eine beliebige DAW. Vortrainierte Modelle werden direkt im Plugin heruntergeladen. |
| RAVE-Modelle in einer DAW spielen | RAVE VST (Beta) | Ein Download vom IRCAM Forum. Das Quellcode-Repository wurde im Juni 2023 archiviert; die Windows-Version ist nur als eigenständige Anwendung verfügbar. |
| RAVE in Max/MSP oder Pure Data verwenden | nn~ External | Max oder Pd sowie eine Modelldatei im Format .ts |
| Vortrainierte Modelle herunterladen | Offizielle RAVE-Modellliste | Streaming-Exporte im Format .ts für nn~ |
| Ein eigenes Modell trainieren | acids-rave unter Python | Eine NVIDIA-GPU mit 5 bis 32 GB Speicher, einige Stunden Audiomaterial und etwa 3 Tage |
Um nn~ zu installieren, laden Sie die neueste Version herunter und entpacken Sie sie für Max in Documents/Max [your version]/Packages/ oder für Pure Data in Documents/Pd/externals/. Legen Sie Ihre .ts-Modelle im Ordner nn_tilde/models ab.

Was ist IRCAM RAVE für die Audiosynthese in Echtzeit?
RAVE steht für Realtime Audio Variational autoEncoder, also einen variationalen Audio-Autoencoder für Echtzeitverarbeitung. Das Modell wurde Ende 2021 von Forschern des IRCAM in Paris veröffentlicht. Es lernt, Klänge in eine kompakte Darstellung zu kodieren und diese anschließend wieder in Audio zu dekodieren. Stellen Sie sich vor, Sie bringen einem Computer bei, das Gehörte zu skizzieren und aus dieser Skizze eine überzeugende Nachbildung des ursprünglichen Klangs zu erstellen.
Das gelingt schnell genug, um in Ihrer DAW oder Ihrem Setup für Live-Auftritte in Echtzeit zu laufen.
Wer hat RAVE entwickelt und wann?
RAVE wurde von Antoine Caillon, der heute bei Google DeepMind arbeitet, und Philippe Esling aus dem ACIDS-Team des IRCAM in Paris entwickelt.
Das Team hatte zuvor Googles DDSP-Modell (Differentiable Digital Signal Processing) untersucht und im März 2021 vorgestellt. Es wollte jedoch ein flexibleres Modell, das jede Art von Klang verarbeiten kann, nicht nur Musikinstrumente.
Das Ziel war ein Modell, das auf üblicher Hardware läuft und dabei Audio in Studioqualität liefert. Das Team stellte es 2021 in seinem Paper „RAVE: ein variationaler Autoencoder für schnelle und hochwertige neuronale Audiosynthese“ vor.
RAVE-Architektur: So funktioniert dieser variationale Autoencoder
RAVE ist ein Autoencoder: ein neuronales Netz, das lernt, Daten in einen kompakten „latenten Raum“ zu komprimieren und anschließend wieder zu dekomprimieren.
RAVE: Training in zwei Phasen
Phase 1: Lernen der Repräsentation
Phase 2: Adversariales Feintraining
Trainingsdiagramm nach der ursprünglichen RAVE-Publikation. Phase 1 trainiert Encoder und Decoder mit einem Multiband-Spektralfehler. Phase 2 friert den Encoder ein, stoppt Gradienten durch den latenten Code und trainiert Decoder und Diskriminator. PQMF-Analyse und -Synthese bleiben fest.
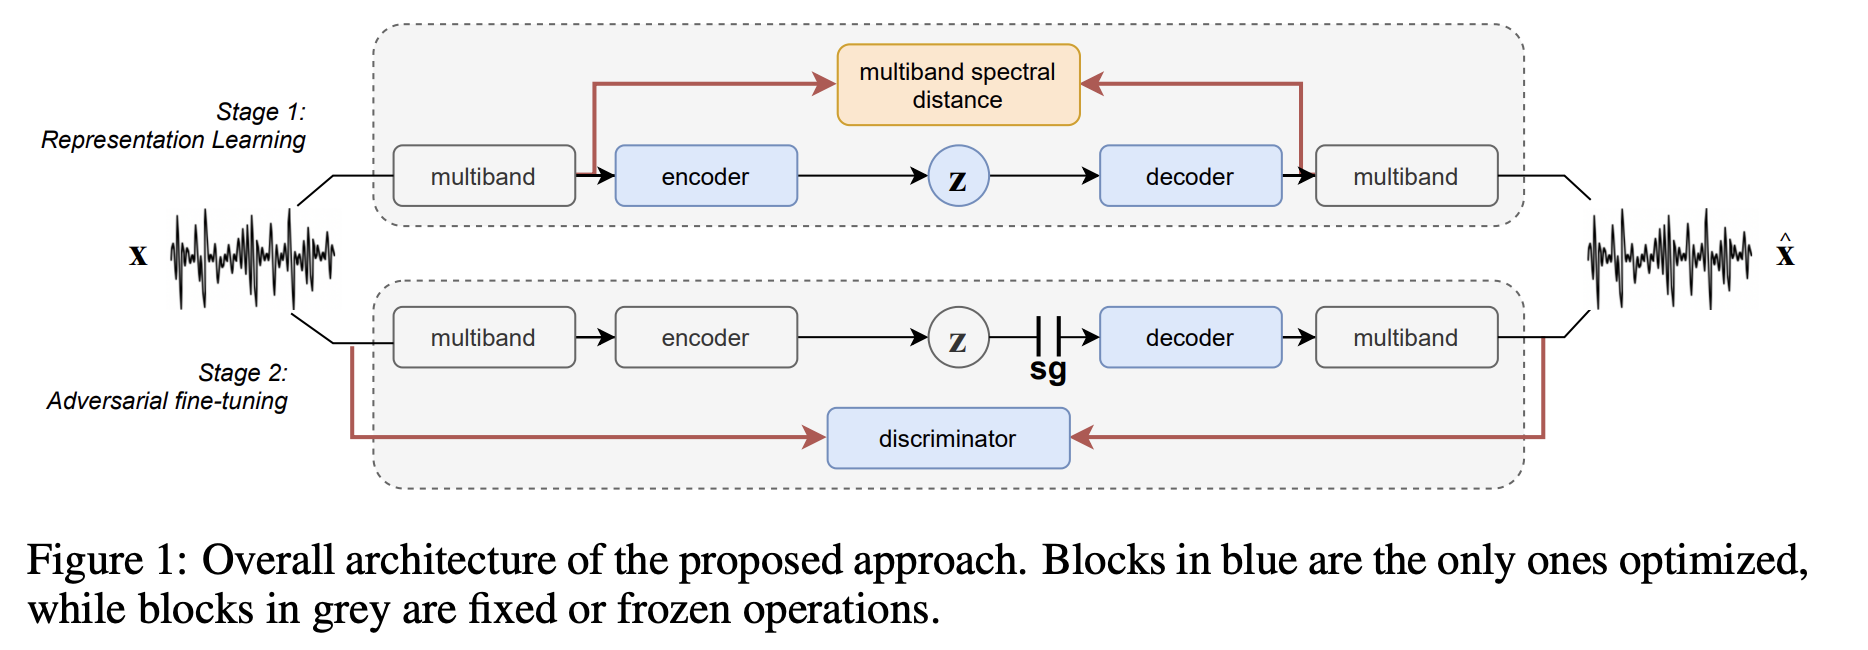
Originalabbildung: RAVE: Training in zwei Phasen.
So funktioniert das zweistufige Training von RAVE
Stellen Sie sich das wie die Ausbildung eines Musikers in zwei Phasen vor:
-
Phase 1: Zuhören lernen (Repräsentationslernen)
- Der Encoder lernt, Audio zu einer kompakten Menge von Zahlen zusammenzufassen (dem latenten Raum)
- Der Decoder lernt, Audio aus diesen Zahlen zu rekonstruieren
- Das Training verwendet einen spektralen Fehler, der den Frequenzinhalt des ursprünglichen und des rekonstruierten Audios vergleicht
-
Phase 2: Improvisieren lernen (adversariale Feinabstimmung)
- Der Encoder wird eingefroren (er weiß bereits, wie er zuhören muss)
- Ein „Diskriminator“-Netz kommt hinzu: ein Kritiker, der beurteilt, ob das rekonstruierte Audio echt klingt
- Der Decoder lernt aus dieser Rückmeldung, überzeugenderes Audio zu erzeugen
Zentrale technische Komponenten
- PQMF-Filter: RAVE teilt Audio vor der Verarbeitung in mehrere Frequenzteilbänder auf und arbeitet dadurch effizienter
- Kausale und nicht kausale Modi: Der kausale Modus nimmt etwas geringere Qualität in Kauf, um die Latenz bei Live-Anwendungen zu senken
- Mehrere Konfigurationen: von der schlanken Konfiguration „raspberry“ (läuft auf einem Raspberry Pi) bis zur hochwertigen Konfiguration „v3“
Details zur Implementierung finden Sie im offiziellen RAVE-Repository auf GitHub, das die Konfigurationsdateien und Modelldefinitionen enthält.

Wie trainieren Sie RAVE-Modelle mit eigenen Audiodaten?
Möchten Sie ein Modell, das Ihre Stimme in ein Saxofon verwandelt? Für das Training eines RAVE-Modells benötigen Sie Python-Kenntnisse und eine GPU. Das offizielle RAVE-Repository dokumentiert den gesamten Ablauf.
Anforderungen an die Vorbereitung des Datensatzes
Für das Training eines RAVE-Modells benötigen Sie:
- 2 bis 3 Stunden sauberes Audiomaterial (mehr ist besser)
- Aufnahmen in Studioqualität, denn RAVE lernt alles, auch Rauschen und Hall
- Vielfältige Klänge, wenn das Modell vielseitig einsetzbar sein soll
Um einen Datensatz aus vollständigen Mischungen aufzubauen, isolieren Sie zunächst das Instrument mit hochwertiger KI-Stem-Trennung. Auch Trennartefakte gehen in das Modell ein. Verwenden Sie deshalb die saubersten Stems, die Sie erhalten können. Die Anleitung zur Stem-Trennung zeigt den Ablauf in Neural Analog.
RAVE installieren und den Datensatz vorbereiten
Installieren Sie zuerst PyTorch und TorchAudio für Ihre GPU, anschließend RAVE. Sie benötigen außerdem FFmpeg; installieren Sie es in einer conda-Umgebung mit conda:
pip install acids-rave
conda install ffmpeg
Die Vorverarbeitung wandelt Ihre Audiodateien in das Datensatzformat von RAVE um:
rave preprocess --input_path /audio/folder --output_path /dataset/path --channels 1Verwenden Sie --channels 1 für Mono oder --channels 2 für Stereo. Fügen Sie --lazy hinzu, um direkt mit komprimierten Dateien wie MP3 zu trainieren. Rechnen Sie dann allerdings mit einer deutlich höheren CPU-Last während des Trainings. Alle Parameter finden Sie in der Dokumentation zur Vorbereitung von RAVE-Datensätzen.
Trainingsablauf und Konfigurationen von RAVE
Starten Sie das Training mit einem Konfigurationsnamen:
rave train --config v2 --db_path /dataset/path --out_path /model/out --name my_model --channels 1Wählen Sie die Konfiguration passend zu Ihrer GPU. Die Mindestwerte für den GPU-Speicher stammen aus der offiziellen README:
| Konfiguration | Mindest-GPU-Speicher | Einsatzgebiet |
|---|---|---|
raspberry | 5 GB | Schlankes Modell für Echtzeitverarbeitung auf einem Raspberry Pi 4 |
onnx | 6 GB | Rauschfreies v1 für den ONNX-Export |
v1 | 8 GB | Das ursprüngliche kontinuierliche Modell |
v2_small | 8 GB | Klangfarbenübertragung bei stationären Klängen |
v2 | 16 GB | Das verbesserte kontinuierliche Modell und eine gute Standardwahl |
discrete | 18 GB | Ein diskretes Modell ähnlich SoundStream oder EnCodec |
v3 | 32 GB | Höchste Qualität mit Stilübertragung (AdaIN) |
Sie können eine Konfiguration mit Optionen wie causal (geringere Latenz) oder noise kombinieren. Ein von der Community erstelltes Colab-Notebook für RAVEv2, das in der README verlinkt ist, trainiert auf Googles GPUs, falls Sie keine eigene haben.
Das erwartet Sie beim Training:
- Phase 1 (~1M Schritte): Die Audioqualität ist zunächst schwach und verbessert sich allmählich
- Phase 2 (adversariales Training): Die Qualität steigt deutlich
- Gesamtdauer: etwa 3 Tage auf einer RTX 3080 GPU
Von der Community bereitgestellte RAVE-Trainingsnotebooks führen Schritt für Schritt durch den Ablauf.
RAVE-Modelle für die Echtzeitverwendung exportieren
Der Export ist für die Echtzeitverwendung wichtig. Nutzen Sie das Flag --streaming, um zwischengespeicherte Faltungen zu aktivieren und dadurch Knackartefakte zu verhindern:
rave export --run /path/to/your/run --streamingDas Ergebnis ist eine TorchScript-Datei im Format .ts, die nn~ laden kann. Exportparameter und Hinweise zur Fehlerbehebung finden Sie in der RAVE-Exportdokumentation.
RAVE-Inferenz und Möglichkeiten zur Echtzeitverwendung
Möchten Sie nicht 3 Tage auf das Training warten? Sie können vortrainierte RAVE-Modelle in mehreren Werkzeugen ausprobieren. Diese laden auch selbst trainierte Modelle. Die FAQ zur Verwendung eines trainierten Modells in Ihrer DAW nennt das passende Plugin für jeden Modelltyp.
Neutone FX: kostenloses VST/AU-Plugin für RAVE-Modelle
Neutone FX ist ein kostenloses VST/AU-Plugin, das RAVE-Modelle ausführt. Es ist das ursprüngliche Neutone-Plugin von 2022 und wird inzwischen als offene Plattform gepflegt. Nach der Installation können Sie eine Sammlung vortrainierter Modelle direkt in Ihrer DAW laden (Ableton, Logic, Reaper und andere).

RAVE VST von IRCAM (Beta, archiviert)
IRCAM hat auch ein eigenes RAVE VST als VST, AU und eigenständige Anwendung veröffentlicht. Es bietet zwei Modi: reconstruction verarbeitet das Audio aus Ihrer DAW; prior erzeugt selbstständig Klang, indem es sich durch den latenten Raum bewegt. Der Model Explorer lädt vortrainierte Modelle herunter. Sie können auch eigene importieren, wenn Sie diese mit --stereo true exportieren.
Das rave_vst-Repository wurde im Juni 2023 archiviert. Rechnen Sie daher nicht mit Fehlerbehebungen. Für Windows gibt es nur eine experimentelle eigenständige Version; Nutzer eines M1 Mac müssen das Programm selbst kompilieren. Die Entwickler empfehlen stattdessen nn~ für die Echtzeitverwendung.
Integration in Max/MSP und Pure Data mit nn~
Für Live-Auftritte lädt das nn~ External RAVE-Modelle direkt in Max/MSP und Pure Data. Es ermöglicht die direkte Bearbeitung des latenten Raums und Adaptive Instance Normalization zur Stilübertragung. Es läuft außerdem auf eingebetteten Plattformen wie dem Raspberry Pi für mobile Installationen. Auf denselben Platinen laufen neuronale Gitarrenverstärker-Plugins wie ToobAmp und Stompbox. Wenn Sie einen NVIDIA Jetson Nano verwenden, beachten Sie, dass er keinen analogen Audioausgang hat: Ergänzen Sie zuerst eine I2S-Soundkarte wie Raspiaudio Audio+.
Leistungsgrenzen und technische Einschränkungen von RAVE
Beachten Sie diese Einschränkungen, bevor Sie sich auf RAVE verlassen:
- Latenz: Selbst im kausalen Modus ist eine spürbare Verzögerung zu erwarten, auch auf leistungsfähigen Apple-Silicon-Geräten. Im Studio ist das in Ordnung. Testen Sie RAVE jedoch sorgfältig, bevor Sie es als Live-Instrument einsetzen.
- GPU-Beschleunigung: Das Modell verwendet viele kleine Faltungen, deren Leistung durch Speicherzugriffe statt durch Rechenleistung begrenzt ist. Deshalb lässt es sich nur schlecht parallelisieren. Bei Echtzeitverwendung überwiegt der GPU-Overhead oft den Nutzen, außer bei Stapelverarbeitung.
- Audioqualität: RAVE kann beeindruckend klingen, erreicht aber möglicherweise nicht die Klangtreue herkömmlicher Synthese oder leistungsfähigerer neuronaler Modelle, etwa solcher auf Diffusionsbasis.
- Anspruchsvolles Training: Das Training eines RAVE-Modells erfordert Kenntnisse in maschinellem Lernen und Audioverarbeitung sowie leistungsfähige Hardware.
Weiterentwicklungen von RAVE: Neutone Morpho und das AFTER-Modell
Neutone Morpho: kommerzielle Weiterentwicklung von RAVE (2024)
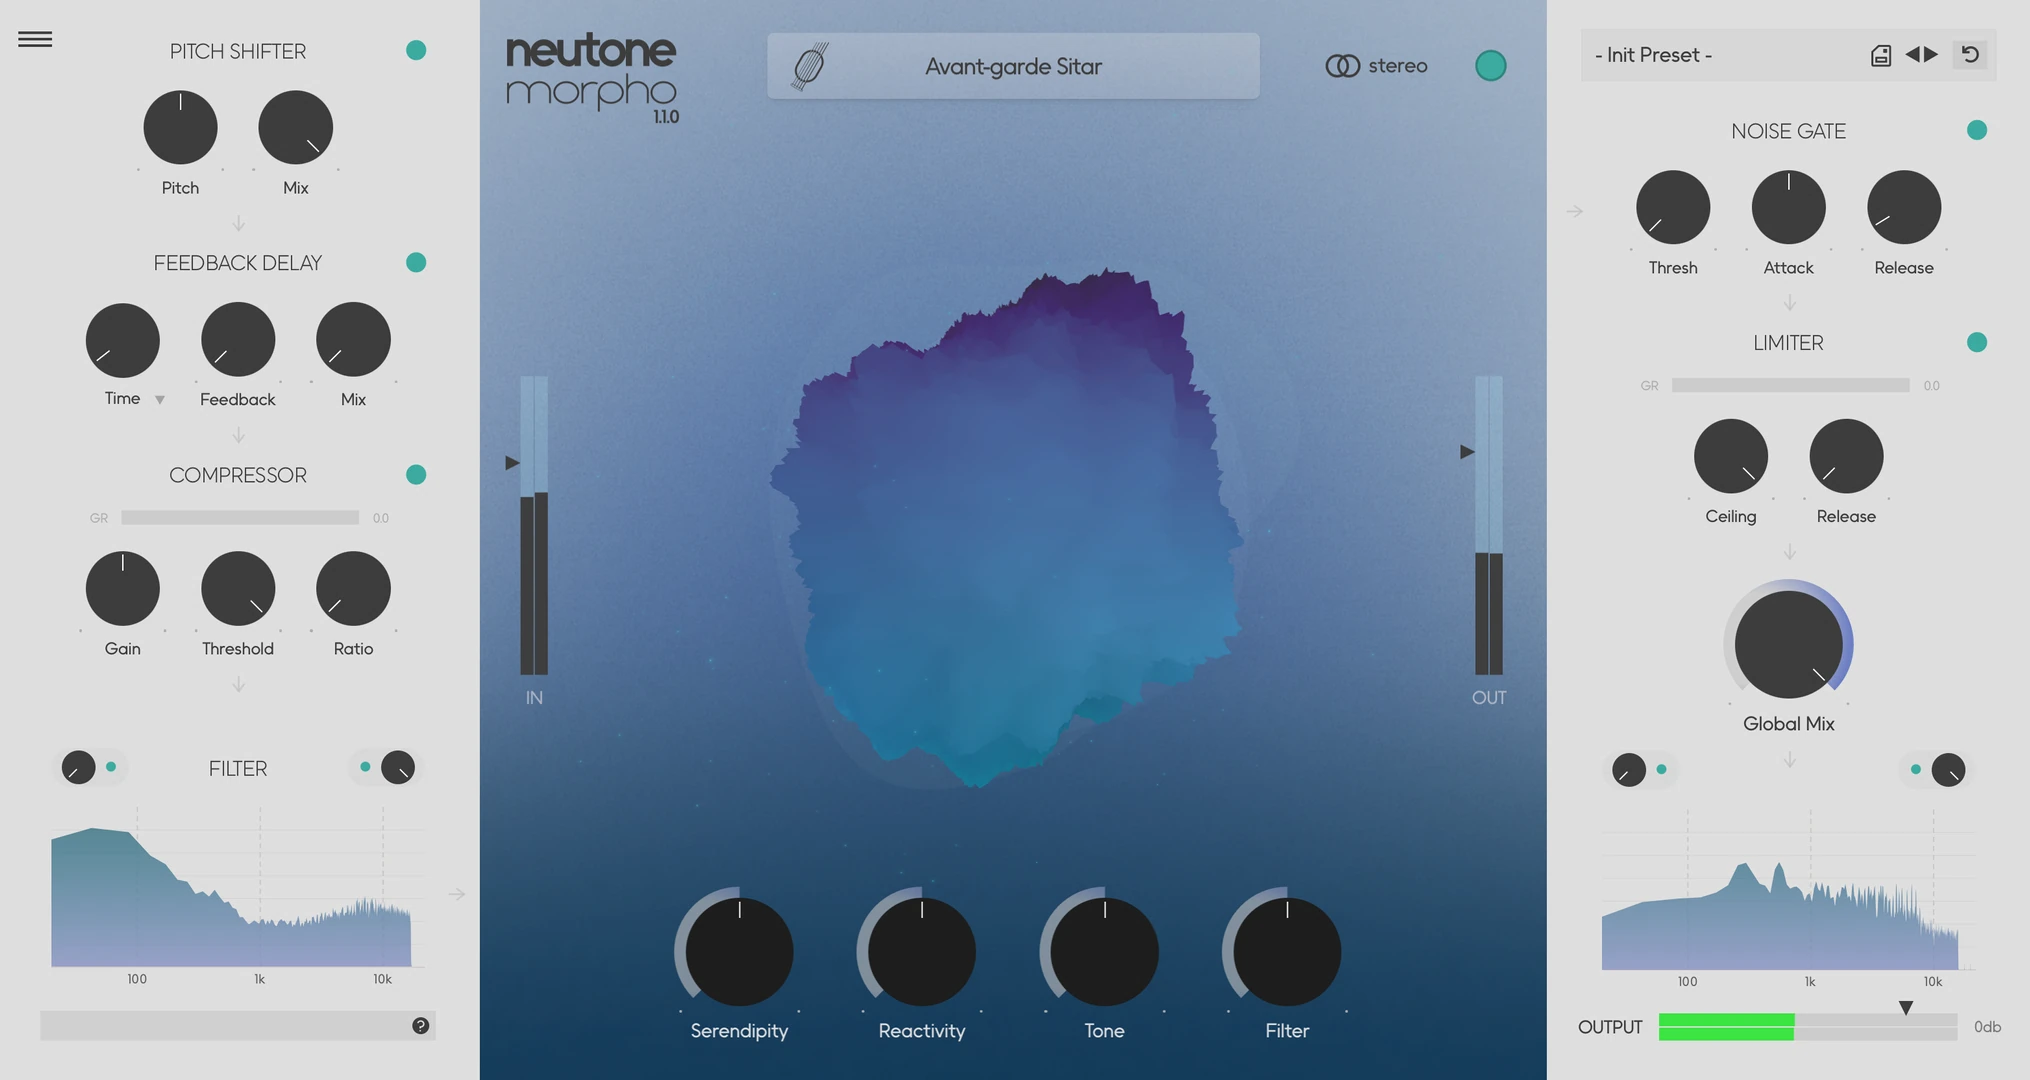
Im Februar 2024 veröffentlichte das Neutone-Team unter der Leitung von Nao Tokui Morpho, einen kommerziellen Nachfolger seines kostenlosen FX-Plugins. RAVE ist die für Forschungszwecke entwickelte Open-Source-Engine. Morpho verpackt ähnliche Technologie in ein ausgereiftes Produkt für Musiker und Produzenten, bietet dafür jedoch weniger Flexibilität.
AFTER-Modell: diffusionsbasierte Alternative von IRCAM
Dasselbe ACIDS-Team des IRCAM hat auch AFTER (Audio Features Transfer and Exploration in Real-time) veröffentlicht, ein diffusionsbasiertes Modell. Es soll mehr Einstellmöglichkeiten bieten, mit Echtzeitsteuerung der Klangfarbe wie bei einem herkömmlichen Synthesizer.
Um den Stil eines ganzen Songs anhand eines Textprompts statt eines einzelnen Klangs zu verändern, erhält KI-Remix den Gesangs-Stem und erzeugt die Instrumentalbegleitung mit Stable Audio 3 neu.
Häufige Fragen zu RAVE
Wo kann ich vortrainierte RAVE-Modelle herunterladen?
IRCAM listet Streaming-Modelle auf der offiziellen RAVE-Modellseite. Neutone FX und das RAVE VST können Modelle ebenfalls direkt im Plugin herunterladen. Prüfen Sie die Lizenz jedes Modells, bevor Sie es in einer kommerziellen Veröffentlichung verwenden.
Wie viel Audiomaterial benötige ich für das Training von RAVE?
Planen Sie 2 bis 3 Stunden sauberes Audiomaterial aus einer einzigen Quelle ein. RAVE lernt alles in den Aufnahmen, einschließlich Rauschen und Raumhall. Die Angaben für DDSP und AFTER finden Sie unter Wie viele Daten benötige ich für das Training eines Modells?.
Kann ich RAVE auf einem Mac trainieren?
Ein Mac eignet sich dafür nicht gut. Die RAVE-Anleitung des UAL Creative Computing Institute verlangt eine CUDA-fähige NVIDIA-GPU mit mindestens 8 GB Speicher und rät von macOS ab. Nutzen Sie stattdessen eine Cloud-GPU oder das Colab-Notebook der Community.
Warum knackt mein RAVE-Modell in Max?
Das Modell wurde ohne --streaming exportiert. Exportieren Sie es erneut mit diesem Flag.
RAVE oder DDSP?
DDSP benötigt nur etwa 10 Minuten Audiomaterial, modelliert jedoch ausschließlich einstimmige Instrumente mit bestimmter Tonhöhe. RAVE verarbeitet beliebige Klänge, einschließlich Schlagzeug, Stimmen und Texturen, benötigt dafür aber mehrere Stunden Audio und mehrere Tage Training.