Модель RAVE от IRCAM: VST, готовые модели и обучение
RAVE от IRCAM — нейросетевая аудиомодель реального времени, которая преобразует любой звук в тембр, на котором обучалась. Предобученные модели RAVE можно использовать в DAW через Neutone FX или RAVE VST, загружать в Max/MSP или Pure Data через nn~ либо обучать собственные с Python-пакетом acids-rave.
Как использовать RAVE: быстрый старт
| Цель | Инструмент | Что понадобится |
|---|---|---|
| Использовать модели RAVE в DAW | Neutone FX (бесплатный VST/AU) | Любая DAW. Предобученные модели скачиваются внутри плагина. |
| Использовать модели RAVE в DAW | RAVE VST (бета) | Файл из IRCAM Forum. Репозиторий исходного кода архивирован в июне 2023 года, а сборка для Windows работает только как отдельное приложение. |
| Использовать RAVE в Max/MSP или Pure Data | Внешний модуль nn~ | Max или Pd и файл модели .ts |
| Скачать предобученные модели | Официальный список моделей RAVE | Потоковые экспорты .ts для nn~ |
| Обучить собственную модель | acids-rave на Python | GPU NVIDIA с памятью от 5 до 32 GB, несколько часов аудио и около 3 дней |
Чтобы установить nn~, скачайте последний релиз и распакуйте его в Documents/Max [your version]/Packages/ для Max или Documents/Pd/externals/ для Pure Data. Поместите модели .ts в папку nn_tilde/models.

Что такое IRCAM RAVE для синтеза аудио в реальном времени?
RAVE расшифровывается как Realtime Audio Variational autoEncoder, то есть вариационный автокодировщик аудио реального времени. Модель, выпущенная в конце 2021 года исследователями IRCAM в Париже, учится кодировать звуки в компактное представление, а затем декодировать его обратно в аудио. Представьте, что компьютер учат делать набросок услышанного, а затем по этому наброску создавать убедительную имитацию исходного звука.
Модель делает это достаточно быстро, чтобы работать в реальном времени внутри DAW или системы для живых выступлений.
Кто и когда создал RAVE?
RAVE разработали Antoine Caillon, который сейчас работает в Google DeepMind, и Philippe Esling из парижской команды ACIDS в IRCAM.
До этого команда изучала модель Google DDSP (Differentiable Digital Signal Processing, дифференцируемая цифровая обработка сигналов) и продемонстрировала её в марте 2021 года, но хотела создать более гибкую модель для любых типов звука, а не только музыкальных инструментов.
Целью была модель, которая работает на обычном оборудовании и выдаёт аудио студийного качества. Её представили в статье 2021 года «RAVE: вариационный автокодировщик для быстрого и высококачественного нейросетевого синтеза аудио».
Архитектура RAVE: как работает этот вариационный автокодировщик
RAVE — автокодировщик: нейронная сеть, которая учится сжимать данные в компактное «латентное пространство», а затем распаковывать их обратно.
RAVE: обучение в два этапа
Этап 1: обучение представлению
Этап 2: состязательное дообучение
Схема обучения адаптирована из оригинальной статьи о RAVE. На этапе 1 кодировщик и декодировщик обучаются с многополосной спектральной функцией потерь. На этапе 2 кодировщик замораживается, распространение градиентов через латентный код блокируется, а декодировщик и дискриминатор обучаются. Анализ и синтез PQMF остаются фиксированными.
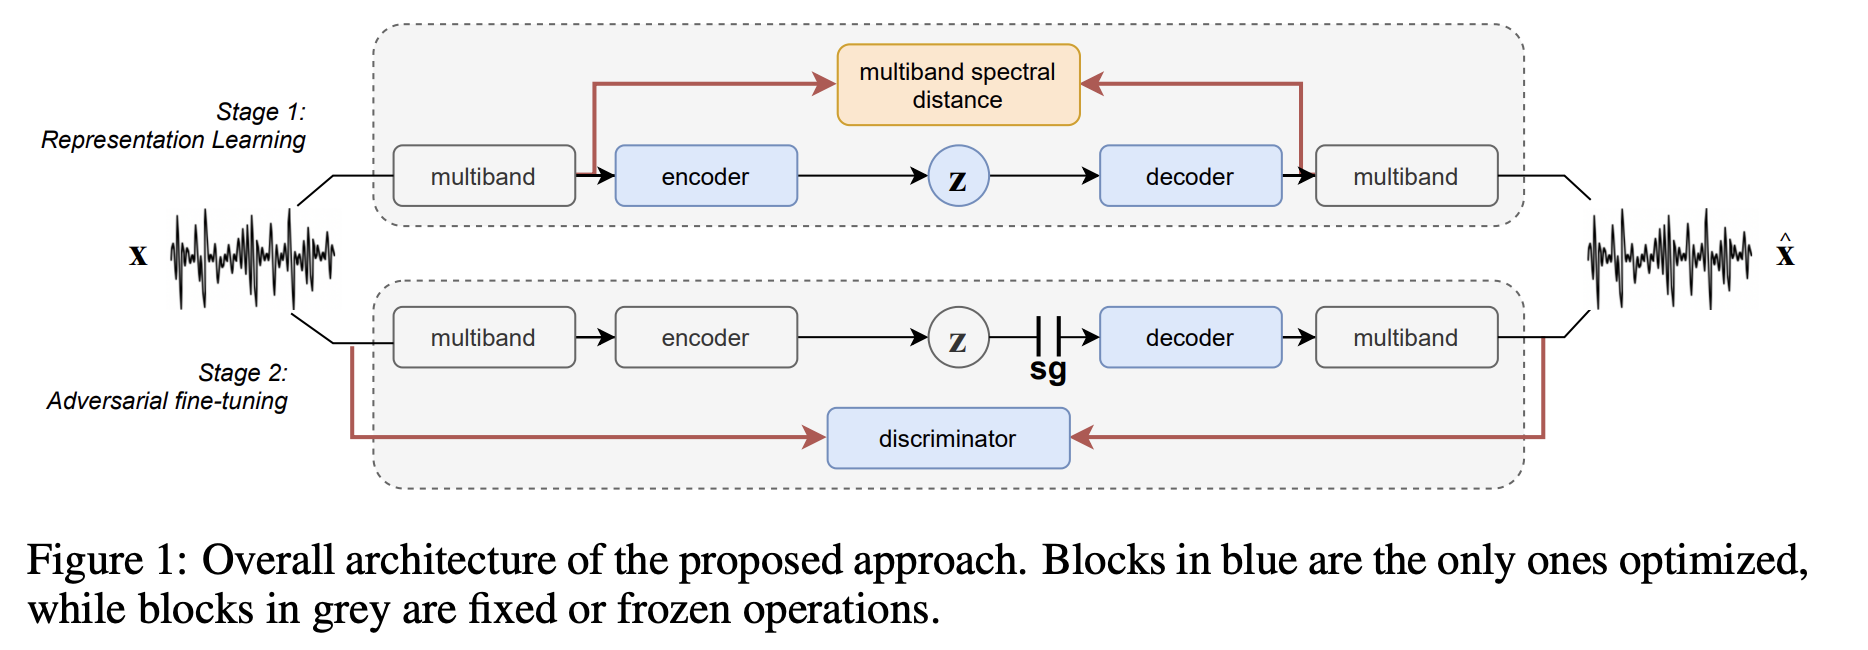
Оригинальная иллюстрация: RAVE: обучение в два этапа.
Как работает двухэтапное обучение RAVE
Представьте обучение музыканта в две фазы:
-
Фаза 1: учимся слушать (обучение представлению)
- Кодировщик учится сжимать аудио в компактный набор чисел, то есть латентное пространство
- Декодировщик учится реконструировать аудио по этим числам
- Для обучения используется спектральная функция потерь, которая сравнивает частотное содержимое исходного и реконструированного аудио
-
Фаза 2: учимся импровизировать (состязательное дообучение)
- Кодировщик замораживается: он уже умеет слушать
- Добавляется сеть «дискриминатор»: критик, оценивающий, звучит ли реконструированное аудио правдоподобно
- На основе этой обратной связи декодировщик учится создавать более убедительное аудио
Основные технические компоненты
- Фильтры PQMF: перед обработкой RAVE разделяет аудио на несколько частотных подполос, что повышает эффективность
- Каузальный и некаузальный режимы: каузальный режим жертвует частью качества ради меньшей задержки при живом исполнении
- Несколько конфигураций: от облегчённой "raspberry", которая работает на Raspberry Pi, до высококачественной "v3"
Подробности реализации приведены в официальном GitHub-репозитории RAVE, где есть файлы конфигураций и определения моделей.

Как обучать модели RAVE на собственном аудио?
Хотите модель, которая превращает ваш голос в саксофон? Для обучения RAVE нужны знания Python и GPU. Полный процесс описан в официальном репозитории RAVE.
Требования к подготовке набора данных
Для обучения модели RAVE понадобятся:
- От 2 до 3 часов чистого аудио: чем больше, тем лучше
- Записи студийного качества, поскольку RAVE усваивает всё, включая шум и реверберацию
- Разнообразные звуки, если нужна универсальность
Чтобы собрать набор данных из полных миксов, сначала выделите инструмент с помощью качественного разделения на стемы с ИИ. Артефакты разделения тоже попадут в модель, поэтому используйте максимально чистые стемы. Руководство по разделению на стемы показывает, как сделать это в Neural Analog.
Установите RAVE и подготовьте набор данных
Сначала установите PyTorch и TorchAudio для вашего GPU, затем RAVE. Также нужен FFmpeg; в окружении conda установите его через conda:
pip install acids-rave
conda install ffmpeg
Предобработка преобразует аудиофайлы в формат набора данных RAVE:
rave preprocess --input_path /audio/folder --output_path /dataset/path --channels 1Используйте --channels 1 для моно или --channels 2 для стерео. Добавьте --lazy, чтобы обучать напрямую на сжатых файлах, например MP3, но будьте готовы к значительно большей нагрузке на CPU во время обучения. Все параметры перечислены в документации по подготовке набора данных RAVE.
Процесс обучения и конфигурации RAVE
Запустите обучение, указав имя конфигурации:
rave train --config v2 --db_path /dataset/path --out_path /model/out --name my_model --channels 1Выберите конфигурацию под свой GPU. Минимальные требования к памяти GPU приведены в официальном README:
| Конфигурация | Мин. память GPU | Для чего подходит |
|---|---|---|
raspberry | 5 GB | Облегчённая модель для работы в реальном времени на Raspberry Pi 4 |
onnx | 6 GB | v1 без шума для экспорта в ONNX |
v1 | 8 GB | Исходная непрерывная модель |
v2_small | 8 GB | Перенос тембра стационарных звуков |
v2 | 16 GB | Улучшенная непрерывная модель и хороший вариант по умолчанию |
discrete | 18 GB | Дискретная модель, похожая на SoundStream или EnCodec |
v3 | 32 GB | Максимальное качество с переносом стиля (AdaIN) |
Конфигурацию можно сочетать с опциями causal (меньшая задержка) или noise. Если у вас нет GPU, блокнот Colab для RAVEv2 от сообщества, на который ссылается README, позволяет обучать на GPU Google.
Чего ждать во время обучения:
- Фаза 1 (~1 млн шагов): сначала аудио звучит грубо, затем качество постепенно улучшается
- Фаза 2 (состязательное обучение): качество резко повышается
- Общее время: около 3 дней на GPU RTX 3080
Блокноты для обучения RAVE, подготовленные сообществом, проводят через процесс шаг за шагом.
Экспорт моделей RAVE для работы в реальном времени
Для работы в реальном времени важен способ экспорта. Используйте флаг --streaming, чтобы включить кэшируемые свёртки и предотвратить артефакты в виде щелчков:
rave export --run /path/to/your/run --streamingРезультат — файл TorchScript .ts, который может загрузить nn~. Параметры экспорта и решения проблем приведены в документации по экспорту RAVE.
Использование модели RAVE и варианты работы в реальном времени
Не хотите ждать 3 дня обучения? Предобученные модели RAVE можно попробовать в нескольких инструментах. Они также загружают модели, которые вы обучили сами, а FAQ об использовании обученной модели в DAW перечисляет плагины для каждого типа модели.
Neutone FX: бесплатный плагин VST/AU для моделей RAVE
Neutone FX — бесплатный плагин VST/AU для работы с моделями RAVE. Это первоначальный плагин Neutone 2022 года, который сейчас поддерживается как открытая платформа. Установите его, чтобы загружать коллекцию предобученных моделей прямо в DAW: Ableton, Logic, Reaper и другие.

RAVE VST от IRCAM: бета-версия, архивирован
IRCAM также выпустил собственный RAVE VST со сборками VST, AU и отдельного приложения. В нём два режима: reconstruction обрабатывает аудио из DAW, а prior самостоятельно генерирует звук, перемещаясь по латентному пространству. Model Explorer скачивает предобученные модели; можно импортировать и свои, если экспортировать их с --stereo true.
Репозиторий rave_vst архивирован в июне 2023 года, поэтому исправлений ждать не стоит. Для Windows существует только экспериментальная сборка отдельного приложения, а пользователи Mac с M1 должны собирать её самостоятельно. Для работы в реальном времени разработчики рекомендуют вместо неё nn~.
Интеграция с Max/MSP и Pure Data через nn~
Для живых выступлений внешний модуль nn~ загружает модели RAVE прямо в Max/MSP и Pure Data. Он позволяет напрямую управлять латентным пространством и использовать адаптивную нормализацию экземпляров (Adaptive Instance Normalization) для переноса стиля. Он также работает на встраиваемых платформах, например Raspberry Pi, для переносных установок. На тех же платах работают нейросетевые плагины гитарных усилителей, такие как ToobAmp и Stompbox. Если у вас NVIDIA Jetson Nano, учтите отсутствие аналогового аудиовыхода: сначала добавьте звуковую карту I2S, например Raspiaudio Audio+.
Ограничения производительности и технические особенности RAVE
Прежде чем полагаться на RAVE, учтите ограничения:
- Задержка: даже в каузальном режиме ожидайте заметную задержку, в том числе на мощных Apple Silicon. Для студии это приемлемо, но перед использованием RAVE как живого инструмента тщательно протестируйте его.
- Ускорение на GPU: модель использует множество небольших свёрток, ограниченных скоростью доступа к памяти, а не вычислительной мощностью, поэтому плохо распараллеливается. При работе в реальном времени накладные расходы GPU часто перевешивают выгоду, если вы не обрабатываете аудио пакетно.
- Качество аудио: RAVE может звучать впечатляюще, но точность воспроизведения может уступать традиционному синтезу или более совершенным нейросетевым моделям, например диффузионным.
- Сложность обучения: для обучения RAVE нужны знания машинного обучения и обработки аудио, а также мощное оборудование.
Развитие идей RAVE: Neutone Morpho и модель AFTER
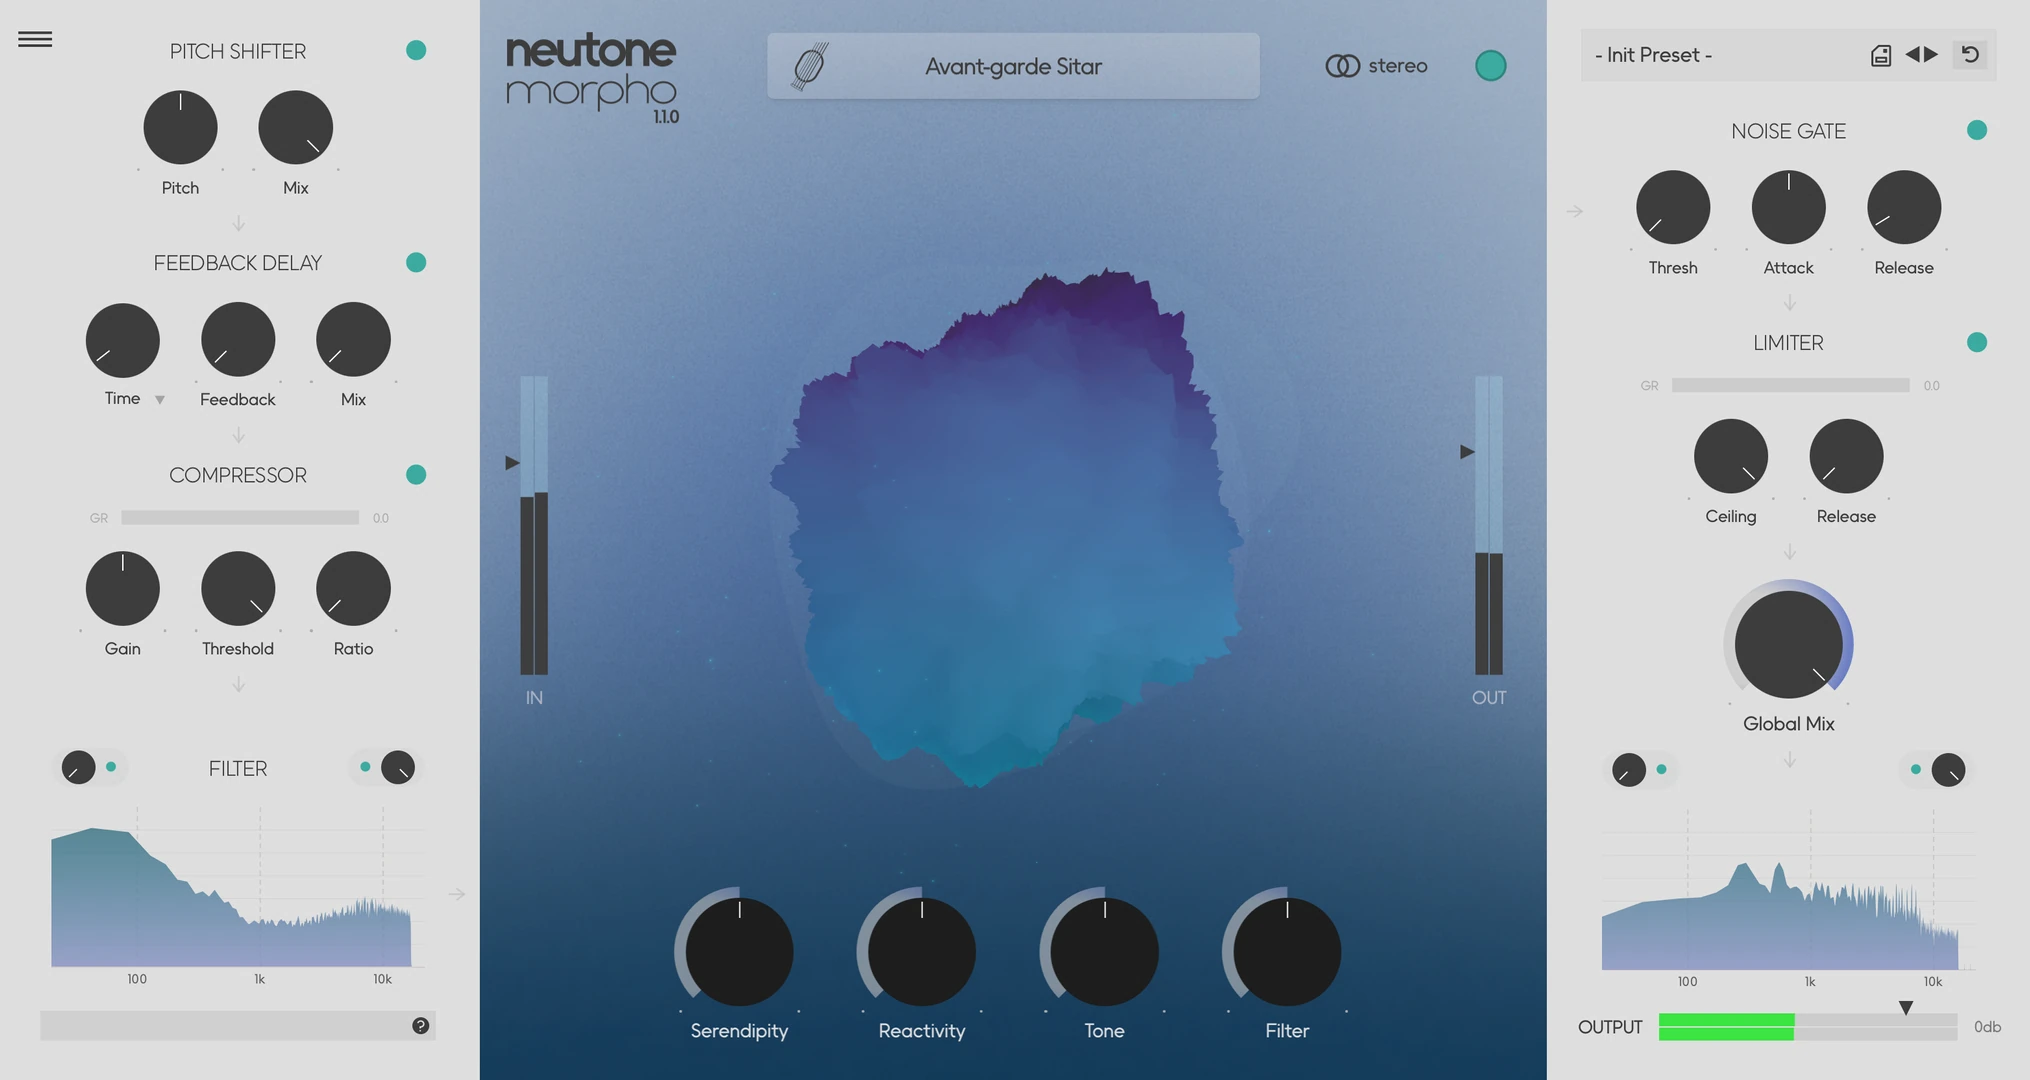
Neutone Morpho: коммерческое развитие RAVE (2024)
В феврале 2024 года команда Neutone под руководством Nao Tokui выпустила Morpho, коммерческого преемника своего бесплатного плагина FX. RAVE — исследовательская основа с открытым исходным кодом. Morpho объединяет похожую технологию в удобный продукт для музыкантов и продюсеров, жертвуя гибкостью.
Модель AFTER: диффузионная альтернатива от IRCAM
Та же команда IRCAM ACIDS выпустила AFTER (Audio Features Transfer and Exploration in Real-time), диффузионную модель. Её цель — дать больше возможностей настройки, с управлением тембром в реальном времени, как в традиционном синтезаторе.
Чтобы изменить стиль целой песни по текстовому запросу, а не отдельный звук, ИИ-ремикс сохраняет вокальный стем и заново генерирует инструментальную часть с Stable Audio 3.
FAQ по RAVE
Где скачать предобученные модели RAVE?
IRCAM публикует потоковые модели на официальной странице моделей RAVE. Neutone FX и RAVE VST тоже могут скачивать модели прямо из плагина. Перед использованием в коммерческом релизе проверьте лицензию каждой модели.
Сколько аудио нужно для обучения RAVE?
Планируйте от 2 до 3 часов чистого аудио из одного источника. RAVE усваивает всё в записях, включая шум и реверберацию помещения. Данные для DDSP и AFTER приведены в ответе на вопрос сколько данных нужно для обучения модели.
Можно ли обучать RAVE на Mac?
Это не лучший вариант. Руководство UAL Creative Computing Institute по RAVE требует GPU NVIDIA с CUDA и не менее 8 GB памяти и не рекомендует macOS. Вместо этого используйте облачный GPU или блокнот Colab от сообщества.
Почему моя модель RAVE щёлкает в Max?
Модель экспортирована без --streaming. Экспортируйте её снова с этим флагом.
RAVE или DDSP?
DDSP нужно всего около 10 минут аудио, но эта модель работает только с монофоническими инструментами с различимой высотой тона. RAVE обрабатывает любой звук, включая ударные, голоса и звуковые текстуры, но требует часов аудио и дней обучения.