Le modèle RAVE d'IRCAM : VST, modèles préentraînés et entraînement
Le modèle RAVE d'IRCAM est un modèle neuronal audio en temps réel qui transforme n'importe quel son en lui donnant le timbre sur lequel il a été entraîné. Vous pouvez jouer des modèles RAVE préentraînés dans votre logiciel audio avec Neutone FX ou RAVE VST, les charger dans Max/MSP ou Pure Data avec nn~ ou entraîner les vôtres avec le paquet Python acids-rave.
Utiliser RAVE : démarrage rapide
| Objectif | Outil | Ce qu'il vous faut |
|---|---|---|
| Jouer des modèles RAVE dans un logiciel audio | Neutone FX (VST/AU gratuit) | N'importe quel logiciel audio. Les modèles préentraînés se téléchargent dans le plugin. |
| Jouer des modèles RAVE dans un logiciel audio | RAVE VST (bêta) | Un téléchargement sur IRCAM Forum. Le dépôt des sources a été archivé en juin 2023, et sa version Windows est uniquement autonome. |
| Utiliser RAVE dans Max/MSP ou Pure Data | Objet externe nn~ | Max ou Pd et un fichier de modèle .ts |
| Télécharger des modèles préentraînés | Liste officielle des modèles RAVE | Des exports .ts en streaming pour nn~ |
| Entraîner votre propre modèle | acids-rave sur Python | Un GPU NVIDIA avec 5 à 32 Go de mémoire, quelques heures d'audio et environ 3 jours |
Pour installer nn~, téléchargez la dernière version et extrayez-la dans Documents/Max [your version]/Packages/ pour Max ou Documents/Pd/externals/ pour Pure Data. Placez vos modèles .ts dans le dossier nn_tilde/models.

Qu'est-ce que RAVE d'IRCAM pour la synthèse audio en temps réel ?
RAVE signifie Realtime Audio Variational autoEncoder, soit un autoencodeur variationnel audio en temps réel. Publié fin 2021 par des chercheurs d'IRCAM à Paris, il apprend à encoder les sons en une représentation compacte, puis à les décoder en audio. Imaginez apprendre à un ordinateur à esquisser ce qu'il entend, puis à redessiner cette esquisse sous la forme d'une imitation convaincante du son original.
Il le fait assez vite pour fonctionner en temps réel dans votre logiciel audio ou votre installation de scène.
Qui a créé RAVE et quand ?
RAVE a été développé par Antoine Caillon, qui travaille désormais chez Google DeepMind, et Philippe Esling, au sein de l'équipe ACIDS d'IRCAM à Paris.
L'équipe avait auparavant exploré le modèle DDSP (Differentiable Digital Signal Processing) de Google et l'avait présenté en mars 2021, mais souhaitait un modèle plus flexible, capable de traiter tout type de son et pas seulement les instruments de musique.
Son objectif était un modèle fonctionnant sur du matériel courant tout en produisant un audio de qualité studio. L'équipe l'a présenté dans son article de 2021, « RAVE : un autoencodeur variationnel pour une synthèse audio neuronale rapide et de haute qualité ».
Architecture RAVE : fonctionnement de cet autoencodeur variationnel
RAVE est un autoencodeur : un réseau neuronal qui apprend à compresser les données dans un « espace latent » compact, puis à les décompresser.
RAVE : entraînement en deux étapes
Étape 1 : apprentissage de la représentation
Étape 2 : affinage adversarial
Schéma d'entraînement adapté de l'article original sur RAVE. L'étape 1 entraîne l'encodeur et le décodeur avec une fonction de coût spectrale multibande. L'étape 2 fige l'encodeur, bloque les gradients à travers le code latent et entraîne le décodeur et le discriminateur. L'analyse et la synthèse PQMF restent fixes.
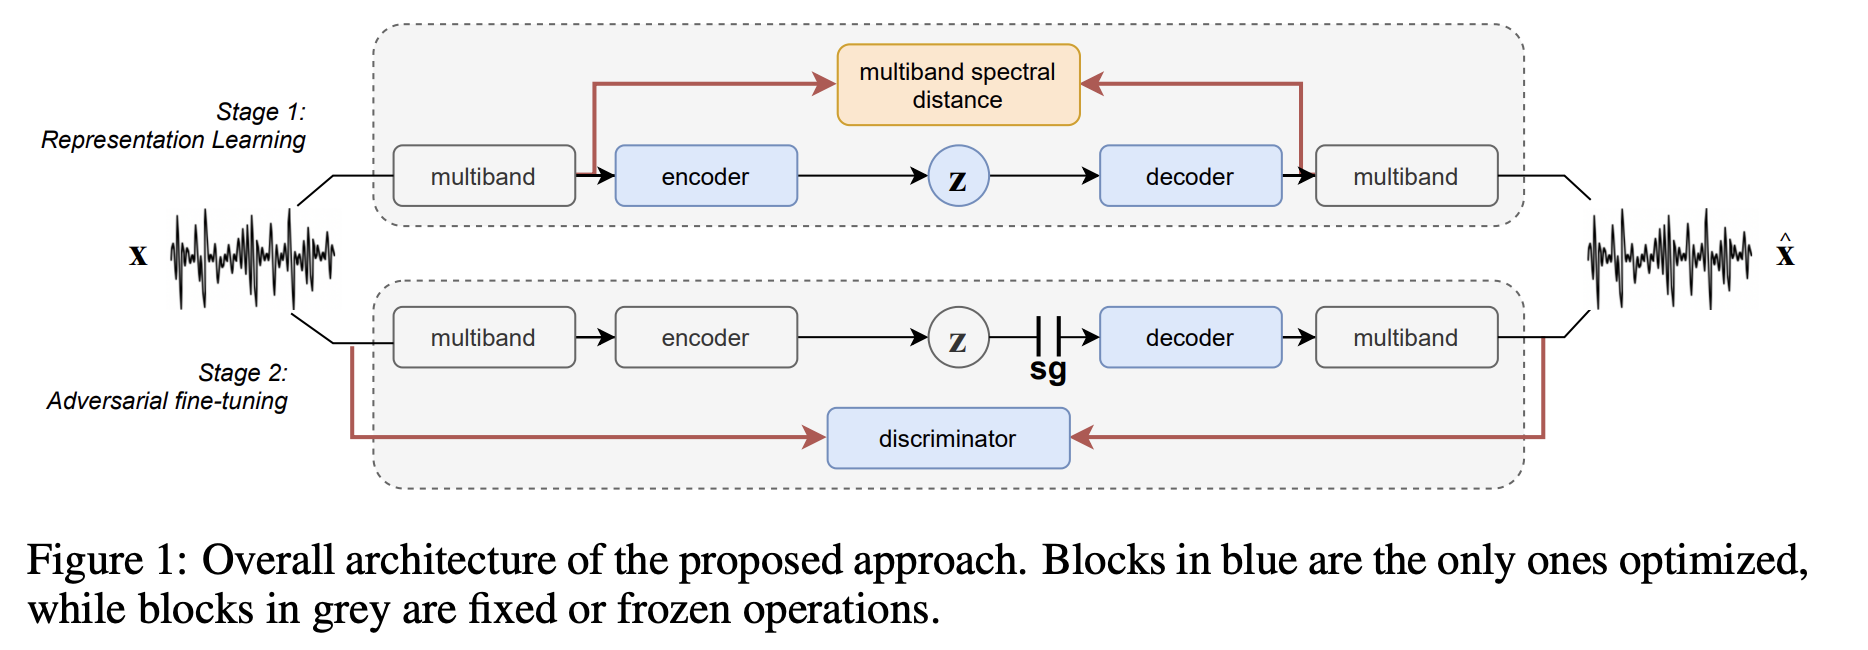
Figure originale: RAVE : entraînement en deux étapes.
Les deux étapes de l'entraînement de RAVE
Imaginez la formation d'un musicien en deux phases :
-
Phase 1 : apprendre à écouter (apprentissage de la représentation)
- L'encodeur apprend à condenser l'audio en un ensemble compact de nombres, l'espace latent
- Le décodeur apprend à reconstruire l'audio à partir de ces nombres
- L'entraînement utilise une fonction de coût spectrale qui compare le contenu fréquentiel de l'audio original et de l'audio reconstruit
-
Phase 2 : apprendre à improviser (affinage adversarial)
- L'encodeur est figé, car il sait déjà écouter
- Un réseau « discriminateur » est ajouté : un critique qui juge si l'audio reconstruit semble réel
- Le décodeur apprend de ces retours à produire un audio plus convaincant
Principaux composants techniques
- Filtres PQMF : RAVE divise l'audio en plusieurs sous-bandes de fréquences avant le traitement, ce qui améliore son efficacité
- Modes causal et non causal : le mode causal sacrifie une partie de la qualité pour réduire la latence sur scène
- Plusieurs configurations : de la légère « raspberry », qui fonctionne sur un Raspberry Pi, à « v3 », axée sur la qualité
Pour les détails de l'implémentation, consultez le dépôt GitHub officiel de RAVE, qui contient les fichiers de configuration et les définitions des modèles.

Entraîner des modèles RAVE sur vos propres données audio
Vous voulez un modèle qui transforme votre voix en saxophone ? Entraîner un modèle RAVE demande des connaissances en Python et un GPU. Le dépôt officiel de RAVE décrit la procédure complète.
Prérequis pour préparer le jeu de données
Pour entraîner un modèle RAVE, il vous faut :
- 2 à 3 heures d'audio propre, davantage si possible
- Des enregistrements de qualité studio, car RAVE apprend tout, y compris le bruit et la réverbération
- Des sons variés si vous souhaitez de la polyvalence
Pour constituer un jeu de données à partir de mixages complets, isolez d'abord l'instrument avec la séparation de pistes IA de haute qualité. Les artefacts de séparation se retrouvent aussi dans le modèle : utilisez donc les pistes les plus propres possibles. Le guide de séparation des pistes montre comment le faire dans Neural Analog.
Installer RAVE et préparer votre jeu de données
Installez d'abord PyTorch et TorchAudio pour votre GPU, puis RAVE. Vous avez aussi besoin de FFmpeg ; dans un environnement conda, installez-le avec conda :
pip install acids-rave
conda install ffmpeg
Le prétraitement convertit vos fichiers audio dans le format de jeu de données de RAVE :
rave preprocess --input_path /audio/folder --output_path /dataset/path --channels 1Utilisez --channels 1 pour le mono ou --channels 2 pour la stéréo. Ajoutez --lazy pour entraîner directement sur des fichiers compressés comme les MP3, mais attendez-vous à une charge CPU bien plus élevée pendant l'entraînement. Tous les paramètres figurent dans la documentation RAVE sur la préparation du jeu de données.
Procédure d'entraînement et configurations RAVE
Lancez l'entraînement avec un nom de configuration :
rave train --config v2 --db_path /dataset/path --out_path /model/out --name my_model --channels 1Choisissez la configuration adaptée à votre GPU. Les minimums de mémoire GPU proviennent du README officiel :
| Configuration | Mémoire GPU min. | Usage |
|---|---|---|
raspberry | 5 Go | Modèle léger pour le temps réel sur un Raspberry Pi 4 |
onnx | 6 Go | v1 sans bruit pour l'export ONNX |
v1 | 8 Go | Le modèle continu original |
v2_small | 8 Go | Transfert de timbre sur des sons stationnaires |
v2 | 16 Go | Le modèle continu amélioré et un bon choix par défaut |
discrete | 18 Go | Un modèle discret similaire à SoundStream ou EnCodec |
v3 | 32 Go | La meilleure qualité, avec transfert de style (AdaIN) |
Vous pouvez combiner une configuration avec des options comme causal pour réduire la latence ou noise. Un notebook Colab communautaire pour RAVEv2, mentionné dans le README, permet de s'entraîner sur les GPU de Google si vous n'en avez pas.
À quoi s'attendre pendant l'entraînement :
- Phase 1 (~1M étapes) : la qualité audio est d'abord médiocre, puis s'améliore progressivement
- Phase 2 (entraînement adversarial) : la qualité s'améliore nettement
- Durée totale : environ 3 jours sur un GPU RTX 3080
Des notebooks d'entraînement RAVE proposés par la communauté expliquent la procédure étape par étape.
Exporter les modèles RAVE pour le temps réel
L'export est important pour le temps réel. Utilisez l'option --streaming pour activer les convolutions mises en cache, ce qui évite les artefacts de clics :
rave export --run /path/to/your/run --streamingLe résultat est un fichier TorchScript .ts que nn~ peut charger. Pour les paramètres d'export et le dépannage, consultez la documentation d'export RAVE.
Inférence RAVE et possibilités d'utilisation en temps réel
Vous ne voulez pas attendre 3 jours d'entraînement ? Vous pouvez essayer des modèles RAVE préentraînés dans plusieurs outils. Ils chargent aussi les modèles que vous entraînez vous-même, et la FAQ sur l'utilisation d'un modèle entraîné dans votre logiciel audio indique le plugin adapté à chaque type de modèle.
Neutone FX : plugin VST/AU gratuit pour les modèles RAVE
Neutone FX est un plugin VST/AU gratuit qui héberge des modèles RAVE. C'est le plugin Neutone original de 2022, désormais maintenu comme plateforme ouverte. Installez-le pour charger une collection de modèles préentraînés directement dans votre logiciel audio (Ableton, Logic, Reaper et d'autres).

RAVE VST d'IRCAM, en bêta et archivé
IRCAM a aussi publié son propre RAVE VST, avec des versions VST, AU et autonomes. Il possède deux modes : reconstruction, qui traite l'audio provenant de votre logiciel audio, et prior, qui génère du son en parcourant l'espace latent de lui-même. Son Model Explorer télécharge des modèles préentraînés, et vous pouvez importer les vôtres si vous les exportez avec --stereo true.
Le dépôt rave_vst a été archivé en juin 2023 : ne vous attendez donc pas à des correctifs. Sous Windows, seule une version autonome expérimentale existe, et les utilisateurs de Mac M1 doivent compiler eux-mêmes le logiciel. Les développeurs recommandent plutôt nn~ pour le temps réel.
Intégration à Max/MSP et Pure Data avec nn~
Pour la scène, l'objet externe nn~ charge des modèles RAVE directement dans Max/MSP et Pure Data. Il permet de manipuler directement l'espace latent et d'utiliser Adaptive Instance Normalization pour le transfert de style. Il fonctionne aussi sur des plateformes embarquées comme le Raspberry Pi pour des installations portables. Les mêmes cartes exécutent des plugins d'amplis de guitare neuronaux comme ToobAmp et Stompbox. Si votre carte est un NVIDIA Jetson Nano, elle n'a pas de sortie audio analogique : ajoutez d'abord une carte son I2S comme Raspiaudio Audio+.
Limites de performances et précautions techniques de RAVE
Prenez connaissance de ces limites avant de compter sur RAVE :
- Latence : même en mode causal, attendez-vous à un délai perceptible, y compris sur un Apple Silicon haut de gamme. Cela convient en studio, mais testez soigneusement RAVE avant de l'utiliser comme instrument sur scène.
- Accélération GPU : le modèle utilise de nombreuses petites convolutions limitées par les accès mémoire plutôt que par la puissance de calcul et se parallélise donc mal. Pour le temps réel, le surcoût du GPU dépasse souvent le bénéfice, sauf en traitement par lot.
- Qualité audio : RAVE peut impressionner, mais sa fidélité n'égale pas nécessairement celle de la synthèse traditionnelle ou de modèles neuronaux plus avancés, comme ceux fondés sur la diffusion.
- Entraînement difficile : entraîner un modèle RAVE demande une expertise en apprentissage automatique et en traitement audio, ainsi qu'un matériel puissant.
Après RAVE : Neutone Morpho et le modèle AFTER
Neutone Morpho : évolution commerciale de RAVE en 2024
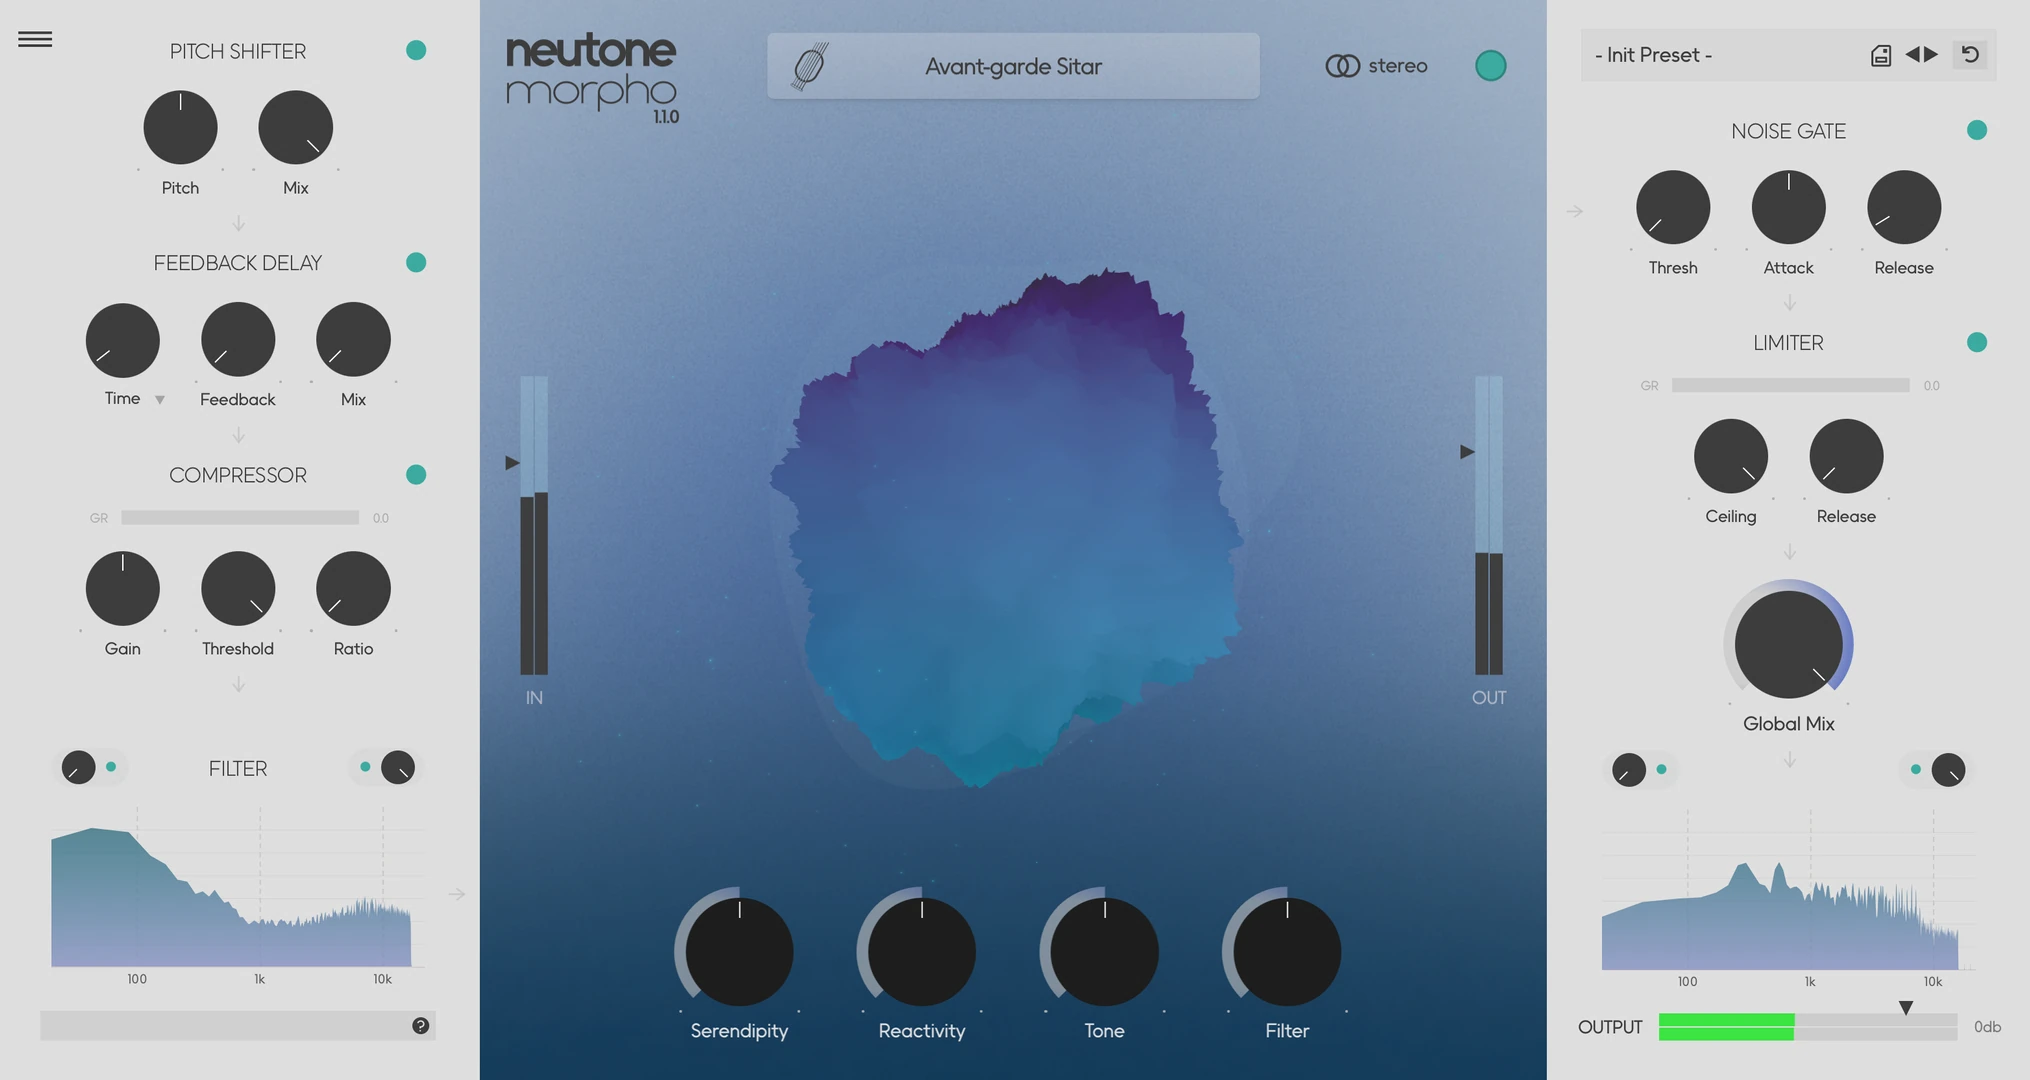
En février 2024, l'équipe Neutone dirigée par Nao Tokui a publié Morpho, un successeur commercial de son plugin FX gratuit. RAVE est le moteur open source développé pour la recherche. Morpho intègre une technologie similaire dans un produit abouti pour les musiciens et les producteurs, au prix d'une flexibilité moindre.
Le modèle AFTER : une alternative par diffusion d'IRCAM
La même équipe IRCAM ACIDS a aussi publié AFTER (Audio Features Transfer and Exploration in Real-time), un modèle fondé sur la diffusion. Il vise à offrir davantage de réglages, avec un contrôle du timbre en temps réel comme un synthétiseur traditionnel.
Pour changer le style d'un morceau entier à partir d'un prompt textuel plutôt que d'un seul son, le remix IA conserve la piste vocale et régénère l'instrumental avec Stable Audio 3.
FAQ RAVE
Où télécharger des modèles RAVE préentraînés ?
IRCAM répertorie les modèles en streaming sur la page officielle des modèles RAVE. Neutone FX et RAVE VST peuvent aussi télécharger les modèles depuis le plugin. Vérifiez la licence de chaque modèle avant de l'utiliser dans une sortie commerciale.
De combien d'audio ai-je besoin pour entraîner RAVE ?
Prévoyez 2 à 3 heures d'audio propre provenant d'une seule source. RAVE apprend tout dans les enregistrements, y compris le bruit et la réverbération de la pièce. Pour les quantités nécessaires à DDSP et AFTER, consultez combien de données il faut pour entraîner un modèle.
Puis-je entraîner RAVE sur un Mac ?
Ce n'est pas un bon choix. Le guide RAVE de l'UAL Creative Computing Institute demande un GPU NVIDIA compatible CUDA avec au moins 8 Go de mémoire et déconseille macOS. Utilisez plutôt un GPU dans le cloud ou le notebook Colab communautaire.
Pourquoi mon modèle RAVE produit-il des clics dans Max ?
Le modèle a été exporté sans --streaming. Exportez-le à nouveau avec cette option.
RAVE ou DDSP ?
DDSP ne demande qu'environ 10 minutes d'audio, mais ne modélise que des instruments monophoniques à hauteur définie. RAVE traite tous les sons, y compris les batteries, les voix et les textures, mais demande des heures d'audio et des jours d'entraînement.