Guide DDSP : VST Magenta DDSP, entraînement et fonctionnement
DDSP (traitement numérique du signal différentiable, pour Differentiable Digital Signal Processing) est la bibliothèque open source de Google Magenta qui permet à un réseau neuronal de piloter des générateurs sonores classiques : oscillateurs, bruit filtré et réverbération. Magenta a archivé le VST DDSP en 2024, mais ce plugin gratuit peut toujours être téléchargé et utilisé sous Windows et macOS. Vous pouvez aussi entraîner votre propre modèle d'instrument dans un notebook Google Colab gratuit.
Ce guide commence par ces deux étapes pratiques. Il explique ensuite le fonctionnement de DDSP, ses limites et les modèles plus récents qui lui ont succédé.
Utiliser DDSP aujourd'hui : démarrage rapide
Télécharger et installer le VST DDSP
- Téléchargez le plugin pour macOS ou Windows. Les deux liens proviennent du dépôt officiel du VST DDSP.
- Décompressez le fichier. Il contient deux plugins : DDSP Effect, qui transforme l'audio entrant, comme votre voix, en son d'instrument, et DDSP Synth, que vous jouez en MIDI.
- Sous macOS, copiez-les dans
/Library/Audio/Plug-Ins/Components(AU) et/Library/Audio/Plug-Ins/VST3. Sous Windows, copiez les fichiers VST3 dansC:\Program Files\Common Files\VST3. - Relancez l'analyse des plugins dans votre DAW.
Il n'existe pas de version officielle pour Linux. Pour écouter DDSP sans rien installer, essayez la démo web de Tone Transfer.
Entraîner votre propre instrument DDSP
Le notebook d'entraînement du VST DDSP de Magenta s'exécute dans Google Colab, sans GPU local :
- Placez au moins 10 minutes d'audio
.wavou.mp3dans un dossier Google Drive. Utilisez de l'audio monophonique, une seule note à la fois, issu d'une même session d'enregistrement, avec le même micro et dans la même pièce. - Ouvrez le notebook, exécutez la cellule d'installation, qui prend environ 5 minutes, puis lancez la cellule d'entraînement et sélectionnez votre dossier.
- Patientez. L'entraînement prend environ 2 à 3 heures sur Colab gratuit et moins d'une heure sur Colab Pro+. Si Colab se déconnecte, relancez la cellule avec le même dossier pour reprendre l'entraînement.
- Décompressez le dossier du modèle téléchargé dans le dossier des modèles du plugin. Sur Mac, il se trouve dans
~/Documents/Magenta/DDSP/Modelset vous pouvez aussi l'ouvrir depuis le plugin.
Le notebook indique que de bons résultats apparaissent généralement après 30 000 à 50 000 étapes d'entraînement. Avec trop peu d'étapes, le son manque de caractère ; avec trop d'étapes, il peut devenir saccadé et présenter de fortes variations de volume.
Histoire et évolution : de Magenta aux plugins actuels
Le laboratoire de recherche Magenta (2016-2024)
Google a lancé Magenta en 2016 comme projet de recherche open source sur l'apprentissage automatique appliqué à la musique et à l'art. Il a publié de nombreux outils de génération musicale, mais la plupart de ses projets avaient été archivés en 2024.
Open NSynth Super (2017)
Avant DDSP, Magenta a présenté Open NSynth Super, un instrument matériel fondé sur NSynth. Le jeu de données NSynth contient environ 305 000 échantillons de notes isolées issus de 1 006 instruments. Construit autour d'un Raspberry Pi et d'un circuit imprimé personnalisé, l'appareil permettait de faire évoluer le son entre plusieurs instruments en temps réel.
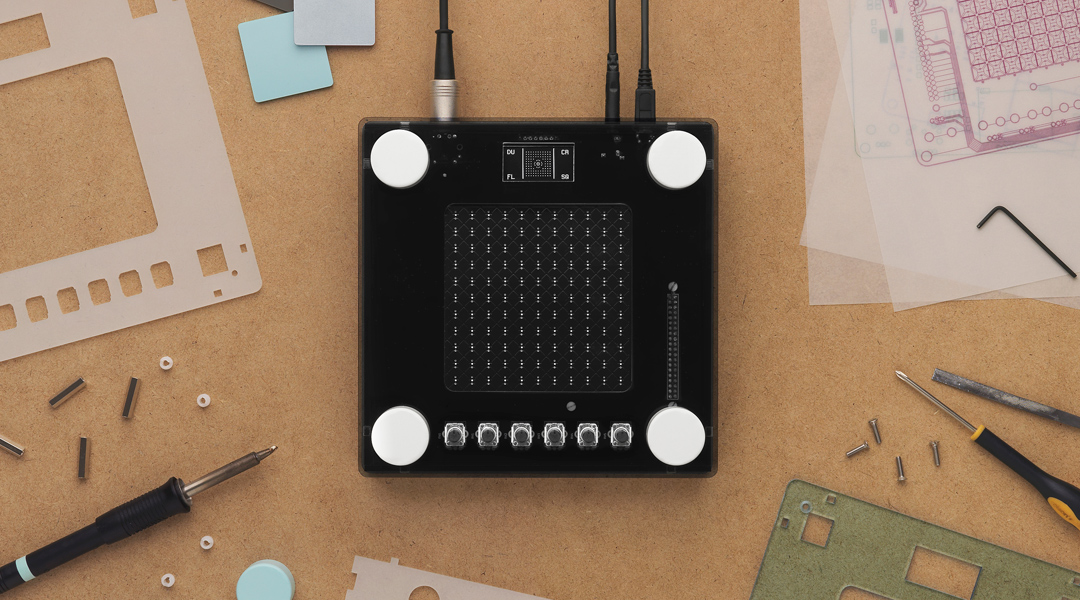
Le modèle NSynth, un autoencodeur de type WaveNet, était limité à de l'audio 16 bits/16 kHz en raison de son coût de calcul, ce qui donne au résultat un caractère lo-fi marqué. L'ingénieur du son Joe Boston le décrivait comme « granuleux », tout en lui trouvant des usages créatifs avec des effets externes. Le projet matériel a été archivé en août 2025.
DDSP et Tone Transfer (2020)
En 2020, Magenta a publié la bibliothèque DDSP et son article à l'ICLR, qui présentait des versions différentiables de modules courants de traitement du signal. La démo web de Tone Transfer permettait de transformer des enregistrements, par exemple du chant, en violon, saxophone, trompette ou flûte.
Les modèles étaient des autoencodeurs fondés sur des RNN, entraînés sur environ 10 minutes d'audio monophonique par instrument. La démo fonctionnait, mais la sortie à 16 kHz et la modélisation limitée des articulations en restreignaient les possibilités.
MIDI DDSP et le plugin VST (2022-2024)
Magenta a étendu DDSP avec MIDI DDSP en janvier 2022. Il synthétise directement le son d'un instrument à partir de séquences MIDI monophoniques. Pour jouer des échantillons enregistrés en MIDI plutôt qu'un modèle neuronal, chargez un instrument SFZ dans le lecteur gratuit sforzando.
En juin 2022, Magenta a publié le plugin VST DDSP pour le transfert de timbre en temps réel dans un DAW. Les deux projets ont été archivés en 2024 : MIDI DDSP en février et le VST en octobre.

Le plugin audio MAWF (2023)
Hanoi Hantrakul (yaboihanoi), ancien responsable technique de Tone Transfer et chez ByteDance depuis 2020, a lancé MAWF en 2023. Ce plugin VST/AU gratuit réalise de la synthèse audio neuronale en temps réel à 48 kHz, supprimant la limite de 16 kHz des premières implémentations de DDSP.

Comment fonctionne DDSP ? Les autoencodeurs rencontrent le DSP
DDSP est un autoencodeur dont le décodeur pilote des composants DSP modulaires au lieu de générer directement la forme d'onde.
Architecture de l'autoencodeur DDSP
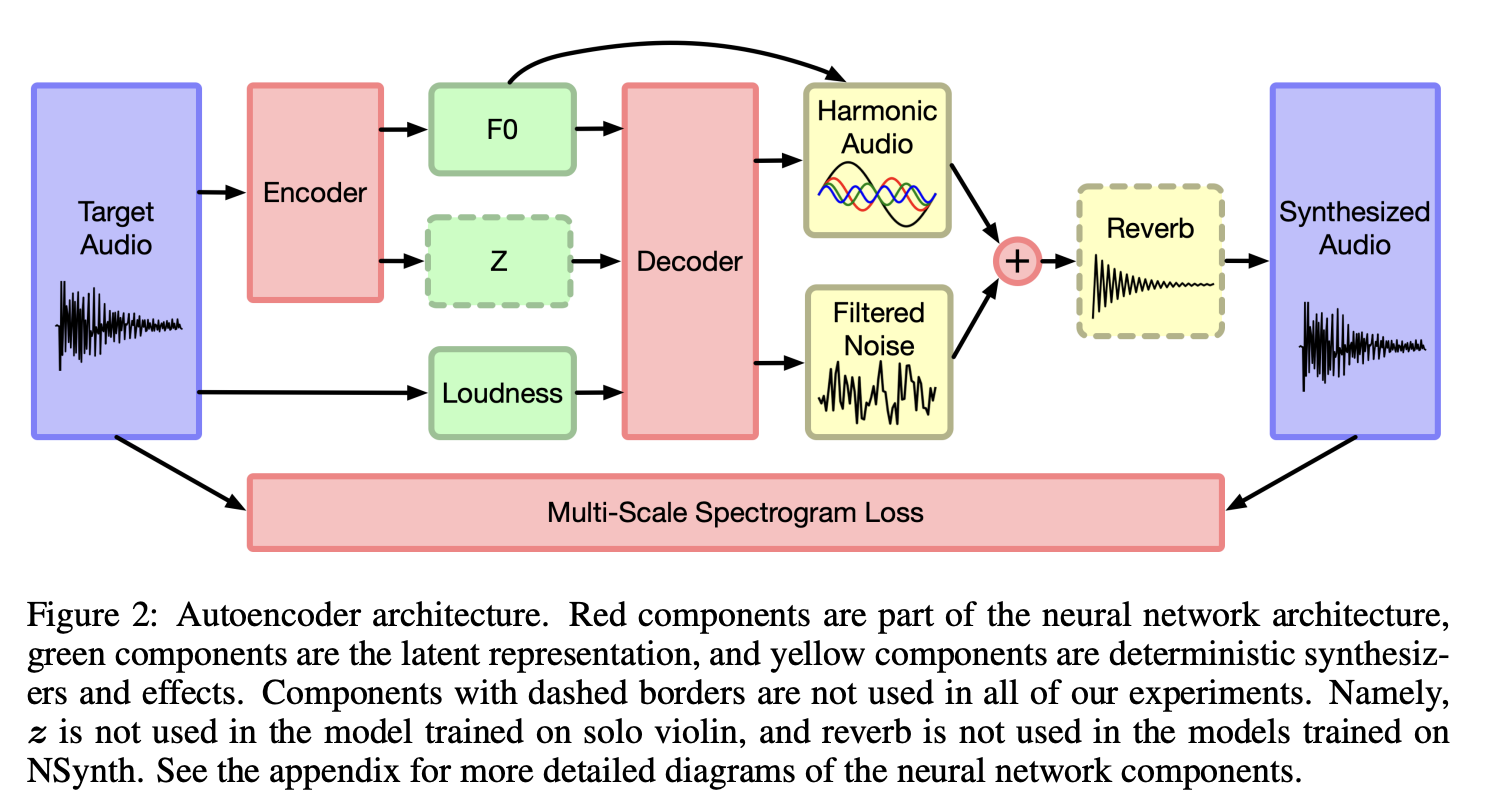
Figure originale: Architecture de l'autoencodeur DDSP.
Encodeur
L'encodeur transforme l'audio d'entrée en deux courbes de contrôle : la fréquence fondamentale (f0, la hauteur du son), estimée avec un détecteur de hauteur CREPE préentraîné, et la sonie, calculée directement à partir du signal. Un encodeur résiduel facultatif, un GRU appliqué aux MFCC, ajoute un vecteur latent pour les détails de timbre que la hauteur et la sonie ne capturent pas. Ces signaux de faible dimension décrivent l'interprétation.
Décodeur et modules de synthèse
Un décodeur récurrent (GRU) transforme les signaux de contrôle en paramètres destinés à trois composants DSP :
- Synthétiseur additif harmonique : génère jusqu'à 100 partiels sinusoïdaux à des multiples de la fréquence fondamentale pour la partie du son qui possède une hauteur définie.
- Synthétiseur de bruit filtré : façonne un bruit blanc avec des filtres FIR variant dans le temps pour modéliser le souffle et le bruit de l'archet.
- Réverbération différentiable : ajoute l'acoustique d'une pièce à l'aide d'une réponse impulsionnelle apprise.
Chaque composant est différentiable : le modèle entier s'entraîne donc de bout en bout avec une perte spectrale multi-échelle. Il prédit des centaines de paramètres de synthèse par trame au lieu de générer l'audio échantillon par échantillon.
Entraîner des modèles DDSP pour la recherche
Pour un modèle destiné au VST DDSP, utilisez le notebook d'entraînement du VST DDSP décrit dans le démarrage rapide ci-dessus. Pour modifier l'architecture ou la fonction de perte, partez des tutoriels Colab de la bibliothèque. Ils nécessitent des bases en Python et couvrent le prétraitement, la configuration et l'entraînement sur un GPU Colab.
Plugins DDSP utilisables en temps réel
Les projets officiels de Magenta sont archivés, mais ces outils permettent toujours d'utiliser DDSP dans un DAW :
1. VST Magenta DDSP (archivé)
Le VST DDSP officiel fonctionne toujours pour l'expérimentation ; consultez le démarrage rapide ci-dessus pour l'installer. Il comprend cinq modèles d'instruments et accepte des entrées MIDI et audio. Des utilisateurs signalent une forte réverbération en sortie, qui semble masquer les artefacts.
2. La plateforme Neutone FX
Neutone FX propose un plugin gratuit qui héberge des modèles entraînés par la communauté, dont des réseaux de transfert de timbre fondés sur DDSP. Les producteurs peuvent ainsi accéder à des dizaines de modèles en plus des instruments Magenta d'origine.

3. MAWF de yaboihanoi (recommandé)
Le plugin MAWF réalise la synthèse DDSP à 48 kHz dans votre DAW. Il comprend plusieurs modèles d'instruments et constitue l'implémentation de DDSP la plus aboutie disponible.

Le site de téléchargement de MAWF est toutefois inaccessible depuis novembre 2025. Je mettrai cet article à jour si je trouve une autre source pour le plugin.
Quelles sont les limites de DDSP ?
Les limites de DDSP viennent de son architecture et de son approche de la synthèse :
- Uniquement monophonique : les modèles DDSP ne peuvent pas générer d'audio polyphonique. Ils ont été entraînés sur des enregistrements monophoniques et le synthétiseur harmonique suppose une seule fréquence fondamentale à chaque pas de temps.
- Qualité audio : les modèles MAWF à 48 kHz sonnent mieux, mais les premières implémentations à 16 kHz présentent des artefacts métalliques et peu de contenu dans les hautes fréquences. Un modèle de super-résolution audio peut régénérer les aigus manquants d'anciens rendus : voyez comment installer et exécuter AudioSR depuis GitHub, ou comment UniverSR a restauré à 48 kHz les effets sonores à 22 kHz de RPG Maker.
- Parallélisme limité sur GPU : les couches récurrentes traitent les trames les unes après les autres. Le modèle ne peut donc pas paralléliser le traitement dans le temps sur un GPU comme les modèles convolutionnels.
Après DDSP : RAVE, DDSP-CNN-Tiny et AFTER
RAVE (2021)
RAVE utilise des CNN causaux au lieu de RNN, ce qui apporte un entraînement plus rapide et une synthèse à 48 kHz, ainsi qu'une meilleure modélisation du timbre. C'est un autoencodeur variationnel affiné par un entraînement adversarial avec discriminateur, qui atteint une meilleure fidélité avec une quantité de données similaire.
DDSP-CNN-Tiny (2022)
DDSP-CNN-Tiny remplace les RNN de DDSP par des CNN légers, ce qui réduit la taille du modèle et accélère l'inférence. La qualité audio reste comparable et le modèle fonctionne en temps réel sur CPU. De petits réseaux exécutés sur CPU sont aussi au cœur des plugins neuronaux gratuits d'ampli guitare comme NAM et AIDA-X. Václav Volhejn l'a développé pour sa thèse à l'ETH Zurich ; sa thèse sur DDSP en temps réel est une excellente lecture technique.
AFTER (2024)
Le modèle AFTER utilise la diffusion latente au-dessus d'un codec audio neuronal pour obtenir une synthèse de qualité studio. Il demande davantage de calcul que DDSP, mais son transfert de timbre produit beaucoup moins d'artefacts, ce qui le rend plus adapté à la production professionnelle.
FAQ DDSP
Magenta DDSP est-il toujours maintenu ?
En partie. La bibliothèque ddsp n'est pas archivée et reçoit encore des commits. Magenta a archivé MIDI DDSP en février 2024 et le VST DDSP en octobre 2024 ; le plugin ne reçoit donc plus de mises à jour. Les téléchargements du plugin et le notebook d'entraînement fonctionnaient encore lors de la mise à jour de ce guide en octobre 2026.
Le VST DDSP fonctionne-t-il sous Linux ?
Il n'existe pas de version officielle pour Linux. Vous devrez le compiler vous-même à partir du code source.
DDSP peut-il jouer des accords ?
Non. Les modèles DDSP sont monophoniques : ils suivent une seule hauteur à la fois. Pour un contrôle MIDI polyphonique, consultez AFTER.
DDSP ou RAVE : lequel entraîner ?
Choisissez DDSP pour un instrument à hauteur définie si vous ne disposez que d'environ 10 minutes d'audio et d'un GPU Colab gratuit. Choisissez RAVE pour tout type de son, y compris les percussions, les textures et les voix. RAVE demande quelques heures d'audio et plusieurs jours d'entraînement sur GPU. La FAQ compare les quantités d'audio d'entraînement nécessaires à DDSP, RAVE et AFTER et explique quel plugin permet de jouer chaque modèle entraîné dans votre DAW.