Modèle AFTER d'IRCAM : installation, modèles préentraînés et entraînement
Le modèle AFTER d'IRCAM est un modèle de synthèse audio neuronale que les musiciens peuvent contrôler en temps réel et de manière polyphonique avec des entrées familières : des notes MIDI ou la hauteur et le niveau sonore d'un autre signal audio.
Pour l'essayer, téléchargez les modèles préentraînés et les patches Max depuis le dossier partagé d'IRCAM, installez l'objet externe nn~ et ouvrez le patch dans Max ou les périphériques Max for Live dans Ableton Live. Pour entraîner votre propre modèle, installez le package Python depuis GitHub et suivez les étapes ci-dessous.

Qu'est-ce que le modèle AFTER ?
AFTER signifie Audio Features Transfer and Exploration in Real-time. Il sépare l'expression musicale (structure) de l'identité sonore (timbre), afin que vous puissiez modifier chacune indépendamment.
Les modèles antérieurs de type « boîte noire » génèrent du son à partir de coordonnées latentes abstraites, difficiles à piloter. AFTER utilise plutôt des contrôles explicites. Vous pouvez appliquer l'interprétation d'un instrument, par exemple la courbe de hauteur d'une voix, au timbre appris d'un autre, ou jouer le modèle entièrement en MIDI. Contrairement à DDSP, qui ne suit qu'une seule hauteur à la fois, AFTER peut jouer des accords MIDI lorsqu'il a été entraîné sur des données polyphoniques.
Pour changer le style d'un morceau terminé plutôt que d'une seule interprétation, le remix IA conserve la piste vocale et régénère l'instrumental à partir d'un prompt textuel.
Histoire et origine : l'équipe ACIDS
AFTER est issu des recherches doctorales de Nils Demerlé à IRCAM (Institut de recherche et coordination acoustique/musique), à Paris. Il a travaillé dans le groupe ACIDS avec Ninon Devis, Philippe Esling, Guillaume Doras et David Genova pour résoudre une limite des autoencodeurs variationnels (VAE).
Les VAE, comme le modèle RAVE, compressent bien l'audio, mais la hauteur et le timbre se retrouvent souvent mêlés dans les mêmes dimensions latentes (« enchevêtrement »), ce qui rend leur contrôle séparé difficile. L'équipe a présenté sa solution dans l'article « Combiner le contrôle audio et le transfert de style par diffusion latente » en août 2024. L'objectif était d'apporter la qualité audio des modèles de diffusion aux performances musicales en direct.

Comment fonctionne AFTER ? Une architecture à diffusion latente
AFTER utilise la diffusion latente conditionnelle. Au lieu de générer les échantillons audio bruts un par un, ce qui est lent, il travaille dans un espace « latent » compressé fourni par un autoencodeur préentraîné.

Structure et timbre
AFTER divise le son en deux flux :
- La structure (caractéristiques locales) : des contrôles explicites qui varient dans le temps.
- Entrée audio : hauteur (f_0) et niveau sonore (pondéré A).
- Entrée MIDI : représentation polyphonique en piano roll.
- Le timbre (caractéristiques globales) : un vecteur de représentation appris, fixe dans le temps, qui décrit l'identité du son, par exemple « violoncelle » ou « guitare saturée ».
Étapes du traitement
- Compression (le codec) : un codec audio neuronal, généralement un autoencodeur RAVE, compresse l'audio entrant en vecteurs latents de faible dimension.
- Conditionnement : le système extrait les courbes de hauteur et de niveau sonore avec des outils comme CREPE ou Basic Pitch pour construire le conditionnement de structure.
- Diffusion latente : un U-Net conditionnel prédit les représentations latentes audio à partir de la structure et du timbre cible.
- Décodage : le codec audio décode les représentations latentes prédites pour retrouver des formes d'onde brutes.
Comment entraîner des modèles AFTER
L'entraînement comporte trois étapes. Le dépôt GitHub d'AFTER contient les scripts complets. Installez AFTER dans un environnement Python 3.12 :
git clone https://github.com/acids-ircam/AFTER.git
cd AFTER/
pip install -e .1. Préparation du jeu de données
Il vous faut un jeu de données audio, généralement de plus d'une heure pour obtenir de bons résultats (quantité de données nécessaire pour DDSP, RAVE et AFTER). Si l'instrument recherché est mélangé à d'autres, isolez-le d'abord avec la séparation des pistes IA de haute qualité.
- Prétraitement : le script
after prepare_datasetanalyse l'audio et extrait les caractéristiques de référence. - Outils : il utilise Basic Pitch de Spotify pour la transcription MIDI et des outils d'extraction du niveau sonore pour l'audio. Les données sont stockées dans une base LMDB pour un accès rapide pendant l'entraînement.
- Vérifiez d'abord la transcription : pour entendre comment votre contenu se transforme en notes avant un long entraînement, essayez la conversion audio en MIDI sur un court extrait. Le guide audio vers MIDI présente les étapes dans Studio.
Préparez d'abord un jeu de données de formes d'onde pour l'autoencodeur :
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_audio --save_waveform True2. Entraînement de l'autoencodeur (le codec)
Avant d'entraîner le modèle de diffusion, vous avez besoin d'un « codec » qui compresse l'audio.
- Option A : entraînez un nouvel autoencodeur causal avec une perte spectrale multi-échelle et une perte charnière adversariale.
- Option B : utilisez un codec préentraîné du dossier partagé d'IRCAM ou un modèle RAVE comme moteur. C'est plus rapide si un bon modèle pour votre type d'audio existe déjà.
Pour l'option A, entraînez et exportez l'autoencodeur :
after train_autoencoder --name AE_model_name --db_path /dataset/path_audio --config AE_4096 --gpu 0
after export_autoencoder --model_path autoencoder_runs/AE_model_name
L'export crée export.ts pour l'utilisation hors temps réel et export_stream.ts pour le temps réel.
3. Entraînement du modèle de diffusion
À cette étape, le modèle apprend à relier les signaux de contrôle au son.
- Objectif : le modèle minimise une erreur de prédiction du bruit (MSE). Autrement dit, il apprend à retirer le bruit progressivement jusqu'à ce qu'il ne reste que le son cible.
- Désenchevêtrement : un critère adversarial pénalise le modèle lorsque l'encodeur de timbre capte des informations de hauteur. Cela maintient l'indépendance des deux contrôles.
Encodez votre audio avec le codec, puis entraînez le modèle de diffusion :
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_latent --emb_model_path AE_model_run/export.ts
after train --name diff_model_name --db_path /dataset/path_latent --emb_model_path AE_model_run/export.ts --config audio
4. Export pour l'utilisation en temps réel
Exportez avec after export pour le périphérique Audio-to-Audio, ou after export_midi pour le périphérique MIDI-to-Audio :
after export --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
after export_midi --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
L'export produit aussi une carte latente .png. Le README demande de la conserver avec le fichier .ts.
Comment utiliser AFTER en temps réel : Max for Live et Max/MSP
Intégration Max for Live (M4L)
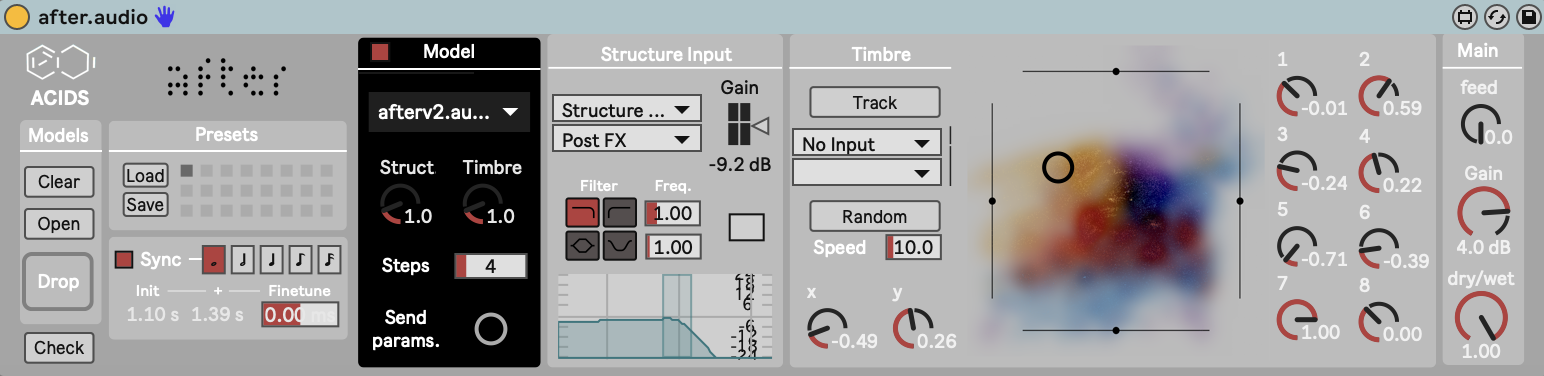
Pour les utilisateurs d'Ableton Live, AFTER propose deux périphériques Max for Live qui relient Live au modèle.
Le premier est Audio-to-Audio. Il utilise une entrée sidechain, par exemple votre voix, pour piloter la hauteur et le niveau sonore du modèle neuronal.
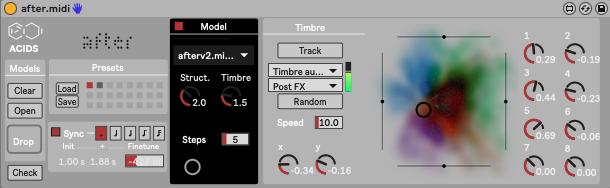
Le second est MIDI-to-Audio. Il transmet les notes MIDI au modèle sous forme d'une structure en piano roll. Grâce à l'architecture à diffusion latente, il prend en charge la polyphonie lorsque le modèle a été entraîné sur des données polyphoniques. Pour jouer le même MIDI avec des samples enregistrés à la place, chargez un instrument SFZ dans sforzando.
Max/MSP et nn~
Pour les développeurs, AFTER fonctionne dans Max/MSP via l'objet externe nn~, qui charge les modèles TorchScript exportés (fichiers .ts) directement dans un patch.
Quelle est la latence d'AFTER ?
AFTER se comporte différemment des modèles à propagation directe en une seule passe, comme RAVE, car la diffusion nécessite plusieurs étapes.
Latence : chaque étape de débruitage ajoute des calculs. L'implémentation en temps réel présente donc généralement une latence de 200 à 500 ms. AFTER génère l'audio à la volée, mais jouer avec donne davantage l'impression d'un délai prévisible que d'un instrument instantané. En live, certains artistes préfèrent une approche avec « boucleur » : AFTER rejoue chaque phrase au cycle suivant de la boucle. Pour un instrument qui répond instantanément, les petits réseaux comme ceux des plugins gratuits d'amplis de guitare neuronaux conviennent mieux.
Utilisation du GPU : l'inférence passe par nn~, qui prend en charge l'accélération GPU, mais les utilisateurs constatent peu de différence en pratique. Comme la diffusion est itérative, la consommation CPU reste élevée par rapport au DSP standard.
FAQ AFTER
Existe-t-il un plugin VST AFTER ?
Non. Le dépôt officiel propose des périphériques Max for Live pour Ableton Live et des patches Max qui fonctionnent avec nn~. Il ne mentionne aucun plugin VST ou AU.
Où trouver les modèles AFTER préentraînés ?
IRCAM héberge des modèles et codecs préentraînés ainsi que des patches Max dans un dossier partagé lié depuis le README d'AFTER.
AFTER est-il la même chose qu'IRCAMAX ?
Non. IRCAMAX est un pack commercial de périphériques Max for Live d'IRCAM, vendu par Ableton. AFTER est un modèle de recherche de l'équipe ACIDS d'IRCAM dont le code est public sur GitHub.
AFTER ou RAVE ?
RAVE est un modèle en une seule passe avec une latence plus faible, mais ses contrôles sont des dimensions latentes abstraites. AFTER ajoute des contrôles explicites de hauteur, de niveau sonore et de MIDI polyphonique à un codec, au prix d'une latence et d'une charge CPU plus élevées.