Model AFTER IRCAM: instalasi, model terlatih, dan pelatihan
Model AFTER dari IRCAM adalah model sintesis audio neural yang dapat dikontrol musisi secara real time dan polifonik dengan input yang sudah dikenal: not MIDI atau tinggi nada dan kenyaringan sinyal audio lain.
Untuk mencobanya, unduh model yang sudah dilatih dan patch Max dari folder bersama IRCAM, instal modul eksternal nn~, lalu buka patch di Max atau perangkat Max for Live di Ableton Live. Untuk melatih model sendiri, instal paket Python dari GitHub dan ikuti langkah pelatihan di bawah.

Apa itu model AFTER?
AFTER adalah singkatan dari Audio Features Transfer and Exploration in Real-time. Model ini memisahkan ekspresi musik (struktur) dari identitas bunyi (warna suara), sehingga Anda dapat mengubah keduanya secara terpisah.
Model "kotak hitam" sebelumnya menghasilkan bunyi dari koordinat laten abstrak yang sulit diarahkan. AFTER menggunakan kontrol yang eksplisit. Anda dapat menerapkan permainan satu instrumen (seperti kurva tinggi nada suara manusia) pada warna suara instrumen lain yang telah dipelajari, atau memainkan model sepenuhnya melalui MIDI. Berbeda dengan DDSP yang hanya mengikuti satu tinggi nada pada satu waktu, AFTER dapat memainkan akor dari MIDI jika dilatih dengan data polifonik.
Untuk mengubah gaya lagu yang sudah jadi, bukan satu permainan instrumen, remix AI mempertahankan stem vokal dan menghasilkan ulang bagian instrumental dari prompt teks.
Sejarah dan asal-usul: tim ACIDS
AFTER berasal dari riset doktoral Nils Demerlé di IRCAM (Institut Penelitian dan Koordinasi Akustik dan Musik) di Paris. Ia bekerja dalam kelompok ACIDS bersama Ninon Devis, Philippe Esling, Guillaume Doras, dan David Genova untuk mengatasi keterbatasan autoenkoder variasional (VAE).
VAE seperti model RAVE mengompresi audio dengan baik, tetapi tinggi nada dan warna suara sering tercampur dalam dimensi laten yang sama ("keterikatan"), sehingga sulit dikontrol secara terpisah. Tim tersebut mempresentasikan solusinya dalam makalah "Menggabungkan kontrol audio dan transfer gaya melalui difusi laten" pada Agustus 2024. Tujuannya adalah membawa kualitas audio model difusi ke pertunjukan musik langsung.

Bagaimana AFTER bekerja? Arsitektur difusi laten
AFTER menggunakan difusi laten bersyarat. Alih-alih menghasilkan sampel audio mentah satu per satu yang lambat, model ini bekerja dalam ruang "laten" terkompresi yang disediakan autoenkoder yang sudah dilatih.

Struktur dan warna suara
AFTER membagi bunyi menjadi dua aliran:
- Struktur (fitur lokal): Kontrol eksplisit yang berubah seiring waktu.
- Input audio: Tinggi nada (f_0) dan kenyaringan (dengan pembobotan A).
- Input MIDI: Representasi piano roll polifonik.
- Warna suara (fitur global): Vektor representasi yang dipelajari, tetap sepanjang waktu, dan mewakili identitas bunyi (misalnya "selo", "gitar berdistorsi").
Langkah pemrosesan
- Kompresi (codec): Codec audio neural (biasanya autoenkoder RAVE) mengompresi audio masuk menjadi vektor laten berdimensi rendah.
- Pengondisian: Sistem mengekstrak kurva tinggi nada dan kenyaringan (dengan alat seperti CREPE atau Basic Pitch) untuk membangun kondisi struktur.
- Difusi laten: U-Net bersyarat memprediksi representasi laten audio berdasarkan struktur dan warna suara target.
- Dekode: Codec audio mendekode representasi laten yang diprediksi kembali menjadi bentuk gelombang mentah.
Cara melatih model AFTER
Pelatihan memiliki tiga tahap. Repositori AFTER di GitHub memuat skrip lengkap. Instal AFTER dalam lingkungan Python 3.12:
git clone https://github.com/acids-ircam/AFTER.git
cd AFTER/
pip install -e .1. Persiapan dataset
Anda memerlukan dataset audio, biasanya lebih dari 1 jam agar hasilnya baik (berapa banyak data yang dibutuhkan DDSP, RAVE, dan AFTER). Jika instrumen yang Anda inginkan tercampur dengan instrumen lain, pisahkan terlebih dahulu dengan pemisahan stem AI berkualitas tinggi.
- Prapemrosesan: Skrip
after prepare_datasetmenganalisis audio dan mengekstrak fitur acuan. - Alat: Skrip ini menggunakan Basic Pitch dari Spotify untuk transkripsi MIDI dan pengekstrak kenyaringan untuk audio. Data disimpan dalam basis data LMDB agar dapat diakses dengan cepat selama pelatihan.
- Periksa transkripsi terlebih dahulu: Untuk mendengar seberapa baik materi Anda menjadi not sebelum pelatihan yang panjang, coba konversi audio ke MIDI pada cuplikan pendek. Panduan audio ke MIDI menjelaskan langkah di Studio.
Siapkan dataset bentuk gelombang untuk autoenkoder terlebih dahulu:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_audio --save_waveform True2. Pelatihan autoenkoder (codec)
Sebelum melatih model difusi, Anda membutuhkan "codec" yang mengompresi audio.
- Opsi A: Latih autoenkoder kausal baru dengan fungsi kerugian spektral multiskala dan fungsi kerugian engsel adversarial.
- Opsi B: Gunakan codec yang sudah dilatih dari folder bersama IRCAM atau model RAVE sebagai fondasi. Ini lebih cepat jika model yang cocok untuk jenis audio Anda sudah tersedia.
Untuk opsi A, latih dan ekspor autoenkoder:
after train_autoencoder --name AE_model_name --db_path /dataset/path_audio --config AE_4096 --gpu 0
after export_autoencoder --model_path autoencoder_runs/AE_model_name
Ekspor menghasilkan export.ts untuk pemrosesan yang tidak berjalan secara real time dan export_stream.ts untuk penggunaan real time.
3. Pelatihan model difusi
Pada tahap ini, model mempelajari bagaimana sinyal kontrol dipetakan menjadi bunyi.
- Tujuan: Model meminimalkan kesalahan prediksi derau (MSE). Dengan kata lain, model belajar menghilangkan derau langkah demi langkah sampai hanya bunyi target yang tersisa.
- Pemisahan fitur: Kriteria adversarial memberi penalti kepada model setiap kali encoder warna suara menangkap informasi tinggi nada. Ini menjaga kedua kontrol tetap terpisah.
Enkode audio Anda dengan codec, lalu latih model difusi:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_latent --emb_model_path AE_model_run/export.ts
after train --name diff_model_name --db_path /dataset/path_latent --emb_model_path AE_model_run/export.ts --config audio
4. Ekspor untuk penggunaan real time
Ekspor dengan after export untuk perangkat Audio-to-Audio, atau after export_midi untuk perangkat MIDI-to-Audio:
after export --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
after export_midi --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
Ekspor juga menulis peta laten .png. README meminta Anda menyimpannya bersama file .ts.
Cara menggunakan AFTER secara real time: Max for Live dan Max/MSP
Integrasi Max for Live (M4L)
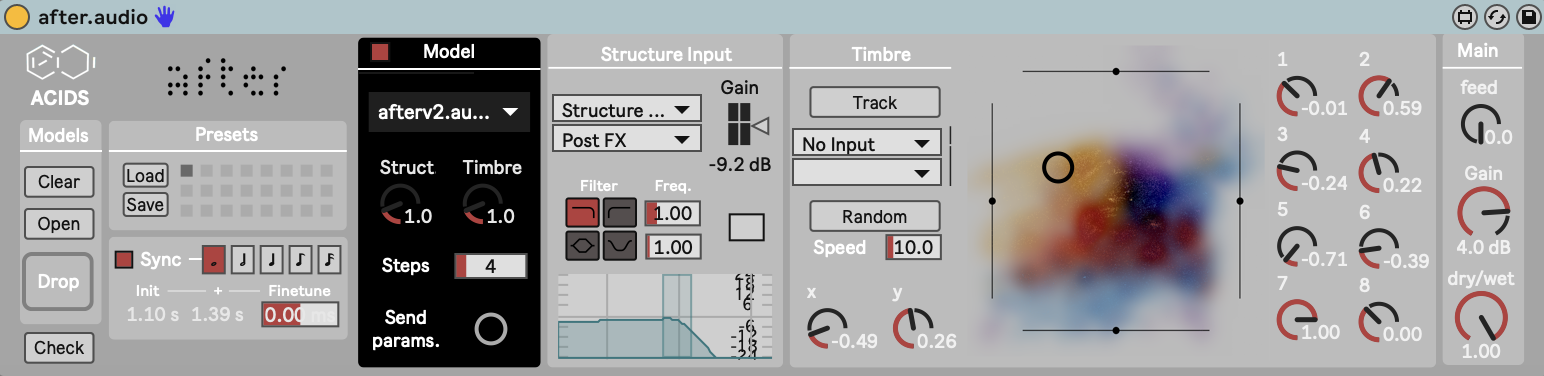
Untuk pengguna Ableton Live, AFTER menyediakan dua perangkat Max for Live yang menghubungkan Live dengan model.
Yang pertama adalah Audio-to-Audio. Perangkat ini menggunakan input sidechain (misalnya suara Anda) untuk mengarahkan tinggi nada dan kenyaringan model neural.
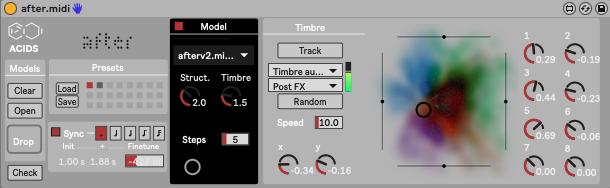
Yang kedua adalah MIDI-to-Audio. Perangkat ini memasukkan not MIDI ke model sebagai input struktur piano roll. Berkat arsitektur difusi laten, perangkat ini mendukung polifoni jika model dilatih dengan data polifonik. Untuk memainkan MIDI yang sama melalui sampel rekaman, muat instrumen SFZ di sforzando.
Max/MSP dan nn~
Untuk pengembang, AFTER berjalan dalam Max/MSP melalui modul eksternal nn~, yang memuat model TorchScript hasil ekspor (file .ts) langsung ke dalam patch.
Berapa latensi AFTER?
AFTER berperilaku berbeda dari model umpan maju sekali jalan seperti RAVE, karena difusi membutuhkan beberapa langkah.
Latensi: Setiap langkah penghilangan derau menambah komputasi, sehingga implementasi real time biasanya memiliki latensi 200 hingga 500 ms. AFTER menghasilkan audio saat dimainkan, tetapi memainkannya terasa lebih seperti bermain melalui penundaan yang dapat diperkirakan daripada instrumen yang merespons seketika. Dalam pertunjukan langsung, beberapa artis menggunakan pendekatan "pengulangan": AFTER memainkan kembali setiap frasa pada siklus loop berikutnya. Untuk instrumen yang merespons seketika, jaringan kecil seperti yang ada pada plugin ampli gitar neural gratis lebih cocok.
Penggunaan GPU: Inferensi berjalan melalui nn~ yang mendukung akselerasi GPU, tetapi pengguna biasanya melihat sedikit perbedaan. Karena difusi bersifat iteratif, penggunaan CPU tetap tinggi dibandingkan DSP standar.
Tanya jawab AFTER
Apakah ada plugin VST AFTER?
Tidak. Repositori resmi menawarkan perangkat Max for Live untuk Ableton Live dan patch Max yang berjalan melalui nn~. Repositori itu tidak menyebutkan plugin VST atau AU.
Di mana model AFTER yang sudah dilatih?
IRCAM menyediakan model terlatih, codec terlatih, dan patch Max dalam folder bersama yang ditautkan dari README AFTER.
Apakah AFTER sama dengan IRCAMAX?
Tidak. IRCAMAX adalah paket komersial perangkat Max for Live dari IRCAM yang dijual oleh Ableton. AFTER adalah model riset dari tim ACIDS IRCAM dengan kode publik di GitHub.
AFTER atau RAVE?
RAVE adalah model sekali jalan dengan latensi lebih rendah, tetapi kontrolnya berupa dimensi laten abstrak. AFTER menambahkan kontrol eksplisit untuk tinggi nada, kenyaringan, dan MIDI polifonik di atas codec, dengan konsekuensi latensi serta penggunaan CPU yang lebih tinggi.