IRCAM AFTER-Modell: Installation, vortrainierte Modelle und Training
Das AFTER-Modell von IRCAM ist ein neuronales Audiosynthesemodell, das Musiker mit vertrauten Eingaben in Echtzeit und polyphon steuern können: MIDI-Noten oder Tonhöhe und Lautstärke eines anderen Audiosignals.
Zum Ausprobieren laden Sie die vortrainierten Modelle und Max-Patches aus IRCAMs gemeinsamem Ordner herunter, installieren das externe Objekt nn~ und öffnen den Patch in Max oder die Max for Live-Geräte in Ableton Live. Für ein eigenes Modell installieren Sie das Python-Paket von GitHub und folgen den Trainingsschritten weiter unten.

Was ist das AFTER-Modell?
AFTER steht für Audio Features Transfer and Exploration in Real-time. Es trennt musikalischen Ausdruck (Struktur) von der Klangidentität (Klangfarbe), sodass Sie beide unabhängig voneinander verändern können.
Frühere „Blackbox“-Modelle erzeugen Klang aus abstrakten latenten Koordinaten, die schwer zu steuern sind. AFTER verwendet stattdessen explizite Steuersignale. Sie können die Darbietung eines Instruments, etwa den Tonhöhenverlauf einer Stimme, auf die erlernte Klangfarbe eines anderen übertragen oder das Modell ausschließlich über MIDI spielen. Anders als DDSP, das jeweils nur einer Tonhöhe folgt, kann AFTER MIDI-Akkorde spielen, wenn es mit polyphonen Daten trainiert wurde.
Um einen fertigen Song statt einer einzelnen Darbietung stilistisch zu verändern, behält KI-Remix den Gesangs-Stem bei und erzeugt das Instrumental aus einem Textprompt neu.
Geschichte und Ursprung: das ACIDS-Team
AFTER entstand aus der Doktorarbeit von Nils Demerlé am IRCAM (Institut für Forschung und Koordination in Akustik/Musik) in Paris. Er arbeitete in der ACIDS-Gruppe mit Ninon Devis, Philippe Esling, Guillaume Doras und David Genova daran, eine Einschränkung variationaler Autoencoder (VAE) zu beheben.
VAE wie das RAVE-Modell komprimieren Audio gut, doch Tonhöhe und Klangfarbe landen häufig vermischt in denselben latenten Dimensionen („Vermischung“). Dadurch lassen sie sich schwer getrennt steuern. Das Team stellte seine Lösung im Artikel „Audio-Steuerung und Stiltransfer mit latenter Diffusion kombinieren“ im August 2024 vor. Ziel war es, die Audioqualität von Diffusionsmodellen für musikalische Live-Darbietungen nutzbar zu machen.

Wie funktioniert AFTER? Architektur mit latenter Diffusion
AFTER verwendet bedingte latente Diffusion. Statt rohe Audiosamples einzeln zu erzeugen, was langsam ist, arbeitet es in einem komprimierten „latenten“ Raum, den ein vortrainierter Autoencoder bereitstellt.

Struktur und Klangfarbe
AFTER teilt Klang in zwei Ströme auf:
- Die Struktur (lokale Merkmale): explizite Steuersignale, die sich über die Zeit verändern.
- Audioeingang: Tonhöhe (f_0) und Lautstärke (A-bewertet).
- MIDI-Eingang: polyphone Piano-Roll-Darstellung.
- Die Klangfarbe (globale Merkmale): ein erlernter Einbettungsvektor, der zeitlich unverändert bleibt und die Klangidentität darstellt, etwa „Cello“ oder „verzerrte Gitarre“.
Verarbeitungsschritte
- Kompression (der Codec): ein neuronaler Audio-Codec, typischerweise ein RAVE-Autoencoder, komprimiert eingehendes Audio zu niedrigdimensionalen latenten Vektoren.
- Konditionierung: Das System extrahiert Tonhöhen- und Lautstärkeverläufe mit Tools wie CREPE oder Basic Pitch, um die Strukturbedingung zu bilden.
- Latente Diffusion: Ein bedingtes U-Net sagt die latenten Audiodarstellungen anhand der Struktur und der Zielklangfarbe voraus.
- Decodierung: Der Audio-Codec decodiert die vorhergesagten latenten Darstellungen zurück zu rohen Wellenformen.
So trainieren Sie AFTER-Modelle
Das Training hat drei Phasen. Das AFTER-GitHub-Repository enthält die vollständigen Skripte. Installieren Sie AFTER in einer Python 3.12-Umgebung:
git clone https://github.com/acids-ircam/AFTER.git
cd AFTER/
pip install -e .1. Datensatzvorbereitung
Sie benötigen einen Audiodatensatz, für gute Ergebnisse typischerweise mit mehr als 1 Stunde Material (wie viel Audiomaterial DDSP, RAVE und AFTER jeweils benötigen). Wenn das gewünschte Instrument mit anderen gemischt ist, isolieren Sie es zunächst mit hochwertiger KI-Stem-Trennung.
- Vorverarbeitung: Das Skript
after prepare_datasetanalysiert das Audio und extrahiert die Referenzmerkmale. - Tools: Es verwendet Spotifys Basic Pitch für die MIDI-Transkription und Lautstärkeextraktoren für Audio. Die Daten werden für schnellen Zugriff während des Trainings in einer LMDB-Datenbank gespeichert.
- Prüfen Sie zuerst die Transkription: Um vor einem langen Training zu hören, wie gut sich Ihr Material in Noten umwandeln lässt, testen Sie die Audio-zu-MIDI-Konvertierung mit einem kurzen Ausschnitt. Die Audio-zu-MIDI-Anleitung beschreibt die Schritte in Studio.
Bereiten Sie zunächst einen Wellenformdatensatz für den Autoencoder vor:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_audio --save_waveform True2. Autoencoder-Training (der Codec)
Vor dem Training des Diffusionsmodells benötigen Sie einen „Codec“, der Audio komprimiert.
- Option A: Trainieren Sie einen neuen kausalen Autoencoder mit einem mehrskaligen spektralen Verlust und einem adversarialen Hinge-Verlust.
- Option B: Verwenden Sie einen vortrainierten Codec aus IRCAMs gemeinsamem Ordner oder ein RAVE-Modell als Backend. Das ist schneller, wenn bereits ein gutes Modell für Ihren Audiotyp existiert.
Für Option A trainieren und exportieren Sie den Autoencoder:
after train_autoencoder --name AE_model_name --db_path /dataset/path_audio --config AE_4096 --gpu 0
after export_autoencoder --model_path autoencoder_runs/AE_model_name
Der Export erstellt export.ts für die Verarbeitung außerhalb des Echtzeitbetriebs und export_stream.ts für Echtzeit.
3. Training des Diffusionsmodells
In dieser Phase lernt das Modell, wie Steuersignale auf Klang abgebildet werden.
- Ziel: Das Modell minimiert einen Rauschvorhersagefehler (MSE). Anders gesagt lernt es, Rauschen Schritt für Schritt zu entfernen, bis der Zielklang übrig bleibt.
- Entkopplung: Ein adversariales Kriterium bestraft das Modell, wenn der Klangfarben-Encoder Tonhöheninformationen erfasst. So bleiben die beiden Steuermöglichkeiten unabhängig.
Codieren Sie Ihr Audio mit dem Codec und trainieren Sie anschließend das Diffusionsmodell:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_latent --emb_model_path AE_model_run/export.ts
after train --name diff_model_name --db_path /dataset/path_latent --emb_model_path AE_model_run/export.ts --config audio
4. Export für den Echtzeitbetrieb
Exportieren Sie mit after export für das Audio-to-Audio-Gerät oder mit after export_midi für das MIDI-to-Audio-Gerät:
after export --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
after export_midi --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
Der Export schreibt außerdem eine latente Karte als .png. Laut README sollen Sie diese zusammen mit der .ts-Datei aufbewahren.
So verwenden Sie AFTER in Echtzeit: Max for Live und Max/MSP
Integration in Max for Live (M4L)
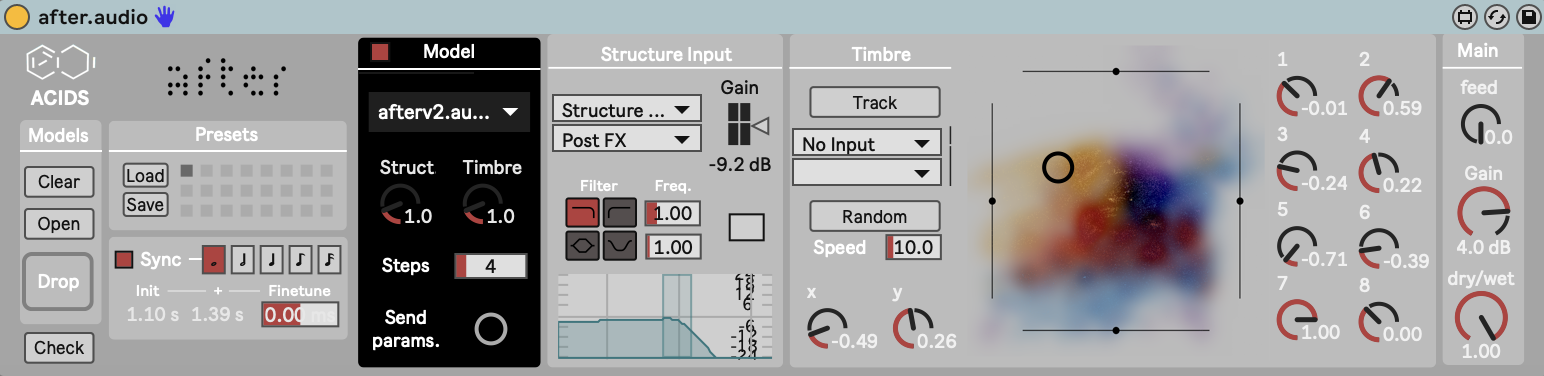
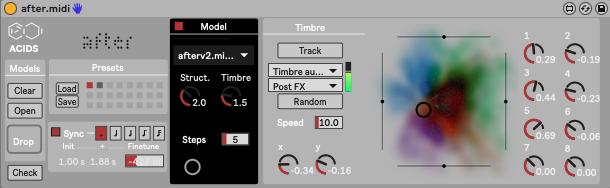
Für Ableton Live-Nutzer bietet AFTER zwei Max for Live-Geräte, die Live mit dem Modell verbinden.
Das erste heißt Audio-to-Audio. Es nutzt einen Sidechain-Eingang, etwa Ihre Stimme, um Tonhöhe und Lautstärke des neuronalen Modells zu steuern.
Das zweite heißt MIDI-to-Audio. Es speist MIDI-Noten als Struktureingabe in Piano-Roll-Form in das Modell ein. Dank der Architektur mit latenter Diffusion unterstützt es Polyphonie, wenn das Modell mit polyphonen Daten trainiert wurde. Um dasselbe MIDI stattdessen mit aufgenommenen Samples zu spielen, laden Sie ein SFZ-Instrument in sforzando.
Max/MSP und nn~
Für Entwickler läuft AFTER in Max/MSP über das externe Objekt nn~, das exportierte TorchScript-Modelle (.ts-Dateien) direkt in einen Patch lädt.
Wie hoch ist die Latenz von AFTER?
AFTER verhält sich anders als Feedforward-Modelle mit einem einzigen Durchlauf wie RAVE, weil Diffusion mehrere Schritte benötigt.
Latenz: Jeder Entrauschungsschritt verursacht zusätzliche Berechnungen, sodass die Echtzeitimplementierung typischerweise 200 bis 500 ms Latenz hat. AFTER erzeugt Audio während der Ausführung, doch das Spielen fühlt sich eher wie ein vorhersehbares Delay an als wie ein sofort reagierendes Instrument. In Live-Sets verwenden einige Künstler stattdessen einen „Loop-Aufnahme“-Ansatz: AFTER spielt jede Phrase im nächsten Loop-Zyklus ab. Für ein sofort reagierendes Instrument eignen sich kleine Netze wie die in kostenlosen neuronalen Gitarren-Amp-Plugins besser.
GPU-Auslastung: Die Inferenz läuft über nn~, das GPU-Beschleunigung unterstützt. In der Praxis bemerken Nutzer jedoch kaum einen Unterschied. Da Diffusion iterativ ist, bleibt die CPU-Auslastung im Vergleich zu Standard-DSP hoch.
AFTER-FAQ
Gibt es ein AFTER-VST-Plugin?
Nein. Das offizielle Repository bietet Max for Live-Geräte für Ableton Live und Max-Patches, die über nn~ laufen. Es erwähnt kein VST- oder AU-Plugin.
Wo finde ich die vortrainierten AFTER-Modelle?
IRCAM stellt vortrainierte Modelle, vortrainierte Codecs und Max-Patches in einem gemeinsamen Ordner bereit, der im AFTER-README verlinkt ist.
Ist AFTER dasselbe wie IRCAMAX?
Nein. IRCAMAX ist ein kommerzielles Paket mit Max for Live-Geräten von IRCAM, das Ableton verkauft. AFTER ist ein Forschungsmodell von IRCAMs ACIDS-Team mit öffentlichem Code auf GitHub.
AFTER oder RAVE?
RAVE ist ein Modell mit einem einzigen Durchlauf und geringerer Latenz, seine Steuermöglichkeiten sind jedoch abstrakte latente Dimensionen. AFTER ergänzt einen Codec um explizite Tonhöhen-, Lautstärke- und polyphone MIDI-Steuerung, auf Kosten höherer Latenz und CPU-Auslastung.