Modello AFTER di IRCAM: installazione, modelli preaddestrati e addestramento
Il modello AFTER di IRCAM è un modello di sintesi audio neurale che i musicisti possono controllare in tempo reale e in modo polifonico con ingressi familiari: note MIDI oppure l'altezza e il livello sonoro di un altro segnale audio.
Per provarlo, scarica i modelli preaddestrati e le patch Max dalla cartella condivisa di IRCAM, installa l'oggetto esterno nn~ e apri la patch in Max o i dispositivi Max for Live in Ableton Live. Per addestrare il tuo modello, installa il pacchetto Python da GitHub e segui le fasi di addestramento qui sotto.

Cos'è il modello AFTER?
AFTER significa Audio Features Transfer and Exploration in Real-time. Separa l'espressione musicale (struttura) dall'identità sonora (timbro), così puoi modificarle in modo indipendente.
I precedenti modelli a "scatola nera" generano suoni da coordinate latenti astratte difficili da controllare. AFTER usa invece controlli espliciti. Puoi applicare l'esecuzione di uno strumento, come la curva di altezza di una voce, al timbro appreso di un altro, oppure suonare il modello interamente via MIDI. A differenza di DDSP, che segue una sola altezza alla volta, AFTER può suonare accordi via MIDI se è stato addestrato su dati polifonici.
Per cambiare lo stile di un brano finito invece di una singola esecuzione, il remix con IA conserva lo stem vocale e rigenera la parte strumentale da un prompt testuale.
Storia e origine: il team ACIDS
AFTER nasce dalla ricerca di dottorato di Nils Demerlé presso IRCAM (Istituto di Ricerca e Coordinamento Acustica/Musica), a Parigi. Ha lavorato nel gruppo ACIDS con Ninon Devis, Philippe Esling, Guillaume Doras e David Genova per affrontare un limite degli autoencoder variazionali (VAE).
I VAE, come il modello RAVE, comprimono bene l'audio, ma altezza e timbro spesso finiscono mescolati nelle stesse dimensioni latenti ("intreccio"), rendendoli difficili da controllare separatamente. Il team ha presentato la soluzione nell'articolo "Combinare controllo audio e trasferimento di stile tramite diffusione latente" ad agosto 2024. L'obiettivo era portare la qualità audio dei modelli di diffusione nelle esecuzioni musicali dal vivo.

Come funziona AFTER? Architettura a diffusione latente
AFTER usa la diffusione latente condizionale. Invece di generare campioni audio grezzi uno alla volta, un processo lento, lavora in uno spazio "latente" compresso fornito da un autoencoder preaddestrato.

Struttura e timbro
AFTER divide il suono in due flussi:
- La struttura (caratteristiche locali): controlli espliciti che variano nel tempo.
- Ingresso audio: altezza (f_0) e livello sonoro (con ponderazione A).
- Ingresso MIDI: rappresentazione polifonica in piano roll.
- Il timbro (caratteristiche globali): un vettore di rappresentazione appreso che resta fisso nel tempo e rappresenta l'identità del suono, per esempio "violoncello" o "chitarra distorta".
Fasi di elaborazione
- Compressione (il codec): un codec audio neurale, in genere un autoencoder RAVE, comprime l'audio in ingresso in vettori latenti a bassa dimensionalità.
- Condizionamento: il sistema estrae le curve di altezza e livello sonoro con strumenti come CREPE o Basic Pitch per costruire la condizione di struttura.
- Diffusione latente: una U-Net condizionale predice le rappresentazioni latenti audio in base alla struttura e al timbro desiderato.
- Decodifica: il codec audio decodifica le rappresentazioni latenti predette in forme d'onda grezze.
Come addestrare modelli AFTER
L'addestramento ha tre fasi. Il repository GitHub di AFTER contiene gli script completi. Installa AFTER in un ambiente Python 3.12:
git clone https://github.com/acids-ircam/AFTER.git
cd AFTER/
pip install -e .1. Preparazione del dataset
Serve un dataset audio, in genere di più di 1 ora per ottenere buoni risultati (quanti dati servono a DDSP, RAVE e AFTER). Se lo strumento desiderato è mescolato con altri, isolalo prima con la separazione degli stem con IA di alta qualità.
- Pre-elaborazione: lo script
after prepare_datasetanalizza l'audio ed estrae le caratteristiche di riferimento. - Strumenti: usa Basic Pitch di Spotify per la trascrizione MIDI ed estrattori del livello sonoro per l'audio. I dati vengono archiviati in un database LMDB per un accesso rapido durante l'addestramento.
- Controlla prima la trascrizione: per ascoltare come il tuo materiale si trasforma in note prima di un lungo addestramento, prova la conversione audio in MIDI su un breve estratto. La guida audio in MIDI descrive i passaggi in Studio.
Prepara prima un dataset di forme d'onda per l'autoencoder:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_audio --save_waveform True2. Addestramento dell'autoencoder (il codec)
Prima di addestrare il modello di diffusione, serve un "codec" che comprima l'audio.
- Opzione A: addestra un nuovo autoencoder causale con una perdita spettrale multiscala e una perdita hinge avversaria.
- Opzione B: usa un codec preaddestrato dalla cartella condivisa di IRCAM oppure un modello RAVE come motore. È più veloce se esiste già un buon modello per il tuo tipo di audio.
Per l'opzione A, addestra ed esporta l'autoencoder:
after train_autoencoder --name AE_model_name --db_path /dataset/path_audio --config AE_4096 --gpu 0
after export_autoencoder --model_path autoencoder_runs/AE_model_name
L'esportazione crea export.ts per l'elaborazione non in tempo reale e export_stream.ts per il tempo reale.
3. Addestramento del modello di diffusione
In questa fase il modello impara come associare i segnali di controllo al suono.
- Obiettivo: il modello minimizza un errore di predizione del rumore (MSE). In altre parole, impara a rimuovere il rumore passo dopo passo finché resta il suono desiderato.
- Separazione delle caratteristiche: un criterio avversario penalizza il modello quando l'encoder del timbro acquisisce informazioni sull'altezza. Questo mantiene indipendenti i due controlli.
Codifica l'audio con il codec, poi addestra il modello di diffusione:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_latent --emb_model_path AE_model_run/export.ts
after train --name diff_model_name --db_path /dataset/path_latent --emb_model_path AE_model_run/export.ts --config audio
4. Esportazione per l'uso in tempo reale
Esporta con after export per il dispositivo Audio-to-Audio, oppure con after export_midi per il dispositivo MIDI-to-Audio:
after export --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
after export_midi --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
L'esportazione genera anche una mappa latente .png. Il README chiede di conservarla insieme al file .ts.
Come usare AFTER in tempo reale: Max for Live e Max/MSP
Integrazione con Max for Live (M4L)
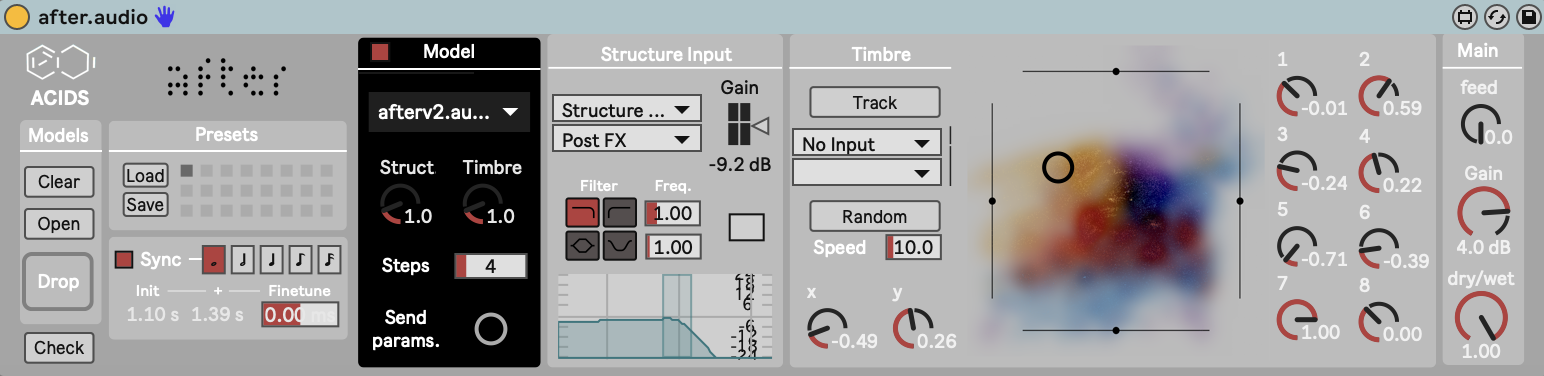
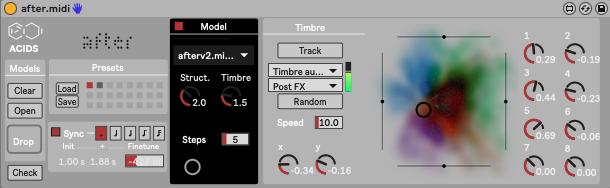
Per gli utenti di Ableton Live, AFTER offre due dispositivi Max for Live che collegano Live al modello.
Il primo è Audio-to-Audio. Usa un ingresso sidechain, per esempio la tua voce, per controllare l'altezza e il livello sonoro del modello neurale.
Il secondo è MIDI-to-Audio. Invia note MIDI al modello come ingresso di struttura in piano roll. Grazie all'architettura a diffusione latente, supporta la polifonia quando il modello è stato addestrato su dati polifonici. Per suonare lo stesso MIDI con campioni registrati, carica uno strumento SFZ in sforzando.
Max/MSP e nn~
Per gli sviluppatori, AFTER funziona dentro Max/MSP tramite l'oggetto esterno nn~, che carica modelli TorchScript esportati (file .ts) direttamente in una patch.
Qual è la latenza di AFTER?
AFTER si comporta diversamente dai modelli a propagazione diretta in una sola passata, come RAVE, perché la diffusione richiede più passaggi.
Latenza: ogni passaggio di rimozione del rumore aggiunge calcoli, quindi l'implementazione in tempo reale ha in genere da 200 a 500 ms di latenza. AFTER genera audio durante l'esecuzione, ma suonarlo dà più l'impressione di un ritardo prevedibile che di uno strumento istantaneo. Nei live, alcuni artisti usano invece un approccio da "registratore di loop": AFTER riproduce ogni frase al ciclo successivo del loop. Per uno strumento che risponde istantaneamente, sono più adatte reti piccole come quelle dei plugin neurali gratuiti di ampli per chitarra.
Uso della GPU: l'inferenza avviene tramite nn~, che supporta l'accelerazione GPU, ma nella pratica gli utenti notano poca differenza. Poiché la diffusione è iterativa, l'uso della CPU resta alto rispetto al DSP standard.
FAQ su AFTER
Esiste un plugin VST di AFTER?
No. Il repository ufficiale offre dispositivi Max for Live per Ableton Live e patch Max eseguite tramite nn~. Non menziona plugin VST o AU.
Dove sono i modelli AFTER preaddestrati?
IRCAM ospita modelli preaddestrati, codec preaddestrati e patch Max in una cartella condivisa collegata dal README di AFTER.
AFTER è la stessa cosa di IRCAMAX?
No. IRCAMAX è un pacchetto commerciale di dispositivi Max for Live di IRCAM, venduto da Ableton. AFTER è un modello di ricerca del team ACIDS di IRCAM con codice pubblico su GitHub.
AFTER o RAVE?
RAVE è un modello a passata singola con minore latenza, ma i suoi controlli sono dimensioni latenti astratte. AFTER aggiunge controllo esplicito di altezza, livello sonoro e MIDI polifonico a un codec, al costo di maggiore latenza e uso della CPU.