Modello RAVE di IRCAM: VST, modelli preaddestrati e addestramento
Il modello RAVE di IRCAM è un modello neurale audio in tempo reale che trasforma qualsiasi suono nel timbro su cui è stato addestrato. Puoi suonare modelli RAVE preaddestrati nella tua DAW con Neutone FX o RAVE VST, caricarli in Max/MSP o Pure Data con nn~ oppure addestrare i tuoi con il pacchetto Python acids-rave.
Come usare RAVE: avvio rapido
| Obiettivo | Strumento | Cosa serve |
|---|---|---|
| Suonare modelli RAVE in una DAW | Neutone FX (VST/AU gratuito) | Qualsiasi DAW. I modelli preaddestrati si scaricano nel plugin. |
| Suonare modelli RAVE in una DAW | RAVE VST (beta) | Un download da IRCAM Forum. Il repository del codice sorgente è stato archiviato nel giugno 2023 e la sua versione Windows è solo autonoma. |
| Usare RAVE in Max/MSP o Pure Data | Oggetto esterno nn~ | Max o Pd e un file di modello .ts |
| Scaricare modelli preaddestrati | Elenco ufficiale dei modelli RAVE | Esportazioni .ts in streaming per nn~ |
| Addestrare il tuo modello | acids-rave su Python | Una GPU NVIDIA con da 5 a 32 GB di memoria, qualche ora di audio e circa 3 giorni |
Per installare nn~, scarica l'ultima versione ed estraila in Documents/Max [your version]/Packages/ per Max o in Documents/Pd/externals/ per Pure Data. Metti i tuoi modelli .ts nella cartella nn_tilde/models.

Cos'è RAVE di IRCAM per la sintesi audio in tempo reale?
RAVE significa Realtime Audio Variational autoEncoder, cioè autoencoder variazionale audio in tempo reale. Pubblicato alla fine del 2021 da ricercatori di IRCAM a Parigi, impara a codificare i suoni in una rappresentazione compatta e poi a decodificarli in audio. È come insegnare a un computer a disegnare uno schizzo di ciò che sente e poi a ridisegnarlo come un'imitazione convincente del suono originale.
Lo fa abbastanza rapidamente da funzionare in tempo reale nella tua DAW o nel tuo sistema per esibizioni dal vivo.
Chi ha creato RAVE e quando?
RAVE è stato sviluppato da Antoine Caillon, che ora lavora per Google DeepMind, e Philippe Esling, nel team ACIDS di IRCAM a Parigi.
Il team aveva già esplorato il modello DDSP (Differentiable Digital Signal Processing) di Google, presentandolo nel marzo 2021, ma voleva un modello più flessibile che potesse trattare qualsiasi tipo di suono, non solo strumenti musicali.
L'obiettivo era un modello capace di funzionare su hardware comune e offrire audio di qualità da studio. Lo hanno presentato nel paper del 2021, «RAVE: un autoencoder variazionale per la sintesi audio neurale rapida e di alta qualità».
Architettura RAVE: come funziona questo autoencoder variazionale
RAVE è un autoencoder: una rete neurale che impara a comprimere i dati in uno «spazio latente» compatto e poi a decomprimerli.
RAVE: addestramento in due fasi
Fase 1: apprendimento della rappresentazione
Fase 2: affinamento avversario
Diagramma di addestramento adattato dall'articolo originale su RAVE. La fase 1 addestra l'encoder e il decoder con un errore spettrale multibanda. La fase 2 congela l'encoder, blocca i gradienti attraverso il codice latente e addestra il decoder e il discriminatore. L'analisi e la sintesi PQMF restano fisse.
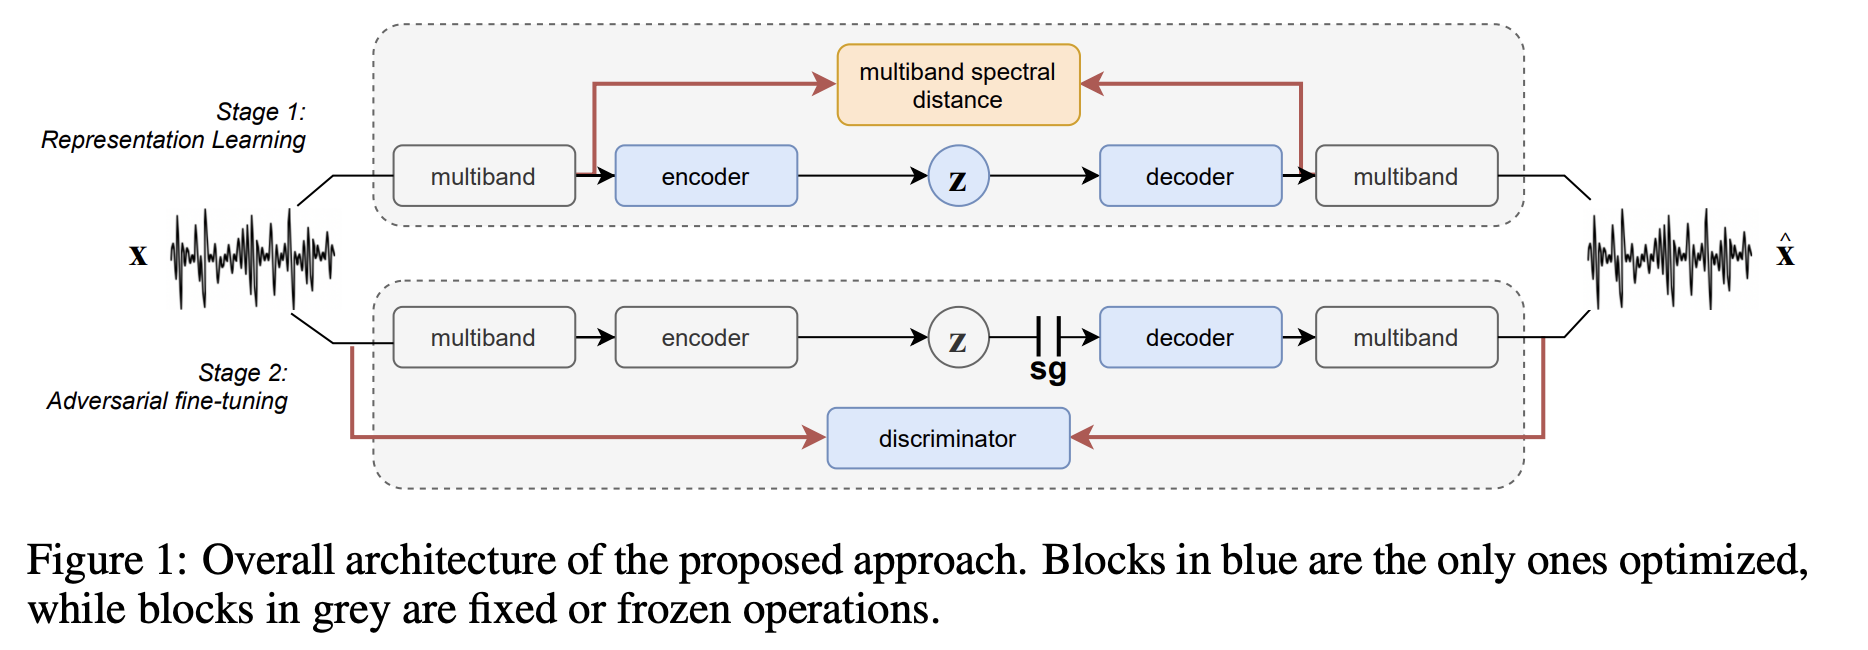
Figura originale: RAVE: addestramento in due fasi.
Come funziona l'addestramento di RAVE in due fasi
Immagina di formare un musicista in due fasi:
-
Fase 1: imparare ad ascoltare (apprendimento della rappresentazione)
- L'encoder impara a condensare l'audio in un insieme compatto di numeri, lo spazio latente
- Il decoder impara a ricostruire l'audio da quei numeri
- L'addestramento usa un errore spettrale che confronta il contenuto in frequenza dell'audio originale e di quello ricostruito
-
Fase 2: imparare a improvvisare (affinamento avversario)
- L'encoder viene congelato, perché sa già ascoltare
- Si aggiunge una rete «discriminatrice»: un critico che giudica se l'audio ricostruito suona reale
- Il decoder impara da questo riscontro a produrre audio più convincente
Componenti tecnici principali
- Filtri PQMF: RAVE divide l'audio in più sottobande di frequenza prima dell'elaborazione, aumentando l'efficienza
- Modalità causale e non causale: la modalità causale sacrifica parte della qualità per una latenza inferiore dal vivo
- Più configurazioni: dalla leggera "raspberry", che funziona su Raspberry Pi, alla "v3", orientata alla qualità
Per i dettagli di implementazione, consulta il repository GitHub ufficiale di RAVE, che include i file di configurazione e le definizioni dei modelli.

Come addestrare modelli RAVE con i tuoi dati audio?
Vuoi un modello che trasformi la tua voce in un sassofono? Addestrare RAVE richiede conoscenze di Python e una GPU. Il repository ufficiale di RAVE documenta il procedimento completo.
Requisiti per preparare il dataset
Per addestrare un modello RAVE servono:
- Da 2 a 3 ore di audio pulito, più ce n'è, meglio è
- Registrazioni di qualità da studio, perché RAVE impara tutto, inclusi rumore e riverbero
- Suoni diversi se vuoi versatilità
Per creare un dataset da mix completi, isola prima lo strumento con la separazione di stem IA di alta qualità. Anche gli artefatti di separazione finiscono nel modello, quindi usa gli stem più puliti che puoi ottenere. La guida alla separazione degli stem mostra come farlo in Neural Analog.
Installa RAVE e prepara il dataset
Installa prima PyTorch e TorchAudio per la tua GPU, poi RAVE. Serve anche FFmpeg; in un ambiente conda, installalo con conda:
pip install acids-rave
conda install ffmpeg
La pre-elaborazione converte i tuoi file audio nel formato di dataset di RAVE:
rave preprocess --input_path /audio/folder --output_path /dataset/path --channels 1Usa --channels 1 per mono o --channels 2 per stereo. Aggiungi --lazy per addestrare direttamente su file compressi come MP3, ma aspettati un carico CPU molto maggiore durante l'addestramento. Per tutti i parametri, consulta la documentazione di preparazione del dataset RAVE.
Procedimento e configurazioni di addestramento di RAVE
Avvia l'addestramento con un nome di configurazione:
rave train --config v2 --db_path /dataset/path --out_path /model/out --name my_model --channels 1Scegli la configurazione adatta alla tua GPU. La memoria GPU minima viene dal README ufficiale:
| Configurazione | Memoria GPU min. | Uso |
|---|---|---|
raspberry | 5 GB | Modello leggero per il tempo reale su Raspberry Pi 4 |
onnx | 6 GB | v1 senza rumore per l'esportazione ONNX |
v1 | 8 GB | Il modello continuo originale |
v2_small | 8 GB | Trasferimento timbrico su suoni stazionari |
v2 | 16 GB | Il modello continuo migliorato e una buona scelta predefinita |
discrete | 18 GB | Un modello discreto simile a SoundStream o EnCodec |
v3 | 32 GB | Qualità massima, con trasferimento di stile (AdaIN) |
Puoi combinare una configurazione con opzioni come causal per una latenza inferiore o noise. Un notebook Colab della community per RAVEv2, collegato nel README, permette di addestrare sulle GPU di Google se non ne hai una.
Cosa aspettarsi durante l'addestramento:
- Fase 1 (~1M passi): la qualità audio parte bassa e migliora gradualmente
- Fase 2 (addestramento avversario): la qualità migliora nettamente
- Tempo totale: circa 3 giorni su una GPU RTX 3080
I notebook di addestramento RAVE della community illustrano il procedimento passo dopo passo.
Esportare modelli RAVE per l'uso in tempo reale
L'esportazione conta per l'uso in tempo reale. Usa l'opzione --streaming per abilitare le convoluzioni in cache, evitando artefatti di clic:
rave export --run /path/to/your/run --streamingIl risultato è un file TorchScript .ts che nn~ può caricare. Per i parametri di esportazione e la risoluzione dei problemi, consulta la documentazione di esportazione RAVE.
Inferenza RAVE e opzioni di uso in tempo reale
Non vuoi aspettare 3 giorni di addestramento? Puoi provare modelli RAVE preaddestrati in vari strumenti. Caricano anche i modelli che hai addestrato tu, e la FAQ su come usare un modello addestrato nella tua DAW indica il plugin per ogni tipo di modello.
Neutone FX: plugin VST/AU gratuito per modelli RAVE
Neutone FX è un plugin VST/AU gratuito che ospita modelli RAVE. È il plugin Neutone originale del 2022, ora mantenuto come piattaforma aperta. Installalo per caricare una raccolta di modelli preaddestrati direttamente nella tua DAW (Ableton, Logic, Reaper e altre).

RAVE VST di IRCAM, beta e archiviato
IRCAM ha anche pubblicato il suo RAVE VST, con versioni VST, AU e autonome. Ha due modalità: reconstruction, che elabora l'audio proveniente dalla DAW, e prior, che genera suono esplorando lo spazio latente da solo. Il suo Model Explorer scarica modelli preaddestrati, e puoi importare i tuoi se li esporti con --stereo true.
Il repository rave_vst è stato archiviato nel giugno 2023, quindi non aspettarti correzioni. Su Windows esiste solo una versione autonoma sperimentale, e gli utenti Mac M1 devono compilarla da sé. Gli sviluppatori raccomandano invece nn~ per l'uso in tempo reale.
Integrazione con Max/MSP e Pure Data tramite nn~
Per le esibizioni dal vivo, l'oggetto esterno nn~ carica modelli RAVE direttamente in Max/MSP e Pure Data. Permette di manipolare direttamente lo spazio latente e usare Adaptive Instance Normalization per il trasferimento di stile. Funziona anche su piattaforme embedded come Raspberry Pi per installazioni portatili. Le stesse schede eseguono plugin neurali di amplificatori per chitarra come ToobAmp e Stompbox. Se la tua scheda è una NVIDIA Jetson Nano, ricorda che non ha un'uscita audio analogica: aggiungi prima una scheda audio I2S come Raspiaudio Audio+.
Limiti di prestazioni e precauzioni tecniche di RAVE
Conosci questi limiti prima di affidarti a RAVE:
- Latenza: anche in modalità causale, aspettati un ritardo percepibile, persino su Apple Silicon di fascia alta. Può andare bene in studio, ma prova con attenzione RAVE prima di usarlo come strumento dal vivo.
- Accelerazione GPU: il modello usa molte piccole convoluzioni limitate dagli accessi alla memoria, non dalla potenza di calcolo, quindi si parallelizza male. Per l'uso in tempo reale, il costo aggiuntivo della GPU supera spesso il vantaggio, salvo nell'elaborazione in batch.
- Qualità audio: RAVE può suonare notevole, ma potrebbe non eguagliare la fedeltà della sintesi tradizionale o di modelli neurali più avanzati, come quelli basati sulla diffusione.
- Addestramento difficile: addestrare un modello RAVE richiede esperienza di apprendimento automatico e trattamento audio, oltre a hardware potente.
Dopo RAVE: Neutone Morpho e il modello AFTER
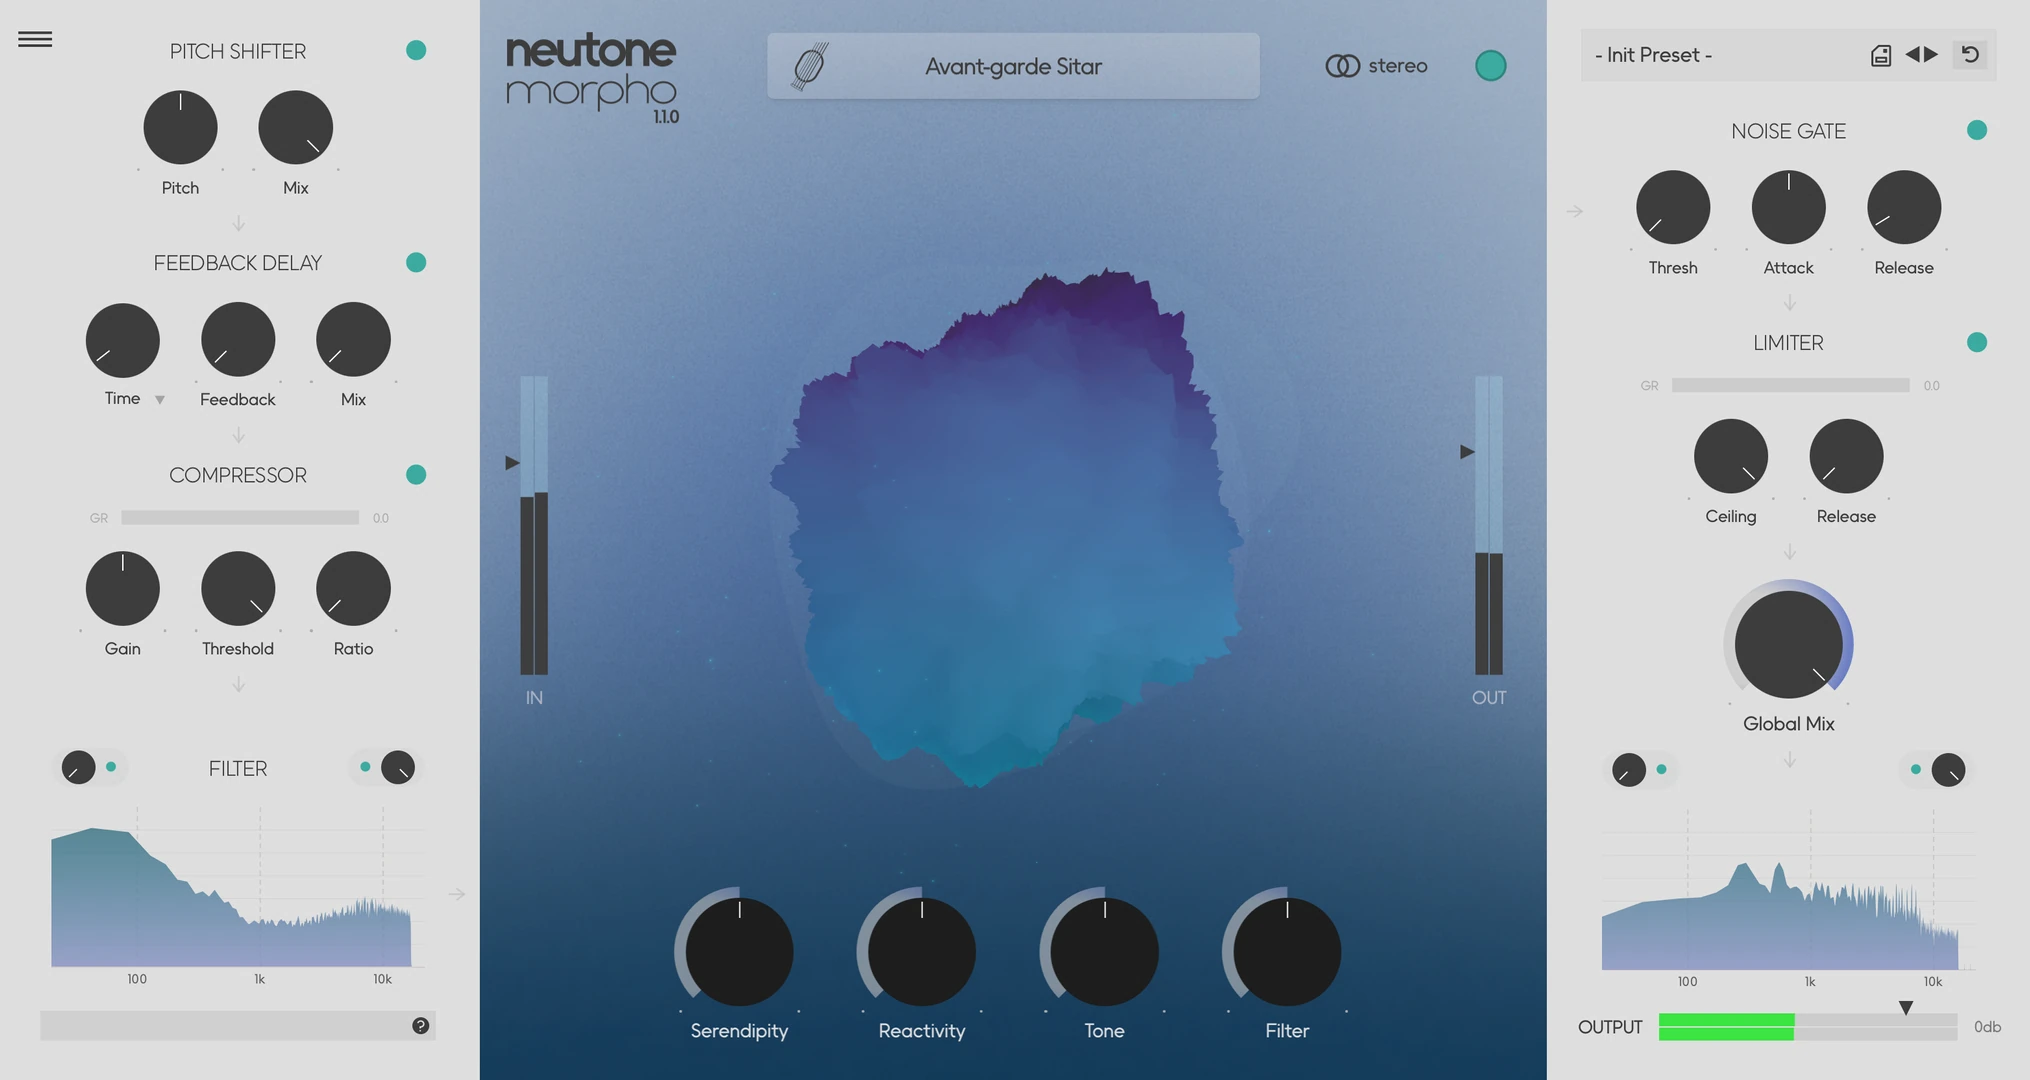
Neutone Morpho: evoluzione commerciale di RAVE nel 2024
Nel febbraio 2024, il team Neutone guidato da Nao Tokui ha pubblicato Morpho, un successore commerciale del plugin FX gratuito. RAVE è il motore open source sviluppato per la ricerca. Morpho integra una tecnologia simile in un prodotto rifinito per musicisti e produttori, a costo di una minore flessibilità.
Modello AFTER: alternativa di IRCAM basata sulla diffusione
Lo stesso team IRCAM ACIDS ha anche pubblicato AFTER (Audio Features Transfer and Exploration in Real-time), un modello basato sulla diffusione. Mira a offrire più possibilità di regolazione, con controllo del timbro in tempo reale come un sintetizzatore tradizionale.
Per cambiare lo stile di un intero brano da un prompt testuale invece che di un solo suono, il remix IA mantiene lo stem vocale e rigenera la parte strumentale con Stable Audio 3.
Domande frequenti su RAVE
Dove posso scaricare modelli RAVE preaddestrati?
IRCAM elenca modelli in streaming nella pagina ufficiale dei modelli RAVE. Neutone FX e RAVE VST possono anche scaricare modelli dall'interno del plugin. Controlla la licenza di ogni modello prima di usarlo in una pubblicazione commerciale.
Quanto audio serve per addestrare RAVE?
Prevedi da 2 a 3 ore di audio pulito da una sola sorgente. RAVE impara tutto nelle registrazioni, inclusi rumore e riverbero della stanza. Per i valori di DDSP e AFTER, consulta quanti dati servono per addestrare un modello.
Posso addestrare RAVE su un Mac?
Non è una buona scelta. La guida RAVE dell'UAL Creative Computing Institute richiede una GPU NVIDIA compatibile con CUDA con almeno 8 GB di memoria e sconsiglia macOS. Usa una GPU cloud o il notebook Colab della community.
Perché il mio modello RAVE produce clic in Max?
Il modello è stato esportato senza --streaming. Esportalo di nuovo con quell'opzione.
RAVE o DDSP?
DDSP richiede solo circa 10 minuti di audio, ma modella soltanto strumenti monofonici ad altezza definita. RAVE gestisce qualsiasi suono, inclusi batteria, voci e texture, ma richiede ore di audio e giorni di addestramento.