IRCAM RAVE 모델: VST, 사전 학습 모델과 학습
IRCAM의 RAVE는 어떤 소리든 학습한 음색으로 바꾸는 실시간 신경망 오디오 모델입니다. Neutone FX 또는 RAVE VST를 통해 DAW에서 사전 학습된 RAVE 모델을 실행하거나, nn~로 Max/MSP 또는 Pure Data에 불러올 수 있습니다. acids-rave Python 패키지로 직접 모델을 학습할 수도 있습니다.
RAVE 사용법: 빠른 시작
| 목표 | 도구 | 필요한 것 |
|---|---|---|
| DAW에서 RAVE 모델 실행 | Neutone FX (무료 VST/AU) | 어떤 DAW든 가능합니다. 사전 학습 모델은 플러그인 안에서 다운로드합니다. |
| DAW에서 RAVE 모델 실행 | RAVE VST (베타) | IRCAM Forum에서 다운로드해야 합니다. 소스 저장소는 2023년 6월에 보관 처리되었으며 Windows 빌드는 독립 실행형만 제공됩니다. |
| Max/MSP 또는 Pure Data에서 RAVE 사용 | nn~ 외부 객체 | Max 또는 Pd와 .ts 모델 파일 |
| 사전 학습 모델 다운로드 | 공식 RAVE 모델 목록 | nn~용 스트리밍 .ts 내보내기 파일 |
| 직접 모델 학습 | Python에서 실행하는 acids-rave | 메모리 5~32 GB의 NVIDIA GPU, 몇 시간 분량의 오디오, 약 3일 |
nn~를 설치하려면 최신 릴리스를 다운로드한 뒤 Max는 Documents/Max [your version]/Packages/, Pure Data는 Documents/Pd/externals/에 압축을 풉니다. .ts 모델은 nn_tilde/models 폴더에 넣으세요.

실시간 오디오 합성을 위한 IRCAM RAVE란?
RAVE는 Realtime Audio Variational autoEncoder의 약자로, 실시간 오디오 변분 오토인코더를 뜻합니다. 파리 IRCAM 연구진이 2021년 말에 발표한 이 모델은 소리를 간결한 표현으로 인코딩한 뒤 다시 오디오로 디코딩하는 법을 학습합니다. 컴퓨터가 들은 소리를 스케치하고, 그 스케치를 바탕으로 원음과 닮은 소리를 설득력 있게 다시 그리도록 가르친다고 생각하면 됩니다.
처리 속도가 충분히 빨라 DAW나 라이브 공연 시스템에서 실시간으로 실행할 수 있습니다.
RAVE는 누가 언제 만들었나요?
RAVE는 현재 Google DeepMind에서 일하는 Antoine Caillon과 파리 IRCAM ACIDS 팀의 Philippe Esling이 개발했습니다.
연구진은 이전에 Google의 DDSP(Differentiable Digital Signal Processing, 미분 가능한 디지털 신호 처리) 모델을 연구하고 2021년 3월에 시연했습니다. 그러나 악기뿐 아니라 어떤 종류의 소리도 처리할 수 있는 더 유연한 모델을 만들고 싶었습니다.
목표는 일반적인 하드웨어에서 실행하면서도 스튜디오 수준의 오디오를 제공하는 모델이었습니다. 연구진은 2021년 논문 「RAVE: 빠르고 고품질인 신경망 오디오 합성을 위한 변분 오토인코더」에서 이 모델을 소개했습니다.
RAVE 구조: 변분 오토인코더의 작동 방식
RAVE는 오토인코더입니다. 데이터를 간결한 '잠재 공간'으로 압축한 다음 다시 복원하는 법을 학습하는 신경망입니다.
RAVE: 2단계 학습
1단계: 표현 학습
2단계: 적대적 미세 조정
RAVE 원 논문의 학습 도식을 바탕으로 구성한 그림입니다. 1단계에서는 다중 대역 스펙트럼 손실로 인코더와 디코더를 학습합니다. 2단계에서는 인코더를 동결하고 잠재 코드를 통한 그래디언트 전파를 차단한 뒤 디코더와 판별자를 학습합니다. PQMF 분석 및 합성 필터 뱅크는 고정된 상태를 유지합니다.
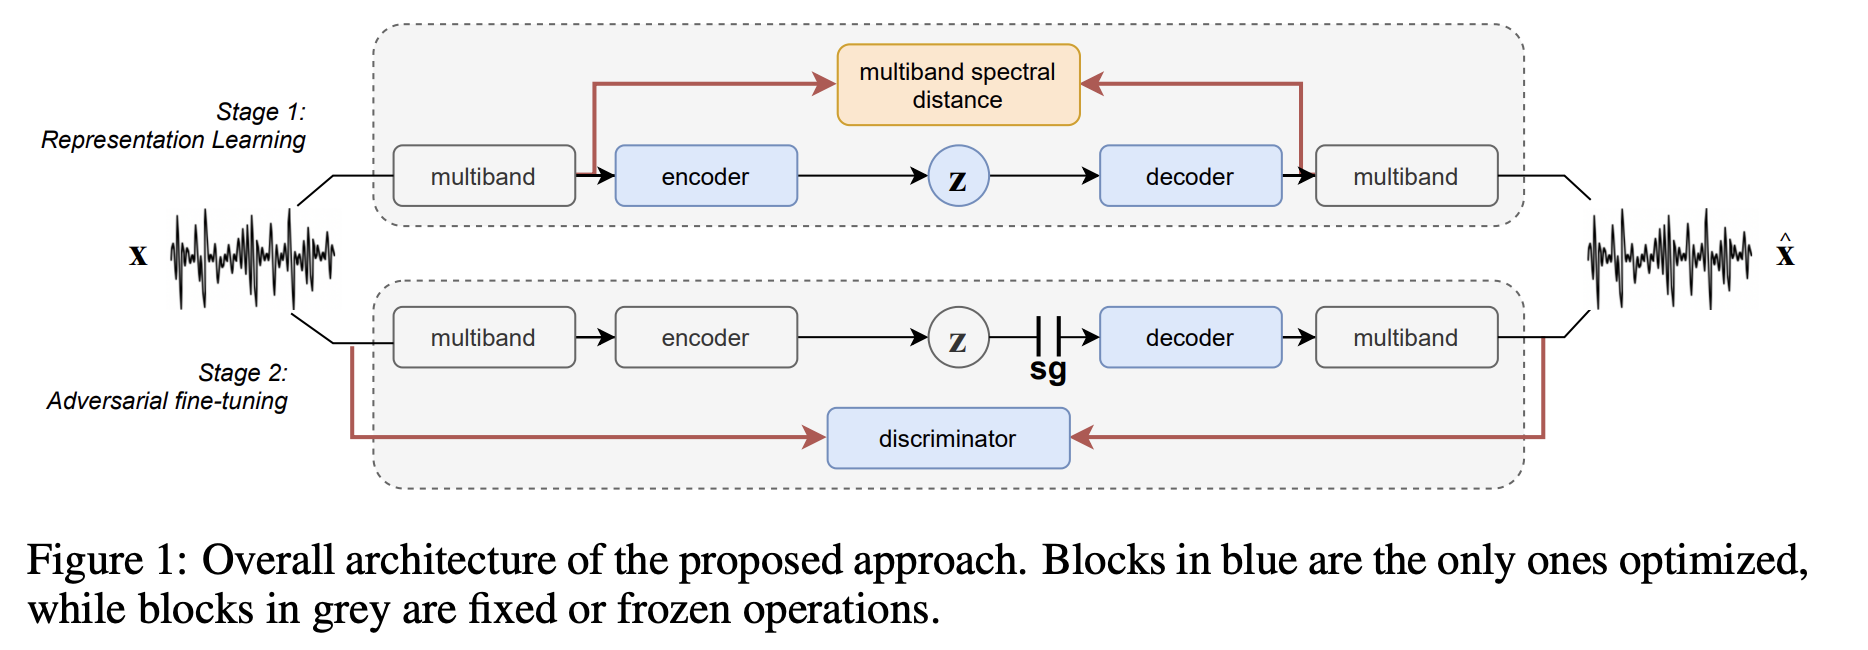
원본 도식: RAVE: 2단계 학습.
RAVE의 2단계 학습은 어떻게 이루어지나요?
음악가를 두 단계에 걸쳐 훈련한다고 생각해 보세요.
-
1단계: 듣는 법 학습 (표현 학습)
- 인코더는 오디오를 적은 수의 숫자, 즉 잠재 공간의 표현으로 압축하는 법을 배웁니다
- 디코더는 이 숫자에서 오디오를 재구성하는 법을 배웁니다
- 학습에는 원본과 재구성 오디오의 주파수 성분을 비교하는 스펙트럼 손실을 사용합니다
-
2단계: 즉흥 연주 학습 (적대적 미세 조정)
- 인코더를 동결합니다. 이미 듣는 법을 배웠기 때문입니다
- 재구성 오디오가 실제처럼 들리는지 판단하는 비평가 역할의 '판별자' 신경망을 추가합니다
- 디코더는 이 피드백을 바탕으로 더 그럴듯한 오디오를 만드는 법을 배웁니다
핵심 기술 요소
- PQMF 필터: RAVE는 처리 전에 오디오를 여러 주파수 하위 대역으로 나누어 효율을 높입니다
- 인과 및 비인과 모드: 인과 모드는 일부 음질을 희생하는 대신 라이브 환경에서 지연을 줄입니다
- 여러 구성: Raspberry Pi에서 실행되는 가벼운 'raspberry'부터 고품질 'v3'까지 제공합니다
구현 세부 사항은 구성 파일과 모델 정의가 포함된 공식 RAVE GitHub 저장소를 참고하세요.

자체 오디오 데이터로 RAVE 모델을 학습하려면?
목소리를 색소폰 소리로 바꾸는 모델을 만들고 싶으신가요? RAVE 모델을 학습하려면 Python 지식과 GPU가 필요합니다. 공식 RAVE 저장소에 전체 과정이 설명되어 있습니다.
데이터셋 준비 요건
RAVE 모델 학습에는 다음이 필요합니다.
- 깨끗한 오디오 2~3시간 분량 (많을수록 좋습니다)
- 스튜디오 수준의 녹음: RAVE는 잡음과 리버브를 포함해 모든 것을 학습합니다
- 다양한 용도로 쓰려면 다양한 소리
전체 믹스에서 데이터셋을 만들려면 먼저 고품질 AI 스템 분리로 악기를 분리하세요. 분리 과정의 아티팩트도 모델에 학습되므로 가능한 한 깨끗한 스템을 사용해야 합니다. 스템 분리 가이드에서 Neural Analog로 분리하는 방법을 안내합니다.
RAVE 설치 및 데이터셋 준비
먼저 GPU에 맞는 PyTorch와 TorchAudio를 설치한 뒤 RAVE를 설치하세요. FFmpeg도 필요합니다. conda 환경에서는 conda로 설치합니다.
pip install acids-rave
conda install ffmpeg
전처리는 오디오 파일을 RAVE의 데이터셋 형식으로 변환합니다.
rave preprocess --input_path /audio/folder --output_path /dataset/path --channels 1모노는 --channels 1, 스테레오는 --channels 2를 사용하세요. --lazy를 추가하면 MP3 같은 압축 파일로 직접 학습할 수 있지만 학습 중 CPU 부하가 훨씬 커집니다. 모든 매개변수는 RAVE 데이터셋 준비 문서를 참고하세요.
RAVE 학습 과정과 구성
구성 이름을 지정해 학습을 시작합니다.
rave train --config v2 --db_path /dataset/path --out_path /model/out --name my_model --channels 1GPU에 맞는 구성을 선택하세요. 최소 GPU 메모리 요구량은 공식 README를 따릅니다.
| 구성 | 최소 GPU 메모리 | 용도 |
|---|---|---|
raspberry | 5 GB | Raspberry Pi 4에서 실시간으로 실행하는 경량 모델 |
onnx | 6 GB | ONNX 내보내기용 무잡음 v1 |
v1 | 8 GB | 원래의 연속형 모델 |
v2_small | 8 GB | 정상 상태 소리의 음색 변환 |
v2 | 16 GB | 개선된 연속형 모델로, 기본 선택으로 적합 |
discrete | 18 GB | SoundStream 또는 EnCodec과 유사한 이산형 모델 |
v3 | 32 GB | 최고 품질 및 스타일 변환(AdaIN) |
구성에 causal(낮은 지연)이나 noise 같은 옵션을 조합할 수 있습니다. GPU가 없다면 README에 링크된 커뮤니티 RAVEv2 Colab 노트북으로 Google의 GPU에서 학습할 수 있습니다.
학습 중 예상할 수 있는 변화:
- 1단계 (약 100만 스텝): 처음에는 음질이 거칠지만 점차 개선됩니다
- 2단계 (적대적 학습): 음질이 크게 개선됩니다
- 전체 소요 시간: RTX 3080 GPU에서 약 3일
커뮤니티가 제공한 RAVE 학습 노트북에서 전체 과정을 단계별로 안내합니다.
실시간 사용을 위한 RAVE 모델 내보내기
실시간으로 사용할 때는 내보내기 방식이 중요합니다. --streaming 플래그를 사용하면 캐시된 컨볼루션을 활성화해 클릭 아티팩트를 방지할 수 있습니다.
rave export --run /path/to/your/run --streaming결과물은 nn~가 불러올 수 있는 TorchScript .ts 파일입니다. 내보내기 매개변수와 문제 해결은 RAVE 내보내기 문서를 참고하세요.
RAVE 모델 추론 및 실시간 사용 방법
학습이 끝날 때까지 3일을 기다리고 싶지 않으신가요? 여러 도구에서 사전 학습된 RAVE 모델을 사용해 볼 수 있습니다. 직접 학습한 모델도 불러올 수 있으며, 학습한 모델을 DAW에서 사용하는 방법 FAQ에 모델 유형별 플러그인이 정리되어 있습니다.
Neutone FX: RAVE 모델용 무료 VST/AU 플러그인
Neutone FX는 RAVE 모델을 실행하는 무료 VST/AU 플러그인입니다. 2022년에 출시된 최초의 Neutone 플러그인이며 현재는 개방형 플랫폼으로 유지 관리되고 있습니다. 설치하면 DAW(Ableton, Logic, Reaper 등)에서 여러 사전 학습 모델을 바로 불러올 수 있습니다.

IRCAM RAVE VST (베타, 보관 처리됨)
IRCAM은 자체 RAVE VST도 VST, AU 및 독립 실행형 빌드로 출시했습니다. DAW에서 들어오는 오디오를 처리하는 reconstruction 모드와 잠재 공간을 스스로 이동하며 소리를 생성하는 prior 모드가 있습니다. Model Explorer에서 사전 학습 모델을 다운로드할 수 있으며, 직접 만든 모델도 --stereo true로 내보내면 가져올 수 있습니다.
rave_vst 저장소는 2023년 6월에 보관 처리되었으므로 수정 업데이트를 기대하기는 어렵습니다. Windows에는 실험적인 독립 실행형 빌드만 있으며 M1 Mac 사용자는 직접 빌드해야 합니다. 개발진은 실시간 사용에 nn~를 권장합니다.
nn~를 통한 Max/MSP 및 Pure Data 연동
라이브 공연에서는 nn~ 외부 객체가 RAVE 모델을 Max/MSP와 Pure Data에 바로 불러옵니다. 잠재 공간을 직접 조작하거나 적응형 인스턴스 정규화로 스타일을 변환할 수 있습니다. 휴대용 설치 작업을 위해 Raspberry Pi 같은 임베디드 플랫폼에서도 실행됩니다. 같은 보드에서 ToobAmp와 Stompbox 같은 신경망 기타 앰프 플러그인도 실행할 수 있습니다. NVIDIA Jetson Nano 보드를 사용한다면 아날로그 오디오 출력이 없으므로 먼저 Raspiaudio Audio+ 같은 I2S 사운드 카드를 추가하세요.
RAVE 성능 한계와 기술적 주의 사항
RAVE를 본격적으로 사용하기 전에 다음 한계를 알아두세요.
- 지연: 인과 모드를 사용해도, 고급 Apple Silicon에서도 눈에 띄는 지연을 예상해야 합니다. 스튜디오에서는 괜찮지만 라이브 악기로 사용하기 전에는 신중히 테스트하세요.
- GPU 가속: 모델은 작은 컨볼루션을 많이 사용하며 연산보다 메모리 접근이 병목이므로 병렬화 효율이 낮습니다. 실시간 사용에서는 배치 처리를 하지 않는 한 GPU의 추가 처리 비용이 이점보다 큰 경우가 많습니다.
- 오디오 품질: RAVE의 소리는 인상적일 수 있지만 전통적인 합성이나 확산 기반 모델 같은 더 고급 신경망 모델의 충실도에는 미치지 못할 수 있습니다.
- 학습의 어려움: RAVE 모델 학습에는 머신 러닝과 오디오 처리 전문 지식, 강력한 하드웨어가 필요합니다.
RAVE 이후의 발전: Neutone Morpho와 AFTER 모델
Neutone Morpho: RAVE의 상용 발전형 (2024)
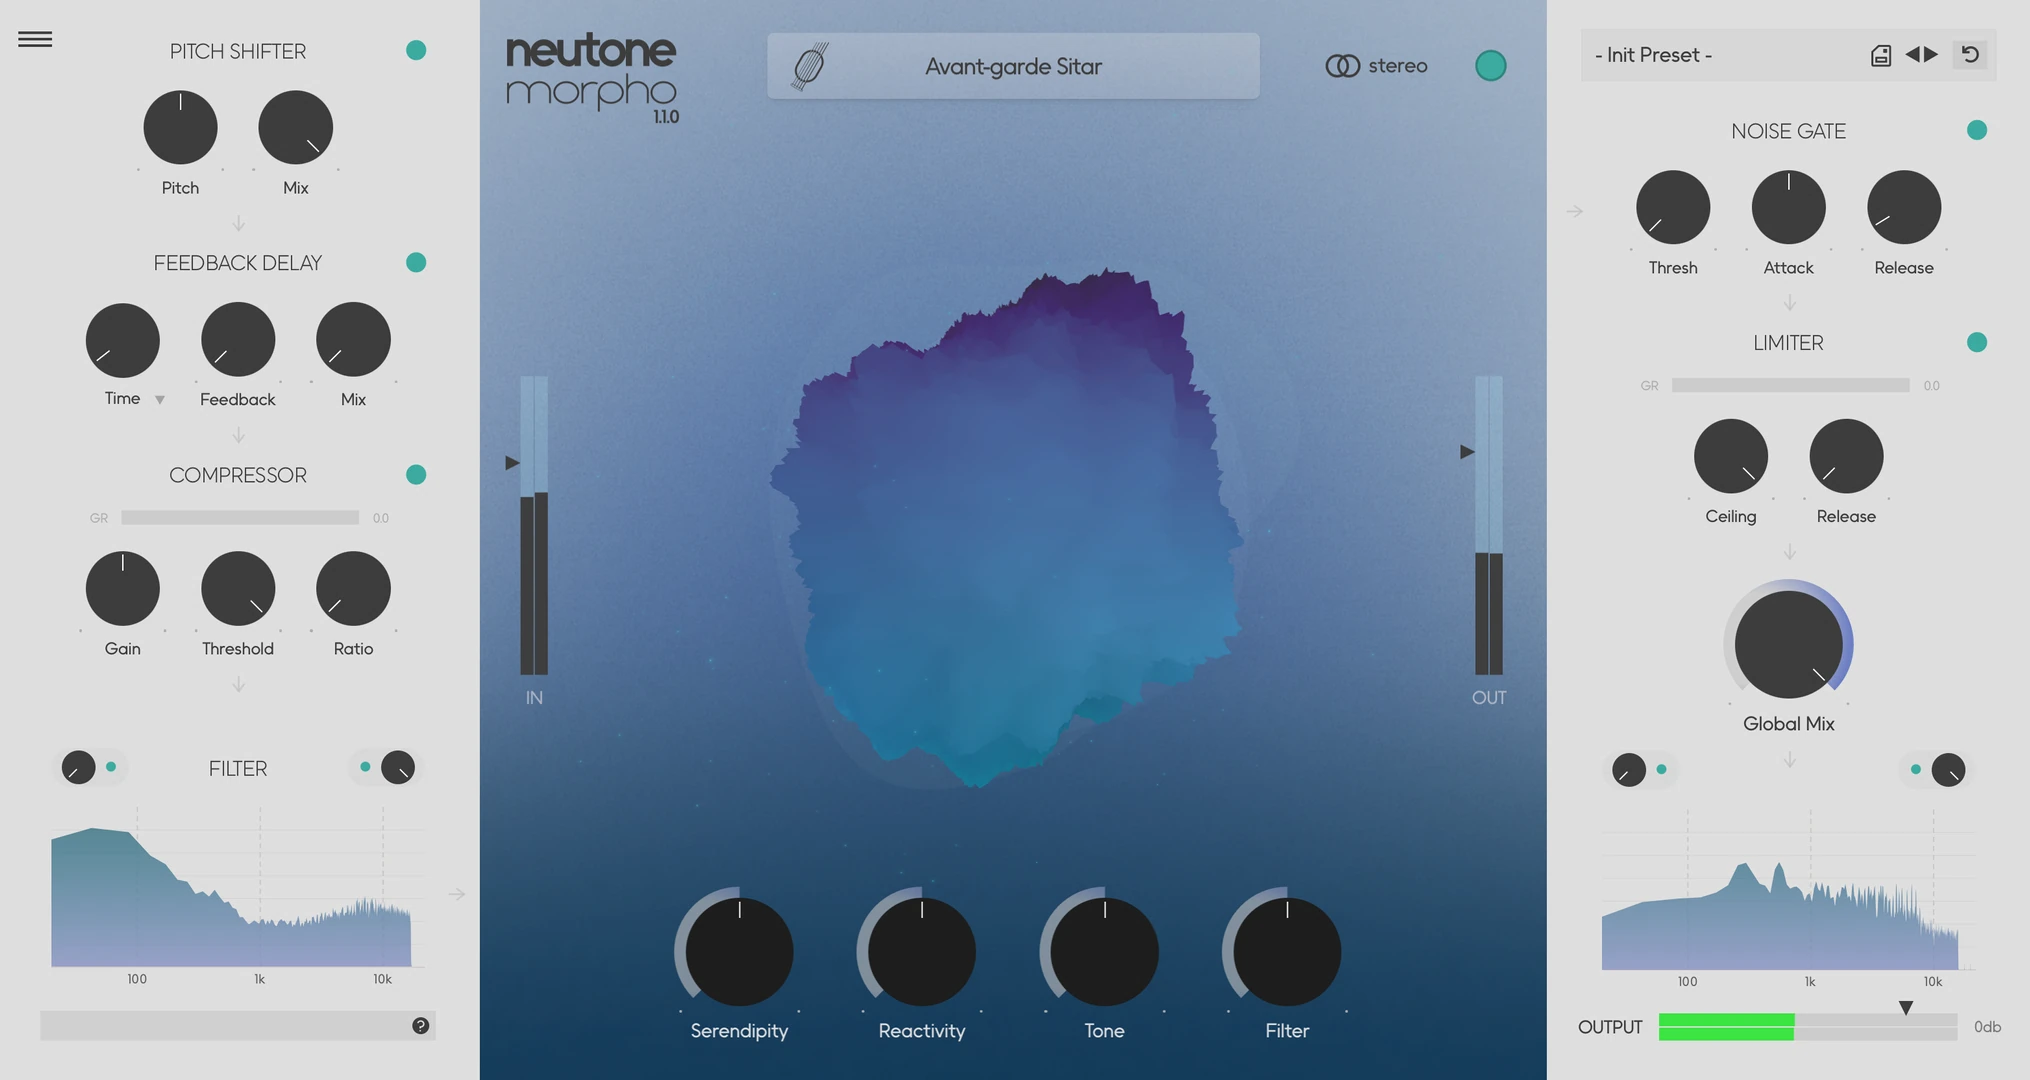
2024년 2월, Nao Tokui가 이끄는 Neutone 팀은 무료 FX 플러그인의 상용 후속 제품인 **Morpho**를 출시했습니다. RAVE는 오픈 소스 연구 엔진입니다. Morpho는 유사한 기술을 음악가와 프로듀서용으로 다듬은 제품에 담았지만, 그만큼 유연성은 줄어들었습니다.
AFTER 모델: IRCAM의 확산 기반 대안
같은 IRCAM ACIDS 팀은 확산 기반 모델인 AFTER(Audio Features Transfer and Exploration in Real-time)도 출시했습니다. 전통적인 신시사이저처럼 음색을 실시간으로 제어하며 더 쉽게 '조절'할 수 있도록 하는 것이 목표입니다.
소리 하나 대신 텍스트 프롬프트로 곡 전체의 스타일을 바꾸려면 AI 리믹스를 사용할 수 있습니다. 보컬 스템은 유지하고 Stable Audio 3로 반주를 새로 생성합니다.
RAVE 자주 묻는 질문
사전 학습된 RAVE 모델은 어디에서 다운로드하나요?
IRCAM의 공식 RAVE 모델 페이지에 스트리밍 모델이 나열되어 있습니다. Neutone FX와 RAVE VST에서도 플러그인 안에서 모델을 다운로드할 수 있습니다. 상업적으로 발매할 음악에 사용하기 전에 모델별 라이선스를 확인하세요.
RAVE 학습에는 오디오가 얼마나 필요한가요?
단일 음원에서 깨끗한 오디오 2~3시간 분량을 준비하세요. RAVE는 잡음과 공간 리버브를 포함해 녹음의 모든 것을 학습합니다. DDSP와 AFTER에 필요한 분량은 모델 학습에 필요한 데이터 양을 참고하세요.
Mac에서 RAVE를 학습할 수 있나요?
적합하지 않습니다. UAL Creative Computing Institute의 RAVE 가이드는 CUDA를 지원하는 NVIDIA GPU와 최소 8 GB 메모리를 요구하며 macOS 사용을 권장하지 않습니다. 대신 클라우드 GPU나 커뮤니티 Colab 노트북을 사용하세요.
Max에서 RAVE 모델에 클릭 소리가 나는 이유는 무엇인가요?
--streaming 없이 모델을 내보냈기 때문입니다. 이 플래그를 추가해 다시 내보내세요.
RAVE와 DDSP 중 무엇을 선택해야 하나요?
DDSP는 약 10분 분량의 오디오만 필요하지만 한 번에 하나의 음을 연주하는 유음고 악기만 모델링합니다. RAVE는 드럼, 목소리, 소리의 질감 등 어떤 소리든 처리하지만 몇 시간 분량의 오디오와 며칠의 학습 시간이 필요합니다.