Modelo RAVE do IRCAM: VST, modelos pré-treinados e treinamento
O modelo RAVE do IRCAM é um modelo neural de áudio em tempo real que transforma qualquer som no timbre com que foi treinado. Você pode tocar modelos RAVE pré-treinados na sua DAW com Neutone FX ou RAVE VST, carregá-los no Max/MSP ou Pure Data com nn~ ou treinar os seus com o pacote Python acids-rave.
Como usar o RAVE: início rápido
| Objetivo | Ferramenta | O que você precisa |
|---|---|---|
| Tocar modelos RAVE em uma DAW | Neutone FX (VST/AU gratuito) | Qualquer DAW. Os modelos pré-treinados são baixados dentro do plugin. |
| Tocar modelos RAVE em uma DAW | RAVE VST (beta) | Um download no IRCAM Forum. O repositório do código-fonte foi arquivado em junho de 2023, e sua versão Windows é apenas autônoma. |
| Usar o RAVE no Max/MSP ou Pure Data | Objeto externo nn~ | Max ou Pd e um arquivo de modelo .ts |
| Baixar modelos pré-treinados | Lista oficial de modelos RAVE | Exportações .ts em streaming para nn~ |
| Treinar seu próprio modelo | acids-rave em Python | Uma GPU NVIDIA com 5 a 32 GB de memória, algumas horas de áudio e cerca de 3 dias |
Para instalar o nn~, baixe a versão mais recente e extraia em Documents/Max [your version]/Packages/ para Max ou Documents/Pd/externals/ para Pure Data. Coloque seus modelos .ts na pasta nn_tilde/models.

O que é o RAVE do IRCAM para síntese de áudio em tempo real?
RAVE significa Realtime Audio Variational autoEncoder, ou autoencoder variacional de áudio em tempo real. Lançado no final de 2021 por pesquisadores do IRCAM em Paris, ele aprende a codificar sons em uma representação compacta e depois decodificá-los de volta em áudio. Pense nisso como ensinar um computador a esboçar o que ouve e depois redesenhar esse esboço como uma imitação convincente do som original.
Ele faz isso rápido o suficiente para funcionar em tempo real na sua DAW ou no seu equipamento de apresentação ao vivo.
Quem criou o RAVE e quando?
O RAVE foi desenvolvido por Antoine Caillon, que hoje trabalha no Google DeepMind, e Philippe Esling, da equipe ACIDS do IRCAM em Paris.
A equipe havia explorado o modelo DDSP (Differentiable Digital Signal Processing) do Google e o apresentado em março de 2021, mas queria um modelo mais flexível que pudesse lidar com qualquer tipo de som, não apenas instrumentos musicais.
O objetivo era um modelo que funcionasse em hardware comum e entregasse áudio com qualidade de estúdio. Eles o apresentaram no artigo de 2021, “RAVE: um autoencoder variacional para síntese neural de áudio rápida e de alta qualidade”.
Arquitetura do RAVE: como funciona este autoencoder variacional
O RAVE é um autoencoder: uma rede neural que aprende a comprimir dados em um “espaço latente” compacto e depois descomprimi-los.
RAVE: treinamento em duas etapas
Etapa 1: aprendizado de representações
Etapa 2: ajuste fino adversarial
Diagrama de treinamento adaptado do artigo original do RAVE. A etapa 1 treina o encoder e o decoder com uma perda espectral multibanda. A etapa 2 congela o encoder, bloqueia os gradientes através do código latente e treina o decoder e o discriminador. A análise e a síntese PQMF permanecem fixas.
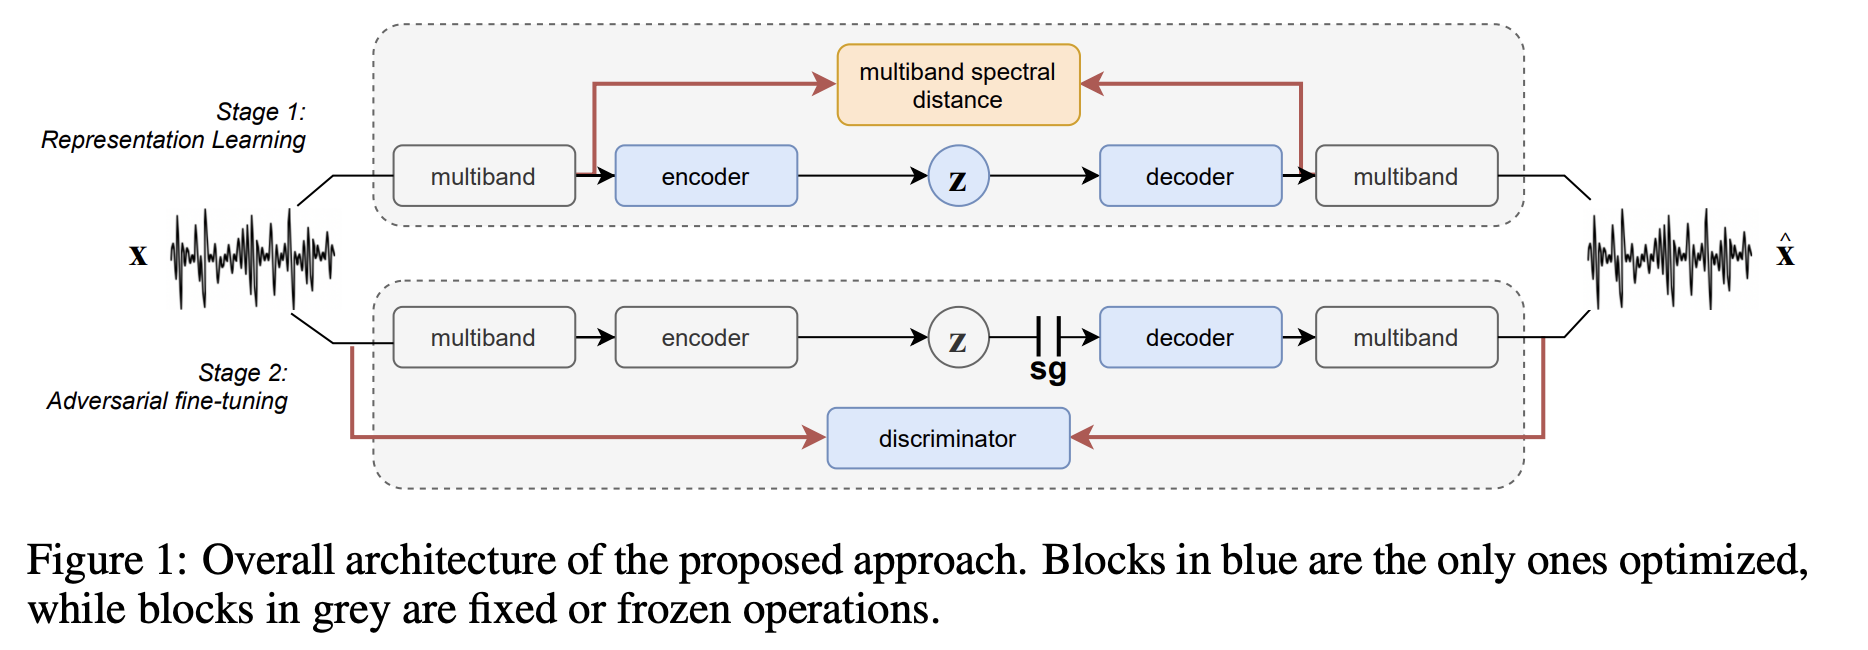
Figura original: RAVE: treinamento em duas etapas.
Como funciona o treinamento do RAVE em duas etapas
Pense nisso como treinar um músico em duas fases:
-
Fase 1: aprender a ouvir (aprendizado de representações)
- O encoder aprende a condensar o áudio em um conjunto compacto de números, o espaço latente
- O decoder aprende a reconstruir áudio a partir desses números
- O treinamento usa uma perda espectral que compara o conteúdo de frequências do áudio original e do reconstruído
-
Fase 2: aprender a improvisar (ajuste fino adversarial)
- O encoder é congelado, pois já sabe ouvir
- Uma rede “discriminadora” é adicionada: um crítico que julga se o áudio reconstruído soa real
- O decoder aprende com esse retorno a produzir áudio mais convincente
Principais componentes técnicos
- Filtros PQMF: o RAVE divide o áudio em várias sub-bandas de frequência antes do processamento, o que melhora a eficiência
- Modos causal e não causal: o modo causal troca parte da qualidade por menor latência em apresentações ao vivo
- Várias configurações: da leve "raspberry", que roda em um Raspberry Pi, à "v3", voltada à alta qualidade
Para detalhes da implementação, veja o repositório oficial do RAVE no GitHub, que inclui arquivos de configuração e definições dos modelos.

Como treinar modelos RAVE com seus próprios dados de áudio?
Quer um modelo que transforme sua voz em saxofone? Treinar um modelo RAVE exige conhecimento de Python e uma GPU. O repositório oficial do RAVE documenta o processo completo.
Requisitos para preparar o conjunto de dados
Para treinar um modelo RAVE, você precisa de:
- 2 a 3 horas de áudio limpo, quanto mais, melhor
- Gravações com qualidade de estúdio, pois o RAVE aprende tudo, incluindo ruído e reverberação
- Sons variados se você quer versatilidade
Para montar um conjunto de dados a partir de mixes completos, isole o instrumento primeiro com a separação de stems com IA em alta qualidade. Os artefatos de separação também acabam no modelo, então use os stems mais limpos que conseguir. O guia de separação de stems mostra como fazer isso no Neural Analog.
Instale o RAVE e prepare seu conjunto de dados
Instale PyTorch e TorchAudio para sua GPU primeiro e depois o RAVE. Você também precisa do FFmpeg; em um ambiente conda, instale com conda:
pip install acids-rave
conda install ffmpeg
O pré-processamento converte seus arquivos de áudio para o formato de conjunto de dados do RAVE:
rave preprocess --input_path /audio/folder --output_path /dataset/path --channels 1Use --channels 1 para mono ou --channels 2 para estéreo. Adicione --lazy para treinar diretamente em arquivos comprimidos como MP3, mas espere uma carga de CPU muito maior durante o treinamento. Para todos os parâmetros, veja a documentação de preparação de dados do RAVE.
Processo e configurações de treinamento do RAVE
Inicie o treinamento com um nome de configuração:
rave train --config v2 --db_path /dataset/path --out_path /model/out --name my_model --channels 1Escolha a configuração adequada à sua GPU. A memória mínima de GPU vem do README oficial:
| Configuração | Memória mínima de GPU | Uso |
|---|---|---|
raspberry | 5 GB | Modelo leve para tempo real em um Raspberry Pi 4 |
onnx | 6 GB | v1 sem ruído para exportação ONNX |
v1 | 8 GB | O modelo contínuo original |
v2_small | 8 GB | Transferência de timbre em sons estacionários |
v2 | 16 GB | O modelo contínuo melhorado e uma boa opção padrão |
discrete | 18 GB | Um modelo discreto semelhante a SoundStream ou EnCodec |
v3 | 32 GB | Maior qualidade, com transferência de estilo (AdaIN) |
Você pode combinar uma configuração com opções como causal para menor latência ou noise. Um notebook Colab da comunidade para RAVEv2, indicado no README, treina nas GPUs do Google se você não tem uma.
O que esperar durante o treinamento:
- Fase 1 (~1M passos): a qualidade do áudio começa ruim e melhora aos poucos
- Fase 2 (treinamento adversarial): a qualidade melhora bastante
- Tempo total: cerca de 3 dias em uma GPU RTX 3080
Os notebooks de treinamento do RAVE da comunidade explicam o processo passo a passo.
Exportar modelos RAVE para uso em tempo real
A exportação importa para o uso em tempo real. Use a opção --streaming para ativar convoluções em cache, o que evita artefatos de cliques:
rave export --run /path/to/your/run --streamingO resultado é um arquivo TorchScript .ts que o nn~ pode carregar. Para parâmetros de exportação e solução de problemas, veja a documentação de exportação do RAVE.
Inferência do RAVE e opções de uso em tempo real
Não quer esperar 3 dias de treinamento? Você pode experimentar modelos RAVE pré-treinados em várias ferramentas. Elas também carregam modelos que você treinou, e a FAQ sobre usar um modelo treinado na sua DAW lista o plugin para cada tipo de modelo.
Neutone FX: plugin VST/AU gratuito para modelos RAVE
O Neutone FX é um plugin VST/AU gratuito que hospeda modelos RAVE. É o plugin Neutone original de 2022, agora mantido como uma plataforma aberta. Instale para carregar uma coleção de modelos pré-treinados diretamente na sua DAW (Ableton, Logic, Reaper e outras).

RAVE VST do IRCAM, em beta e arquivado
O IRCAM também lançou seu próprio RAVE VST, com versões VST, AU e autônomas. Ele tem dois modos: reconstruction, que processa o áudio vindo da DAW, e prior, que gera som percorrendo o espaço latente por conta própria. Seu Model Explorer baixa modelos pré-treinados, e você pode importar os seus se os exportar com --stereo true.
O repositório rave_vst foi arquivado em junho de 2023, então não espere correções. No Windows, existe apenas uma versão autônoma experimental, e usuários de Mac M1 precisam compilá-la por conta própria. Os desenvolvedores recomendam o nn~ para uso em tempo real.
Integração com Max/MSP e Pure Data usando nn~
Para apresentações ao vivo, o objeto externo nn~ carrega modelos RAVE diretamente no Max/MSP e no Pure Data. Ele permite manipular diretamente o espaço latente e usar Adaptive Instance Normalization para transferência de estilo. Também roda em plataformas embarcadas como Raspberry Pi para instalações portáteis. As mesmas placas executam plugins neurais de amplificadores de guitarra como ToobAmp e Stompbox. Se sua placa é uma NVIDIA Jetson Nano, lembre que ela não tem saída de áudio analógica: adicione primeiro uma placa de som I2S como o Raspiaudio Audio+.
Limitações de desempenho e cuidados técnicos do RAVE
Conheça estas limitações antes de depender do RAVE:
- Latência: mesmo no modo causal, espere um atraso perceptível, até em Apple Silicon de alto desempenho. Isso pode servir no estúdio, mas teste com cuidado antes de usar o RAVE como instrumento ao vivo.
- Aceleração por GPU: o modelo usa muitas convoluções pequenas limitadas pelo acesso à memória, não pela capacidade de cálculo, e por isso não paraleliza bem. Para uso em tempo real, o custo adicional da GPU costuma superar o benefício, exceto no processamento em lote.
- Qualidade de áudio: o RAVE pode soar impressionante, mas talvez não alcance a fidelidade da síntese tradicional ou de modelos neurais mais avançados, como os baseados em difusão.
- Treinamento difícil: treinar um modelo RAVE exige experiência em aprendizado de máquina e processamento de áudio, além de hardware potente.
Depois do RAVE: Neutone Morpho e o modelo AFTER
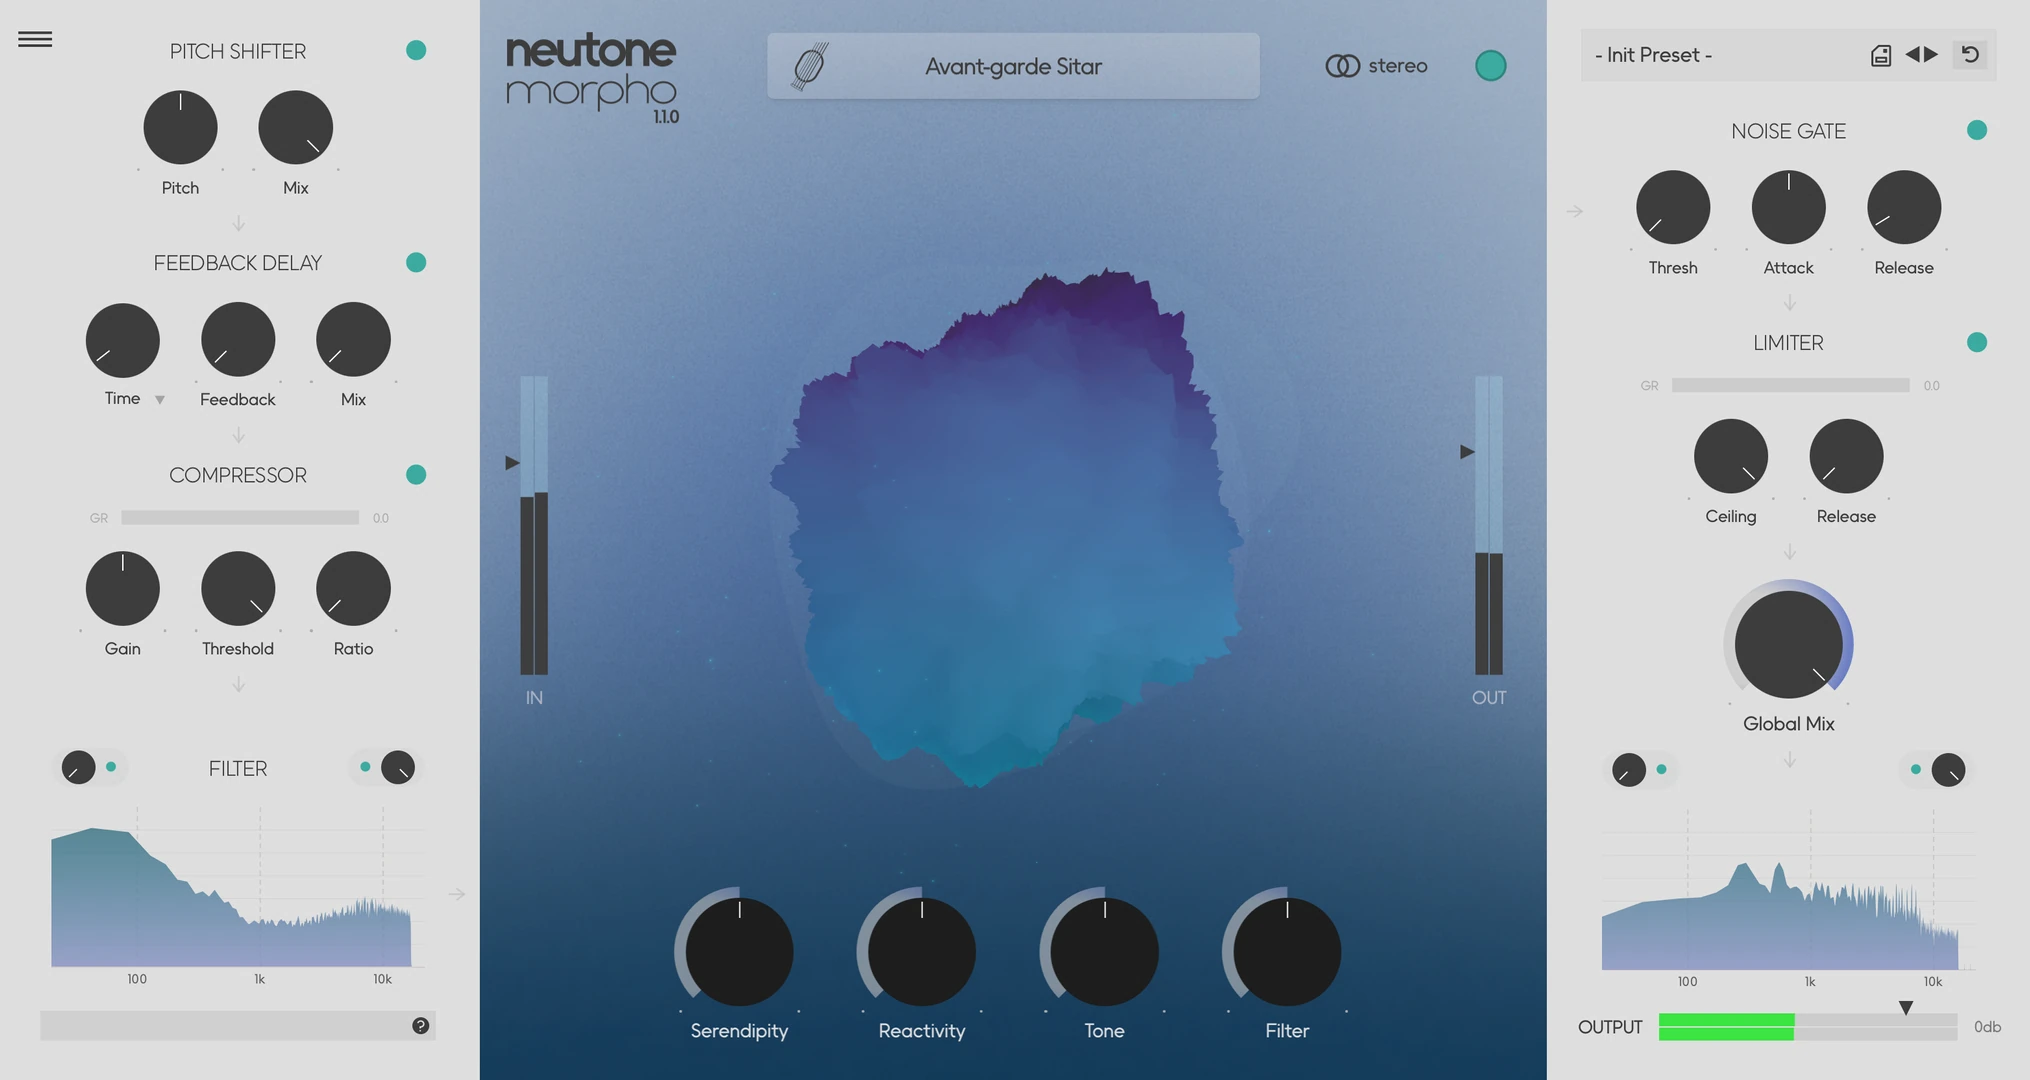
Neutone Morpho: evolução comercial do RAVE em 2024
Em fevereiro de 2024, a equipe Neutone liderada por Nao Tokui lançou o Morpho, um sucessor comercial do plugin FX gratuito. O RAVE é o mecanismo de código aberto voltado à pesquisa. O Morpho reúne tecnologia semelhante em um produto refinado para músicos e produtores, com menos flexibilidade.
Modelo AFTER: alternativa do IRCAM baseada em difusão
A mesma equipe IRCAM ACIDS também lançou o AFTER (Audio Features Transfer and Exploration in Real-time), um modelo baseado em difusão. Ele busca oferecer mais possibilidades de ajuste, com controle do timbre em tempo real como um sintetizador tradicional.
Para mudar o estilo de uma música inteira a partir de um prompt de texto, em vez de um único som, o remix de IA mantém o stem vocal e regenera o instrumental com Stable Audio 3.
Perguntas frequentes sobre o RAVE
Onde posso baixar modelos RAVE pré-treinados?
O IRCAM lista modelos em streaming na página oficial de modelos RAVE. Neutone FX e RAVE VST também podem baixar modelos de dentro do plugin. Confira a licença de cada modelo antes de usá-lo em um lançamento comercial.
De quanto áudio preciso para treinar o RAVE?
Planeje 2 a 3 horas de áudio limpo de uma única fonte. O RAVE aprende tudo nas gravações, incluindo ruído e reverberação da sala. Para os valores de DDSP e AFTER, veja quantos dados você precisa para treinar um modelo.
Posso treinar o RAVE em um Mac?
Não é uma boa opção. O guia de RAVE do UAL Creative Computing Institute pede uma GPU NVIDIA compatível com CUDA com pelo menos 8 GB de memória e desaconselha macOS. Use uma GPU na nuvem ou o notebook Colab da comunidade.
Por que meu modelo RAVE produz cliques no Max?
O modelo foi exportado sem --streaming. Exporte novamente com essa opção.
RAVE ou DDSP?
O DDSP precisa de apenas cerca de 10 minutos de áudio, mas só modela instrumentos monofônicos com altura definida. O RAVE lida com qualquer som, incluindo bateria, vozes e texturas, mas precisa de horas de áudio e dias de treinamento.