IRCAMのRAVEモデル:VST、学習済みモデルと学習方法
IRCAMのRAVEは、どのような音も学習データの音色に変換する実時間のニューラル音声モデルです。Neutone FXやRAVE VSTを使ってDAWで学習済みのRAVEモデルを演奏したり、nn~でMax/MSPやPure Dataに読み込んだりできます。acids-rave Pythonパッケージで自分のモデルを学習させることも可能です。
RAVEの使い方:クイックスタート
| 目的 | ツール | 必要なもの |
|---|---|---|
| DAWでRAVEモデルを演奏する | Neutone FX(無料のVST/AU) | 任意のDAW。学習済みモデルはプラグイン内でダウンロードできます。 |
| DAWでRAVEモデルを演奏する | RAVE VST(ベータ版) | IRCAM Forumからダウンロードします。ソースリポジトリは2023年6月にアーカイブされており、Windows版はスタンドアロンのみです。 |
| Max/MSPやPure DataでRAVEを使う | nn~外部オブジェクト | MaxまたはPdと、.tsモデルファイル |
| 学習済みモデルをダウンロードする | RAVE公式モデル一覧 | nn~用のストリーミング対応.ts書き出しファイル |
| 自分のモデルを学習させる | Pythonで動かすacids-rave | メモリ5〜32 GBのNVIDIA GPU、数時間分の音声、約3日 |
nn~をインストールするには、最新リリースをダウンロードして、MaxならDocuments/Max [your version]/Packages/、Pure DataならDocuments/Pd/externals/に展開します。.tsモデルはnn_tilde/modelsフォルダーに置いてください。

実時間音声合成に使うIRCAMのRAVEとは?
RAVEはRealtime Audio Variational autoEncoderの略で、実時間音声変分オートエンコーダーを意味します。パリのIRCAMの研究者が2021年末に発表したモデルで、音をコンパクトな表現に符号化し、それを再び音声に復号する方法を学びます。聞こえた音をコンピューターにスケッチさせ、そのスケッチを描き直すように、元の音をもっともらしく再現することを教えるイメージです。
十分に高速なため、DAWやライブ演奏のシステム内で実時間に動作します。
RAVEは誰がいつ開発したのですか?
RAVEを開発したのは、現在Google DeepMindに所属するAntoine Caillonと、パリのIRCAMのACIDSチームに所属するPhilippe Eslingです。
チームはそれ以前にGoogleのDDSP(Differentiable Digital Signal Processing、微分可能なデジタル信号処理)モデルを研究し、2021年3月にデモを披露していました。しかし、楽器だけでなく、どのような音も扱える柔軟なモデルを求めていました。
目標は、一般的なハードウェアで動きながらスタジオ品質の音声を出せるモデルでした。2021年の論文「RAVE:高速で高品質なニューラル音声合成のための変分オートエンコーダー」で発表しています。
RAVEの構造:変分オートエンコーダーの仕組み
RAVEはオートエンコーダーです。データをコンパクトな「潜在空間」に圧縮し、そこから再び展開する方法を学ぶニューラルネットワークです。
RAVE:2段階の学習
第1段階:表現学習
第2段階:敵対的ファインチューニング
RAVEの原論文をもとにした学習の図です。第1段階では、マルチバンドスペクトル損失を使ってエンコーダーとデコーダーを学習させます。第2段階ではエンコーダーを凍結し、潜在コードを通る勾配の伝播を止めて、デコーダーと識別器を学習させます。PQMFの分析と合成のフィルターバンクは固定したままです。
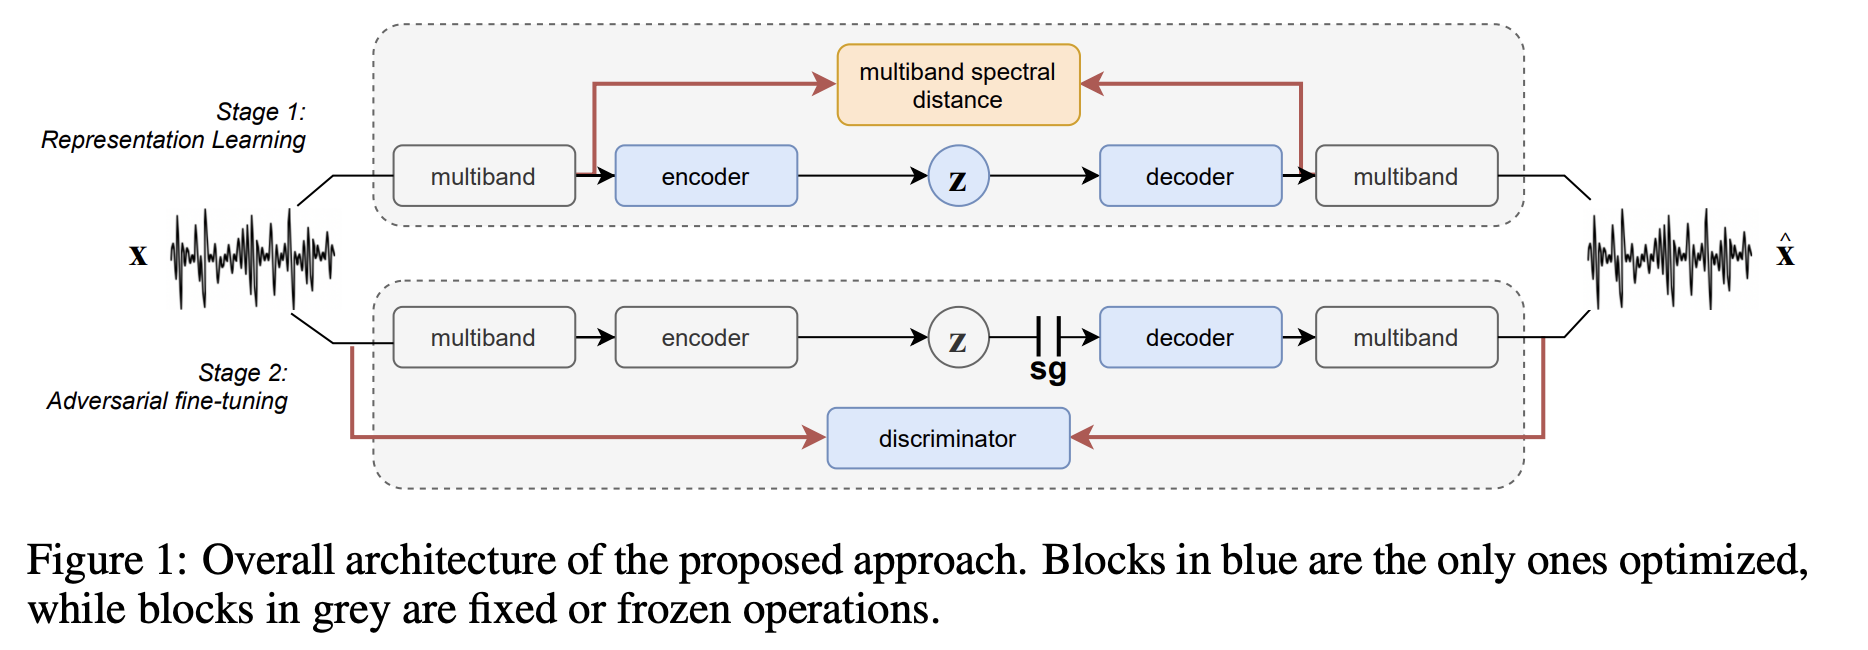
原図: RAVE:2段階の学習。
RAVEの2段階の学習はどう進むのでしょうか?
音楽家を2つの段階に分けて育てると考えてみてください。
-
第1段階:聴くことを学ぶ(表現学習)
- エンコーダーが音声を少数の数値、つまり潜在空間の表現に圧縮する方法を学びます
- デコーダーがその数値から音声を再構成する方法を学びます
- 学習には、元の音声と再構成した音声の周波数成分を比較するスペクトル損失を使います
-
第2段階:即興演奏を学ぶ(敵対的ファインチューニング)
- エンコーダーを凍結します。すでに聴く方法を学んでいるためです
- 再構成した音声が本物らしく聞こえるかを評価する、批評家の役割を持つ「識別器」ネットワークを追加します
- デコーダーがそのフィードバックから、より説得力のある音声を生成する方法を学びます
主な技術要素
- PQMFフィルター:RAVEは処理の前に音声を複数の周波数サブバンドに分け、効率を高めます
- 因果モードと非因果モード:因果モードでは、音質の一部と引き換えにライブ環境での遅延を抑えます
- 複数の構成:Raspberry Piで動作する軽量な「raspberry」から、高音質の「v3」まであります
実装の詳細は、設定ファイルとモデル定義を含むRAVE公式GitHubリポジトリを参照してください。

独自の音声データでRAVEモデルを学習させるには?
自分の声をサックスの音に変えるモデルを作りたいですか?RAVEモデルの学習にはPythonの知識とGPUが必要です。RAVE公式リポジトリに全手順が記載されています。
データセットの準備に必要なもの
RAVEモデルの学習には、次のものが必要です。
- 2〜3時間分のクリーンな音声(多いほど有利です)
- スタジオ品質の録音。RAVEはノイズやリバーブも含め、すべてを学習するためです
- 汎用性を持たせるなら多様な音
フルミックスからデータセットを作る場合は、まず高品質なAIステム分離で楽器を分離してください。分離のアーティファクトもモデルに学習されるため、できるだけクリーンなステムを使います。ステム分離ガイドでは、Neural Analogでの手順を紹介しています。
RAVEのインストールとデータセットの準備
まずGPUに対応したPyTorchとTorchAudioをインストールし、その後RAVEを入れます。FFmpegも必要です。conda環境ではcondaでインストールしてください。
pip install acids-rave
conda install ffmpeg
前処理で音声ファイルをRAVEのデータセット形式に変換します。
rave preprocess --input_path /audio/folder --output_path /dataset/path --channels 1モノラルは--channels 1、ステレオは--channels 2を使います。--lazyを追加すればMP3などの圧縮ファイルを直接使って学習できますが、学習中のCPU負荷は大幅に増えます。すべてのパラメーターはRAVEのデータセット準備ドキュメントを参照してください。
RAVEの学習過程と構成
構成名を指定して学習を開始します。
rave train --config v2 --db_path /dataset/path --out_path /model/out --name my_model --channels 1GPUに合う構成を選んでください。最低GPUメモリ要件は公式READMEに基づいています。
| 構成 | 最低GPUメモリ | 用途 |
|---|---|---|
raspberry | 5 GB | Raspberry Pi 4で実時間に動作する軽量モデル |
onnx | 6 GB | ONNX書き出し用のノイズなしv1 |
v1 | 8 GB | 最初の連続型モデル |
v2_small | 8 GB | 定常的な音の音色変換 |
v2 | 16 GB | 改良された連続型モデルで、標準の選択肢として適しています |
discrete | 18 GB | SoundStreamやEnCodecに似た離散型モデル |
v3 | 32 GB | 最高音質で、スタイル変換(AdaIN)に対応 |
構成にcausal(低遅延)やnoiseなどのオプションを組み合わせられます。GPUがない場合は、READMEからリンクされているコミュニティのRAVEv2用ColabノートブックでGoogleのGPUを使って学習できます。
学習中の変化と所要時間:
- 第1段階(約100万ステップ):最初は粗い音質ですが、徐々に改善します
- 第2段階(敵対的学習):音質が大きく改善します
- 合計時間:RTX 3080 GPUで約3日
コミュニティが提供するRAVE学習ノートブックで、手順を順番に確認できます。
実時間利用に向けたRAVEモデルの書き出し
実時間利用では書き出し方が重要です。--streamingフラグを使うと、キャッシュされた畳み込みを有効にしてクリック状のアーティファクトを防げます。
rave export --run /path/to/your/run --streaming出力はnn~で読み込めるTorchScriptの.tsファイルです。書き出しパラメーターとトラブル対処については、RAVEの書き出しドキュメントを参照してください。
RAVEモデルの推論と実時間利用の選択肢
学習のために3日も待ちたくないですか?学習済みのRAVEモデルは、複数のツールで試せます。自分で学習させたモデルも読み込めます。学習したモデルをDAWで使う方法のFAQには、モデルの種類別に使えるプラグインが載っています。
Neutone FX:RAVEモデル用の無料VST/AUプラグイン
Neutone FXはRAVEモデルを動かす無料のVST/AUプラグインです。2022年に登場した最初のNeutoneプラグインで、現在はオープンなプラットフォームとして保守されています。インストールすれば、DAW(Ableton、Logic、Reaperなど)から学習済みモデルのコレクションを直接読み込めます。

IRCAMのRAVE VST(ベータ版、アーカイブ済み)
IRCAMも独自のRAVE VSTを公開しており、VST、AU、スタンドアロン版があります。モードは2つです。reconstructionはDAWからの音声を処理し、priorは潜在空間を自動的に移動して音を生成します。Model Explorerで学習済みモデルをダウンロードでき、--stereo trueで書き出せば自分のモデルも読み込めます。
rave_vstリポジトリは2023年6月にアーカイブされているため、修正は期待できません。Windowsには実験的なスタンドアロン版しかなく、M1 Macのユーザーは自分でビルドする必要があります。開発者は実時間利用にはnn~を推奨しています。
nn~でMax/MSPとPure Dataを連携させる
ライブ演奏では、nn~外部オブジェクトを使ってRAVEモデルをMax/MSPやPure Dataに直接読み込めます。潜在空間を直接操作し、適応的インスタンス正規化でスタイルを変換できます。Raspberry Piなどの組み込みプラットフォームでも動くため、持ち運べるインスタレーションにも使えます。同じボードではToobAmpやStompboxなどのニューラルギターアンププラグインも動作します。NVIDIA Jetson Nanoにはアナログ音声出力がないため、使う場合はまずRaspiaudio Audio+などのI2Sサウンドカードを追加してください。
RAVEの性能上の限界と技術的な注意点
RAVEを本格的に使う前に、次の制約を把握しておきましょう。
- 遅延:因果モードでも、ハイエンドのApple Siliconでも、はっきり分かる遅延があると考えてください。スタジオでは問題にならなくても、ライブ楽器として使う前には慎重にテストする必要があります。
- GPUアクセラレーション:モデルは小さな畳み込みを多数使い、計算量よりメモリアクセスがボトルネックになるため、並列化の効率がよくありません。実時間利用では、バッチ処理をする場合を除き、GPUのオーバーヘッドが利点を上回ることが多くあります。
- 音質:RAVEは印象的な音を出せますが、従来の合成や拡散型などの高度なニューラルモデルと同等の忠実度に達するとは限りません。
- 学習の難しさ:RAVEモデルの学習には、機械学習と音声処理の専門知識に加え、強力なハードウェアが必要です。
RAVEの後継技術:Neutone MorphoとAFTERモデル
Neutone Morpho:RAVEの商用発展形(2024年)
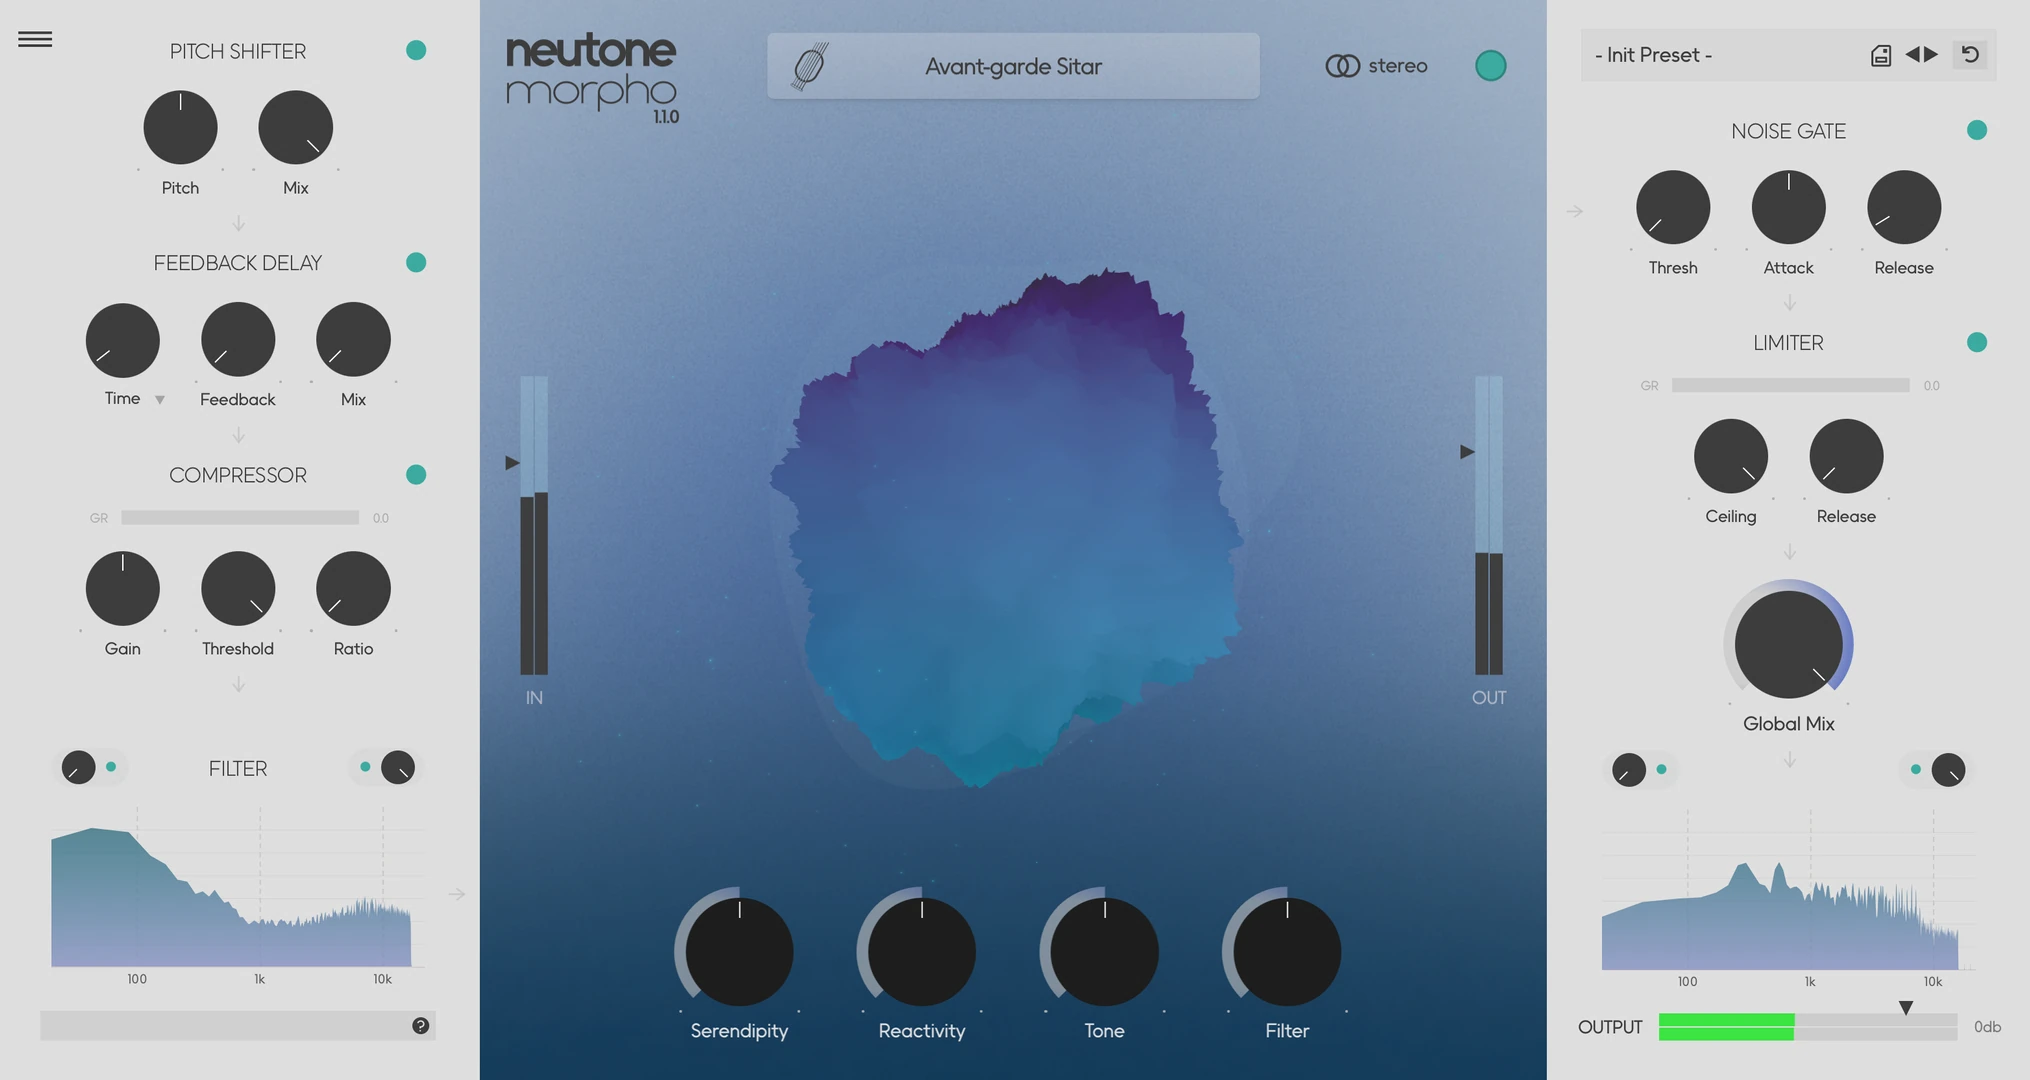
2024年2月、Nao Tokuiが率いるNeutoneチームは、無料のFXプラグインの商用後継製品として**Morpho**を公開しました。RAVEはオープンソースの研究エンジンです。Morphoは同様の技術を、音楽家やプロデューサー向けに仕上げた製品として提供する一方、柔軟性は低くなっています。
AFTERモデル:IRCAMの拡散型の代替モデル
同じIRCAM ACIDSチームは、拡散型モデルのAFTER(Audio Features Transfer and Exploration in Real-time)も公開しています。従来のシンセサイザーのように音色を実時間で制御でき、より「調整しやすい」モデルを目指しています。
1つの音ではなく、テキストプロンプトで曲全体のスタイルを変えたい場合は、AIリミックスがボーカルステムを保ち、Stable Audio 3で伴奏を再生成します。
RAVEのよくある質問
学習済みのRAVEモデルはどこでダウンロードできますか?
IRCAMはRAVE公式モデルページにストリーミングモデルを掲載しています。Neutone FXやRAVE VSTでもプラグイン内からモデルをダウンロードできます。商用リリースに使う前に、各モデルのライセンスを確認してください。
RAVEの学習にはどれくらいの音声が必要ですか?
単一の音源から、2〜3時間分のクリーンな音声を用意してください。RAVEはノイズや部屋のリバーブなど、録音に含まれるすべてを学習します。DDSPとAFTERの必要量は、モデルの学習に必要なデータ量を参照してください。
MacでRAVEを学習させられますか?
適していません。UAL Creative Computing InstituteのRAVEガイドは、CUDA対応のNVIDIA GPUと最低8 GBのメモリを必要とし、macOSの利用は勧めていません。代わりにクラウドGPUやコミュニティのColabノートブックを使ってください。
MaxでRAVEモデルにクリック音が出るのはなぜですか?
--streamingを付けずにモデルを書き出したためです。このフラグを付けて、再度書き出してください。
RAVEとDDSPのどちらを選べばよいですか?
DDSPは約10分の音声だけで学習できますが、音高を持ち、1度に1つの音を鳴らす単音楽器しかモデル化できません。RAVEはドラム、声、音のテクスチャーなど、どのような音も扱えますが、数時間分の音声と数日の学習が必要です。