DDSPガイド:Magenta DDSP VST、学習と仕組み
DDSP(微分可能なデジタル信号処理)はGoogle Magentaのオープンソースライブラリです。ニューラルネットワークが、オシレーター、フィルター処理したノイズ、リバーブといった従来の音源を制御します。Magentaは2024年にDDSP VSTをアーカイブしましたが、無料プラグインは現在もダウンロードでき、WindowsとmacOSで動作します。無料のGoogle Colabノートブックで、自分の楽器モデルを学習することもできます。
このガイドは、まずこの二つの実践的な手順から始めます。その後、DDSPの仕組み、限界、そして後を継いだ新しいモデルを説明します。
今からDDSPを使う:クイックスタート
DDSP VSTをダウンロードして導入する
- macOSまたはWindows用プラグインをダウンロードします。どちらも公式DDSP VSTリポジトリのリンクです。
- ファイルを展開します。入力音声、たとえば自分の声を楽器音に変えるDDSP Effectと、MIDIで演奏するDDSP Synthの二つが含まれています。
- macOSでは
/Library/Audio/Plug-Ins/Components(AU)と/Library/Audio/Plug-Ins/VST3へコピーします。WindowsではVST3ファイルをC:\Program Files\Common Files\VST3へコピーします。 - DAWでプラグインを再スキャンします。
公式のLinuxビルドはありません。何も導入せずDDSPを聴いてみるなら、Tone Transferのウェブデモをお試しください。
自分のDDSP楽器を学習する
MagentaのDDSP VST学習ノートブックはGoogle Colabで動くため、手元のGPUは不要です。
- Google Driveのフォルダーに、
.wavまたは.mp3の音声を最低10分入れます。同じマイク、同じ部屋で、一回の録音セッションから得た単音の音声を使ってください。一度に一つの音だけを鳴らす録音です。 - ノートブックを開き、インストール用セルを実行します(約5分)。その後、学習用セルを実行してフォルダーを選びます。
- 完了を待ちます。学習には無料Colabで約2〜3時間、Colab Pro+では1時間未満かかります。Colabが切断されたら、同じフォルダーでセルを再実行すると学習が再開します。
- ダウンロードしたモデルフォルダーをプラグインのモデルフォルダーへ展開します。Macでは
~/Documents/Magenta/DDSP/Modelsです。プラグイン内から開くこともできます。
ノートブックによると、良い結果が出るのは通常30,000〜50,000学習ステップ後です。少なすぎると平板な音になり、多すぎると音が途切れたり音量が大きく跳ねたりする場合があります。
歴史と進化:Magentaから現在のプラグインへ
Magenta研究室(2016〜2024年)
GoogleのMagentaは、音楽とアートのための機械学習を研究するオープンソースプロジェクトとして2016年に始まりました。多くの音楽生成ツールを公開しましたが、2024年までに大半のプロジェクトがアーカイブされました。
Open NSynth Super(2017年)
DDSP以前、MagentaはNSynthを中心に構築したハードウェア楽器、Open NSynth Superを発表しました。NSynthデータセットには、1,006の楽器から得た約305,000個の単音サンプルがあります。Raspberry Piと独自のPCBを使ったこの機器では、楽器の音色間をリアルタイムでモーフィングしながら演奏できました。
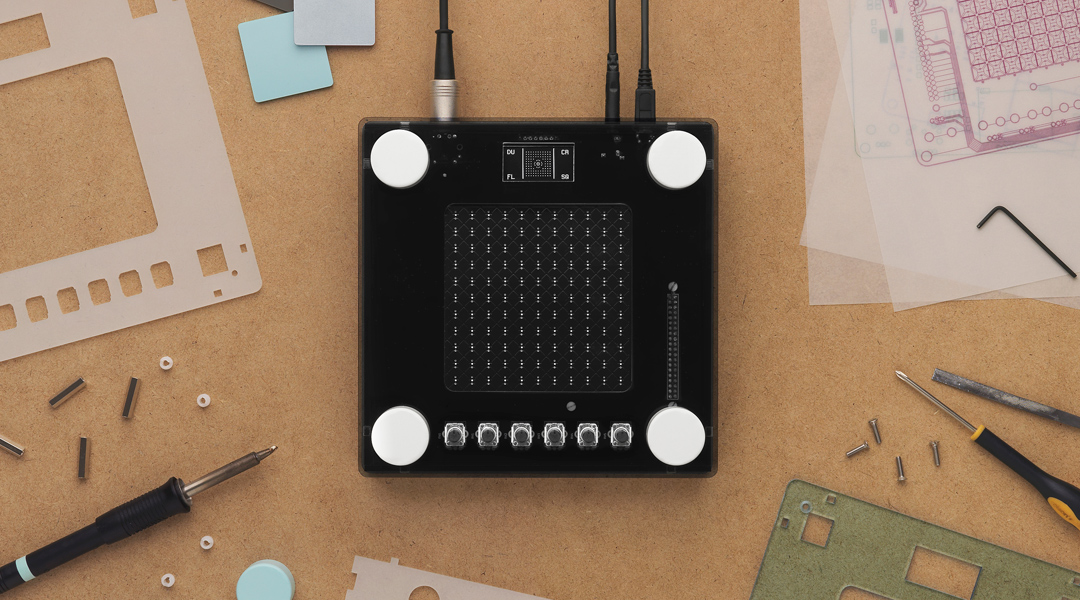
WaveNet型のオートエンコーダーであるNSynthモデルは、計算コストのため16-bit/16 kHzの音声に制限され、出力は明らかにローファイに聴こえます。音声エンジニアのJoe Bostonは「粒の粗い」音と評しつつ、外部エフェクトを通すことで創作に活用しました。ハードウェアのプロジェクトは2025年8月にアーカイブされました。
DDSPとTone Transfer(2020年)
2020年、Magentaは一般的な信号処理モジュールの微分可能な実装を紹介するDDSPライブラリとICLR論文を公開しました。Tone Transferのウェブデモでは、歌声などの録音をバイオリン、サックス、トランペット、フルートの音に変えられました。
モデルは、楽器ごとに約10分の単音音声で学習したRNNベースのオートエンコーダーです。デモは動作しましたが、16 kHzの出力と限定的な奏法のモデル化が制約でした。
MIDI DDSPとVSTプラグイン(2022〜2024年)
Magentaは2022年1月にMIDI DDSPでDDSPを拡張しました。単音のMIDIシーケンスから楽器の音声を直接合成します。ニューラルモデルではなく録音サンプルでMIDIを鳴らすなら、無料のsforzandoプレーヤーでSFZ楽器を読み込んでください。
2022年6月には、DAW内でリアルタイムに音色変換するDDSP VSTプラグインを公開しました。どちらも2024年にアーカイブされ、MIDI DDSPは2月、VSTは10月でした。

MAWF音声プラグイン(2023年)
Tone Transferの元技術責任者で、2020年からByteDanceに在籍するHanoi Hantrakul(yaboihanoi)は、2023年にMAWFを公開しました。この無料VST/AUプラグインは48 kHzのリアルタイムニューラル音声合成を行い、初期のDDSP実装にあった16 kHzの制限を解消しました。

DDSPの仕組み:オートエンコーダーとDSPを組み合わせる
DDSPは、デコーダーが波形を直接生成する代わりに、モジュール式のDSPコンポーネントを駆動するオートエンコーダーです。
DDSPオートエンコーダーの構成
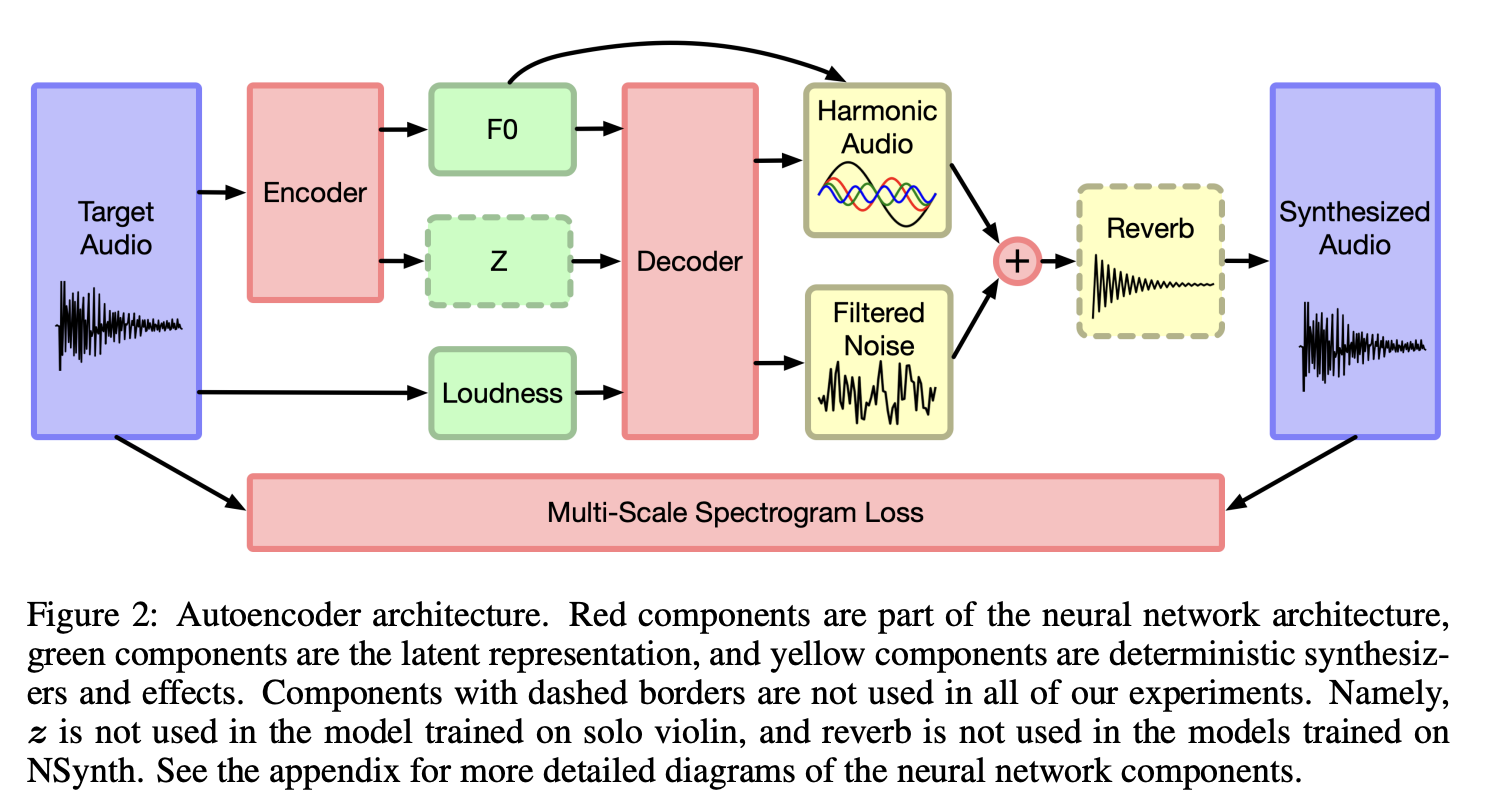
原図: DDSPオートエンコーダーの構成。
エンコーダー
エンコーダーは入力音声を二つの制御曲線に変えます。**基本周波数(f0、音高)**は事前学習済みのCREPE音高推定器で推定し、ラウドネスは信号から直接計算します。任意の残差エンコーダー(MFCC列に適用するGRU)は、音高とラウドネスでは捉えられない音色の細部を表す潜在ベクトルを加えます。これらの低次元信号が演奏を表します。
デコーダーと合成モジュール
再帰型デコーダー(GRU)は、制御信号を三つのDSPコンポーネントのパラメーターへ変換します。
- 倍音加算シンセサイザー:基本周波数の整数倍で最大100個の正弦波部分音を生成し、音高を持つ成分を作ります。
- フィルター処理したノイズのシンセサイザー:時間変化するFIRフィルターで白色ノイズを整え、息や弓の摩擦音をモデル化します。
- 微分可能なリバーブ:学習したインパルス応答で部屋の音響を加えます。
各コンポーネントが微分可能なので、モデル全体をマルチスケールスペクトル損失でエンドツーエンドに学習できます。サンプルごとに音声を生成せず、フレームごとに数百の合成パラメーターを予測します。
研究用DDSPモデルの学習
DDSP VSTで演奏するモデルには、冒頭のクイックスタートで紹介したDDSP VST学習ノートブックを使ってください。構成や損失を変更するなら、ライブラリのColabチュートリアルから始めます。Pythonの基礎知識が必要で、前処理、設定、Colab GPUでの学習を扱います。
リアルタイムで使えるDDSPプラグイン
Magentaの公式プロジェクトはアーカイブ済みですが、以下のツールで今もDAW内でDDSPを動かせます。
1. Magenta DDSP VST(アーカイブ済み)
公式DDSP VSTは、実験用に今も動作します。導入手順は冒頭のクイックスタートをご覧ください。五つの楽器モデルを含み、MIDIと音声の両方を入力できます。ユーザーからは出力のリバーブが強く、アーティファクトを隠しているようだと報告されています。
2. Neutone FXプラットフォーム
Neutone FXは、DDSPベースの音色変換ネットワークなど、コミュニティが学習したモデルを動かす無料プラグインを提供します。Magentaの元の楽器だけでなく、数十のモデルを使えます。

3. yaboihanoiのMAWF(推奨)
MAWFプラグインは、DAW内で48 kHzのDDSP合成を実行します。複数の楽器モデルが付属し、最も完成度の高いDDSP実装です。

ただし、MAWFのダウンロードサイトは2025年11月から停止しています。別の入手先が見つかったら、この記事を更新します。
DDSPの限界は?
DDSPの限界は、その構成と合成方法に由来します。
- 単音のみ:DDSPモデルはポリフォニックな音声を生成できません。単音録音で学習し、倍音シンセサイザーは各時点で一つの基本周波数だけを想定しています。
- 音質:MAWFの48 kHzモデルは改善されていますが、初期の16 kHz実装は金属的なアーティファクトがあり、高域が乏しい音です。音声の超解像モデルで古いレンダリングの欠落した高域を再生成できます。GitHubからAudioSRを導入して実行する方法、またはUniverSRが22 kHzのRPG Maker効果音を48 kHzへ修復した例をご覧ください。
- GPU並列化の制限:再帰層がフレームを順番に処理するため、畳み込みモデルのようにGPU上で時間方向に並列化できません。
DDSPの先へ:RAVE、DDSP-CNN-Tiny、AFTER
RAVE(2021年)
RAVEはRNNではなく因果的CNNを使い、高速な学習と48 kHz合成に加え、音色のモデル化を改善します。敵対的学習(識別器)で調整する変分オートエンコーダーで、同程度のデータ量から高い忠実度を実現します。
DDSP-CNN-Tiny(2022年)
DDSP-CNN-TinyはDDSPのRNNを軽量なCNNに置き換え、モデルを小さくして推論を高速化します。音質を同程度に保ち、CPUでリアルタイム動作します。NAMやAIDA-Xなどの無料ニューラルギターアンププラグインも、小さなネットワークをCPUで動かします。Václav VolhejnがETH Zurichでの学位論文のために開発したもので、リアルタイムDDSPに関する彼の論文は優れた技術資料です。
AFTER(2024年)
AFTERモデルは、ニューラル音声コーデック上で潜在拡散を実行し、スタジオ品質の音声合成を実現します。DDSPより計算負荷は重いものの、音色変換のアーティファクトは大幅に少なく、プロの制作に適しています。
DDSPのFAQ
Magenta DDSPは今も保守されている?
一部は保守されています。ddspライブラリはアーカイブされておらず、現在もコミットがあります。Magentaは2024年2月にMIDI DDSP、2024年10月にDDSP VSTをアーカイブしたため、プラグインに更新はありません。このガイドを2026年10月に更新した時点では、プラグインのダウンロードと学習ノートブックはまだ動作していました。
DDSP VSTはLinuxで使える?
公式のLinuxビルドはありません。ソースコードから自分でビルドする必要があります。
DDSPで和音を演奏できる?
できません。DDSPモデルは単音で、一度に一つの音高を追跡します。ポリフォニックなMIDI制御にはAFTERを検討してください。
DDSPとRAVE、どちらを学習するべき?
約10分の音声と無料Colab GPUしかなく、音高のある一種類の楽器を対象にするならDDSPを選んでください。ドラム、テクスチャー、声などあらゆる音にはRAVEを選びます。RAVEには数時間分の音声と数日間のGPU学習が必要です。FAQでは、DDSP、RAVE、AFTERに必要な学習音声量と、DAW内で各学習済みモデルを演奏するプラグインを比較しています。