Guía DDSP: VST Magenta DDSP, entrenamiento y funcionamiento
DDSP (procesamiento digital de señales diferenciable, por Differentiable Digital Signal Processing) es la biblioteca de código abierto de Google Magenta que permite a una red neuronal controlar generadores de sonido clásicos: osciladores, ruido filtrado y reverberación. Magenta archivó el VST DDSP en 2024, pero el plugin gratuito todavía se puede descargar y ejecutar en Windows y macOS. También puedes entrenar tu propio modelo de instrumento en un cuaderno gratuito de Google Colab.
Esta guía comienza con esos dos pasos prácticos. Después explica cómo funciona DDSP, cuáles son sus limitaciones y qué modelos más recientes lo sustituyeron.
Cómo usar DDSP hoy: inicio rápido
Descargar e instalar el VST DDSP
- Descarga el plugin para macOS o Windows. Ambos enlaces proceden del repositorio oficial del VST DDSP.
- Descomprime el archivo. Contiene dos plugins: DDSP Effect, que convierte el audio entrante, como tu voz, en el sonido de un instrumento, y DDSP Synth, que se toca mediante MIDI.
- En macOS, cópialos a
/Library/Audio/Plug-Ins/Components(AU) y/Library/Audio/Plug-Ins/VST3. En Windows, copia los archivos VST3 aC:\Program Files\Common Files\VST3. - Vuelve a buscar los plugins en tu DAW.
No hay una versión oficial para Linux. Para escuchar DDSP sin instalar nada, prueba la demo web de Tone Transfer.
Entrenar tu propio instrumento DDSP
El cuaderno de entrenamiento del VST DDSP de Magenta se ejecuta en Google Colab, por lo que no necesitas una GPU local:
- Coloca al menos 10 minutos de audio
.wavo.mp3en una carpeta de Google Drive. Usa audio monofónico, una nota cada vez, de una misma sesión de grabación, con el mismo micrófono y en la misma sala. - Abre el cuaderno, ejecuta la celda de instalación, que tarda unos 5 minutos, y después ejecuta la celda de entrenamiento y selecciona tu carpeta.
- Espera. El entrenamiento tarda unas 2 a 3 horas en Colab gratuito y menos de una hora en Colab Pro+. Si Colab se desconecta, vuelve a ejecutar la celda con la misma carpeta para reanudar el entrenamiento.
- Descomprime la carpeta del modelo descargado en la carpeta de modelos del plugin. En Mac está en
~/Documents/Magenta/DDSP/Models, y también puedes abrirla desde el propio plugin.
El cuaderno indica que los buenos resultados suelen aparecer después de 30 000 a 50 000 pasos de entrenamiento. Con pocos pasos, el sonido resulta poco expresivo; con demasiados, puede volverse entrecortado y presentar grandes saltos de volumen.
Historia y evolución: de Magenta a los plugins actuales
El laboratorio de investigación Magenta (2016-2024)
Google lanzó Magenta en 2016 como proyecto de investigación de código abierto sobre aprendizaje automático para la música y el arte. Publicó muchas herramientas de generación musical, pero la mayoría de sus proyectos ya estaban archivados en 2024.
Open NSynth Super (2017)
Antes de DDSP, Magenta presentó Open NSynth Super, un instrumento físico basado en NSynth. El conjunto de datos NSynth contiene unas 305 000 muestras de notas individuales de 1006 instrumentos. El dispositivo, construido con una Raspberry Pi y una placa de circuito impreso personalizada, permitía transformar gradualmente el sonido entre distintos instrumentos en tiempo real.
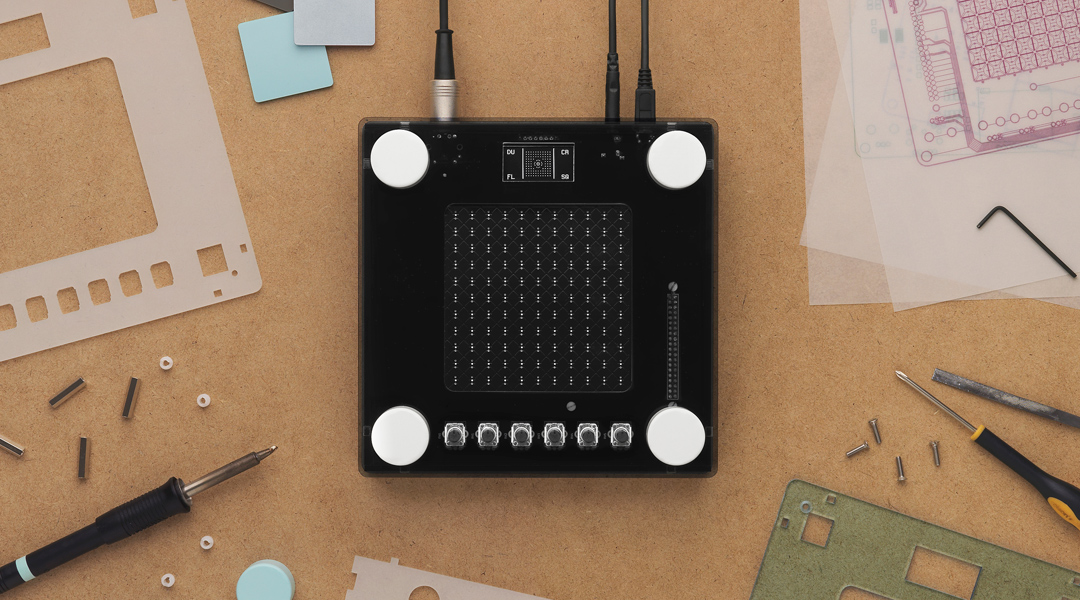
El modelo NSynth, un autoencoder de tipo WaveNet, estaba limitado a audio de 16 bits/16 kHz por su coste computacional, de modo que el resultado tiene un sonido claramente lo-fi. El ingeniero de sonido Joe Boston lo describió como «granulado», aunque encontró usos creativos al procesarlo con efectos externos. El proyecto de hardware se archivó en agosto de 2025.
DDSP y Tone Transfer (2020)
En 2020, Magenta publicó la biblioteca DDSP y su artículo de ICLR, que introdujo versiones diferenciables de módulos habituales de procesamiento de señales. La demo web de Tone Transfer permitía convertir grabaciones, como una voz cantada, en violín, saxofón, trompeta o flauta.
Los modelos eran autoencoders basados en RNN, entrenados con unos 10 minutos de audio monofónico por instrumento. La demo funcionaba, pero la salida a 16 kHz y el modelado limitado de las articulaciones restringían sus posibilidades.
MIDI DDSP y el plugin VST (2022-2024)
Magenta amplió DDSP con MIDI DDSP en enero de 2022. Sintetiza audio instrumental directamente a partir de secuencias MIDI monofónicas. Para tocar muestras grabadas mediante MIDI en lugar de usar un modelo neuronal, carga un instrumento SFZ en el reproductor gratuito sforzando.
En junio de 2022, Magenta publicó el plugin VST DDSP para transferir timbre en tiempo real dentro de un DAW. Ambos proyectos se archivaron en 2024: MIDI DDSP en febrero y el VST en octubre.

El plugin de audio MAWF (2023)
Hanoi Hantrakul (yaboihanoi), antiguo responsable técnico de Tone Transfer y en ByteDance desde 2020, lanzó MAWF en 2023. Este plugin gratuito VST/AU ejecuta síntesis de audio neuronal en tiempo real a 48 kHz, eliminando el límite de 16 kHz de las primeras implementaciones de DDSP.

¿Cómo funciona DDSP? Autoencoders y DSP
DDSP es un autoencoder cuyo decodificador controla componentes DSP modulares en lugar de generar directamente la forma de onda.
Arquitectura del autoencoder DDSP
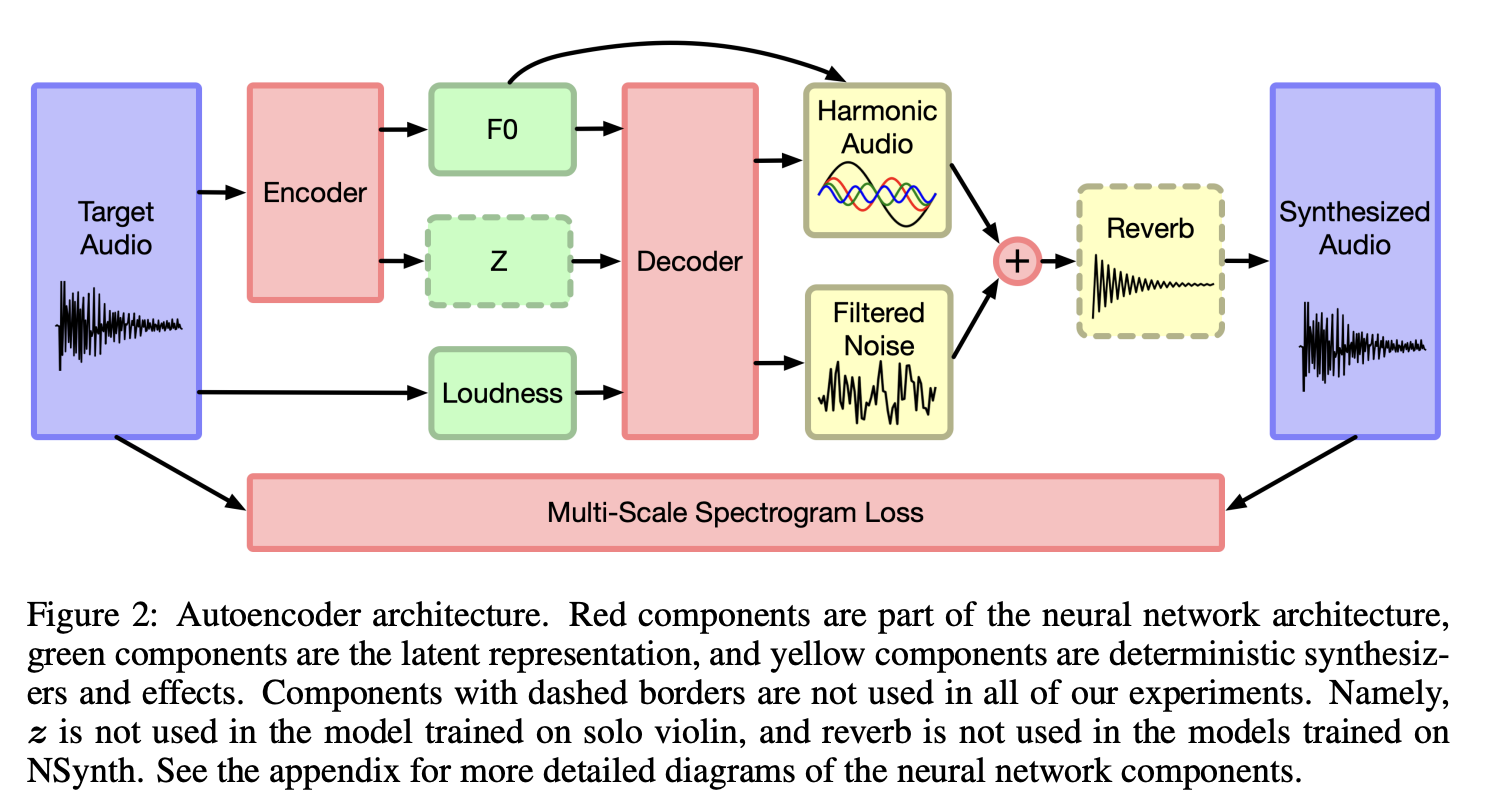
Figura original: Arquitectura del autoencoder DDSP.
Codificador
El codificador transforma el audio de entrada en dos curvas de control: la frecuencia fundamental (f0, la altura tonal), estimada con un detector de tono CREPE preentrenado, y la sonoridad, calculada directamente a partir de la señal. Un codificador residual opcional, una GRU aplicada a los MFCC, añade un vector latente para los detalles del timbre que la altura tonal y la sonoridad no capturan. Estas señales de baja dimensionalidad describen la interpretación.
Decodificador y módulos de síntesis
Un decodificador recurrente (GRU) transforma las señales de control en parámetros para tres componentes DSP:
- Sintetizador aditivo armónico: genera hasta 100 parciales sinusoidales en múltiplos de la frecuencia fundamental para la parte del sonido que tiene una altura definida.
- Sintetizador de ruido filtrado: da forma al ruido blanco con filtros FIR que varían en el tiempo para modelar el soplo y el ruido del arco.
- Reverberación diferenciable: añade la acústica de una sala mediante una respuesta al impulso aprendida.
Cada componente es diferenciable, por lo que todo el modelo se entrena de extremo a extremo con una pérdida espectral multiescala. Predice cientos de parámetros de síntesis por trama en lugar de generar el audio muestra a muestra.
Entrenar modelos DDSP para investigación
Para un modelo que vayas a tocar en el VST DDSP, usa el cuaderno de entrenamiento del VST DDSP descrito en el inicio rápido anterior. Para modificar la arquitectura o la función de pérdida, comienza por los tutoriales de Colab de la biblioteca. Requieren conocimientos básicos de Python y cubren el preprocesamiento, la configuración y el entrenamiento en una GPU de Colab.
Plugins DDSP para uso en tiempo real
Los proyectos oficiales de Magenta están archivados, pero estas herramientas todavía permiten ejecutar DDSP en un DAW:
1. VST Magenta DDSP (archivado)
El VST DDSP oficial sigue funcionando para experimentar; consulta las instrucciones de instalación en el inicio rápido anterior. Incluye cinco modelos de instrumentos y admite entrada MIDI y de audio. Los usuarios señalan una reverberación intensa en la salida, que parece ocultar los artefactos.
2. Plataforma Neutone FX
Neutone FX ofrece un plugin gratuito que aloja modelos entrenados por la comunidad, incluidas redes de transferencia de timbre basadas en DDSP. Permite a los productores acceder a decenas de modelos además de los instrumentos originales de Magenta.

3. MAWF de yaboihanoi (recomendado)
El plugin MAWF ejecuta la síntesis DDSP a 48 kHz dentro de tu DAW. Incluye varios modelos de instrumentos y es la implementación de DDSP más pulida disponible.

Sin embargo, el sitio de descarga de MAWF no está disponible desde noviembre de 2025. Actualizaré este artículo si encuentro otra fuente para el plugin.
¿Cuáles son las limitaciones de DDSP?
Las limitaciones de DDSP proceden de su arquitectura y su enfoque de síntesis:
- Solo monofónico: los modelos DDSP no pueden generar audio polifónico. Se entrenaron con grabaciones monofónicas y el sintetizador armónico presupone una sola frecuencia fundamental en cada paso temporal.
- Calidad de audio: los modelos de MAWF a 48 kHz suenan mejor, pero las implementaciones originales a 16 kHz presentan artefactos metálicos y poco contenido de alta frecuencia. Un modelo de superresolución de audio puede regenerar los agudos que faltan en antiguos renders: consulta cómo instalar y ejecutar AudioSR desde GitHub, o cómo UniverSR restauró a 48 kHz efectos de sonido de RPG Maker a 22 kHz.
- Paralelismo limitado en GPU: las capas recurrentes procesan las tramas una tras otra, por lo que el modelo no puede paralelizar el procesamiento temporal en una GPU como los modelos convolucionales.
Más allá de DDSP: RAVE, DDSP-CNN-Tiny y AFTER
RAVE (2021)
RAVE utiliza CNN causales en lugar de RNN, lo que aporta entrenamiento más rápido y síntesis a 48 kHz, además de un mejor modelado del timbre. Es un autoencoder variacional perfeccionado mediante entrenamiento adversarial con un discriminador y alcanza mayor fidelidad con una cantidad de datos similar.
DDSP-CNN-Tiny (2022)
DDSP-CNN-Tiny sustituye las RNN de DDSP por CNN ligeras, lo que reduce el tamaño del modelo y acelera la inferencia. La calidad de audio sigue siendo comparable y funciona en tiempo real en una CPU. Los plugins neuronales gratuitos de amplificación de guitarra como NAM y AIDA-X también utilizan redes pequeñas ejecutadas en CPU. Václav Volhejn lo desarrolló para su tesis en ETH Zurich, y su tesis sobre DDSP en tiempo real es una excelente lectura técnica.
AFTER (2024)
El modelo AFTER ejecuta difusión latente sobre un códec de audio neuronal para alcanzar síntesis de calidad de estudio. Requiere más cálculo que DDSP, pero su transferencia de timbre presenta muchos menos artefactos, lo que lo hace más adecuado para la producción profesional.
Preguntas frecuentes sobre DDSP
¿Se sigue manteniendo Magenta DDSP?
En parte. La biblioteca ddsp no está archivada y sigue recibiendo commits. Magenta archivó MIDI DDSP en febrero de 2024 y el VST DDSP en octubre de 2024, por lo que el plugin no recibe actualizaciones. Las descargas del plugin y el cuaderno de entrenamiento seguían funcionando cuando esta guía se actualizó en octubre de 2026.
¿Funciona el VST DDSP en Linux?
No hay una versión oficial para Linux. Tendrías que compilarlo por tu cuenta a partir del código fuente.
¿Puede DDSP tocar acordes?
No. Los modelos DDSP son monofónicos: siguen una altura tonal cada vez. Para control MIDI polifónico, consulta AFTER.
DDSP o RAVE: ¿cuál debería entrenar?
Elige DDSP para un instrumento de altura definida si solo tienes unos 10 minutos de audio y una GPU gratuita de Colab. Elige RAVE para cualquier tipo de sonido, incluidas percusiones, texturas y voces. RAVE necesita unas horas de audio y días de entrenamiento en GPU. Las preguntas frecuentes comparan cuánto audio de entrenamiento necesitan DDSP, RAVE y AFTER y explican qué plugin reproduce cada modelo entrenado en tu DAW.