دليل DDSP: Magenta DDSP VST والتدريب وآلية العمل
DDSP، أي معالجة الإشارات الرقمية القابلة للاشتقاق، هي مكتبة مفتوحة المصدر من Google Magenta تتيح لشبكة عصبية التحكم في مولّدات صوت تقليدية: المذبذبات والضوضاء المرشّحة وصدى الغرفة. أرشفت Magenta إضافة DDSP VST في 2024، لكن الإضافة المجانية ما زالت قابلة للتنزيل وتعمل على Windows وmacOS. يمكنكم أيضا تدريب نموذج آلتكم الخاصة في دفتر Google Colab مجاني.
يبدأ هذا الدليل بهاتين الخطوتين العمليتين. ثم يشرح كيف يعمل DDSP وأين تقصر قدراته، وما النماذج الأحدث التي حلّت محله.
استخدام DDSP اليوم: بداية سريعة
تنزيل DDSP VST وتثبيته
- نزّلوا الإضافة لـmacOS أو Windows. يأتي الرابطان من مستودع DDSP VST الرسمي.
- فكّوا ضغط الملف. يتضمن إضافتين: DDSP Effect التي تحول الصوت الداخل، مثل صوتكم، إلى صوت آلة، وDDSP Synth التي تعزفون بها عبر MIDI.
- على macOS، انسخوهما إلى
/Library/Audio/Plug-Ins/Componentsلإضافات AU وإلى/Library/Audio/Plug-Ins/VST3. على Windows، انسخوا ملفات VST3 إلىC:\Program Files\Common Files\VST3. - أعيدوا فحص الإضافات في DAW.
لا توجد نسخة Linux رسمية. لسماع DDSP دون تثبيت أي شيء، جرّبوا عرض Tone Transfer على الويب.
تدريب آلتكم الخاصة باستخدام DDSP
يعمل دفتر تدريب DDSP VST من Magenta في Google Colab، لذلك لا تحتاجون إلى GPU محلي:
- ضعوا ما لا يقل عن 10 دقائق من صوت
.wavأو.mp3في مجلد Google Drive. استخدموا صوتا أحادي النغمة، أي نغمة واحدة في كل مرة، من جلسة تسجيل واحدة بالميكروفون والغرفة نفسيهما. - افتحوا الدفتر وشغّلوا خلية التثبيت، التي تستغرق نحو 5 دقائق، ثم شغّلوا خلية التدريب واختاروا مجلدكم.
- انتظروا. يستغرق التدريب نحو 2 إلى 3 ساعات على Colab المجاني، وأقل من ساعة على Colab Pro+. إذا انقطع اتصال Colab، شغّلوا الخلية مجددا بالمجلد نفسه ليستأنف التدريب.
- فكّوا ضغط مجلد النموذج الذي نزّلتموه داخل مجلد نماذج الإضافة. على Mac، يكون المسار
~/Documents/Magenta/DDSP/Models، ويمكنكم فتحه من داخل الإضافة أيضا.
يشير الدفتر إلى أن النتائج الجيدة تظهر عادة بعد 30,000 إلى 50,000 خطوة تدريب. تعطي الخطوات القليلة صوتا باهتا؛ وقد تتسبب الخطوات الكثيرة في تقطّع الصوت وقفزات كبيرة في مستوى الصوت.
التاريخ والتطور: من Magenta إلى الإضافات الحديثة
مختبر أبحاث Magenta بين 2016 و2024
أطلقت Google مشروع Magenta في 2016 كمشروع بحثي مفتوح المصدر للتعلّم الآلي في الموسيقى والفن. أصدر كثيرا من أدوات توليد الموسيقى، لكن معظم مشروعاته كانت قد أُرشفت بحلول 2024.
Open NSynth Super في 2017
قبل DDSP، قدّمت Magenta جهاز Open NSynth Super، وهو آلة موسيقية مبنية على NSynth. تحتوي مجموعة بيانات NSynth على نحو 305,000 عينة لنغمات منفردة من 1,006 آلات. يتيح الجهاز، المبني على Raspberry Pi ولوحة PCB مخصصة، للعازفين التحول تدريجيا بين أصوات الآلات في الوقت الحقيقي.
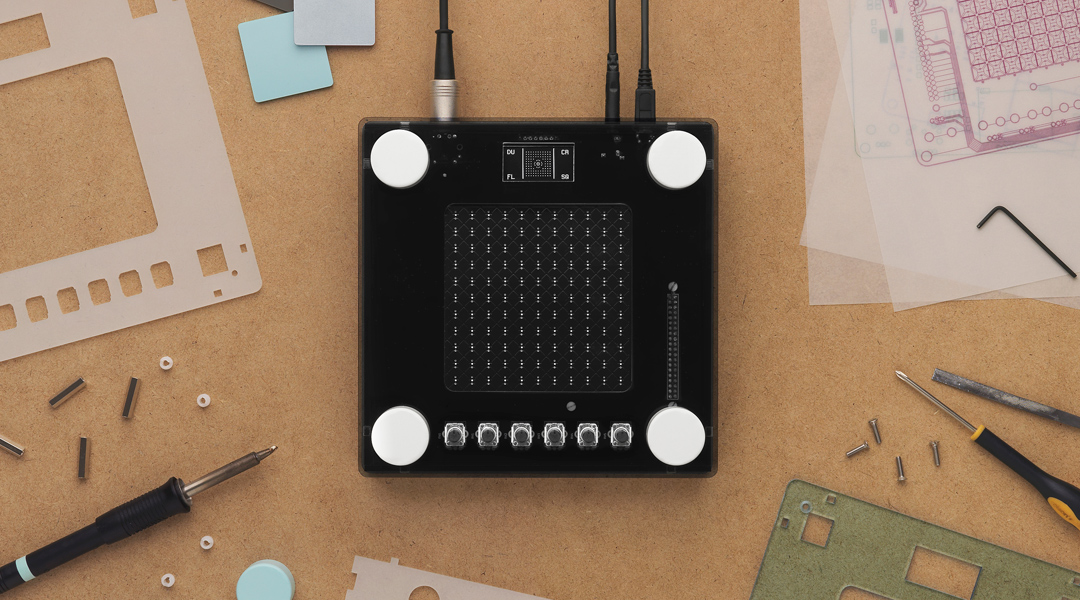
اقتصر نموذج NSynth، وهو مشفّر تلقائي على نمط WaveNet، على صوت 16-bit/16 kHz بسبب كلفته الحسابية، ولذلك يبدو الناتج منخفض الدقة الصوتية بوضوح. وصفه مهندس الصوت Joe Boston بأنه "ذو ملمس حُبيبي"، لكنه وجد له استخدامات إبداعية بتمريره عبر مؤثرات خارجية. أُرشف مشروع الجهاز في أغسطس 2025.
DDSP وTone Transfer في 2020
في 2020، نشرت Magenta مكتبة DDSP وورقتها في ICLR، وقدّمت نسخا قابلة للاشتقاق من وحدات شائعة لمعالجة الإشارات. أتاح عرض Tone Transfer على الويب تحويل تسجيلات مثل الغناء إلى كمان أو ساكسفون أو بوق أو فلوت.
كانت النماذج مشفّرات تلقائية مبنية على RNN، دُرّبت على نحو 10 دقائق من الصوت أحادي النغمة لكل آلة. عمل العرض، لكن خرج 16 kHz والقدرة المحدودة على نمذجة أساليب الأداء قيّدا إمكاناته.
MIDI DDSP وإضافة VST بين 2022 و2024
وسّعت Magenta نظام DDSP بإطلاق MIDI DDSP في يناير 2022. يولّف صوت الآلات مباشرة من تسلسلات MIDI أحادية النغمة. لعزف MIDI عبر عينات مسجلة بدلا من نموذج عصبي، حمّلوا آلة SFZ في مشغّل sforzando المجاني.
في يونيو 2022، أصدرت Magenta إضافة DDSP VST لنقل الطابع الصوتي في الوقت الحقيقي داخل DAW. أُرشف المشروعان في 2024: MIDI DDSP في فبراير، وإضافة VST في أكتوبر.

إضافة الصوت MAWF في 2023
أطلق Hanoi Hantrakul، المعروف باسم yaboihanoi، وهو القائد التقني السابق لـTone Transfer ويعمل في ByteDance منذ 2020، إضافة MAWF في 2023. تعمل إضافة VST/AU المجانية على توليف الصوت العصبي في الوقت الحقيقي عند 48 kHz، متجاوزة حد 16 kHz في تطبيقات DDSP السابقة.

كيف يعمل DDSP؟ الجمع بين المشفّرات التلقائية وDSP
DDSP مشفّر تلقائي يوجّه مفكّك الترميز فيه مكونات DSP على هيئة وحدات بدلا من توليد شكل الموجة مباشرة.
بنية المشفّر التلقائي DDSP
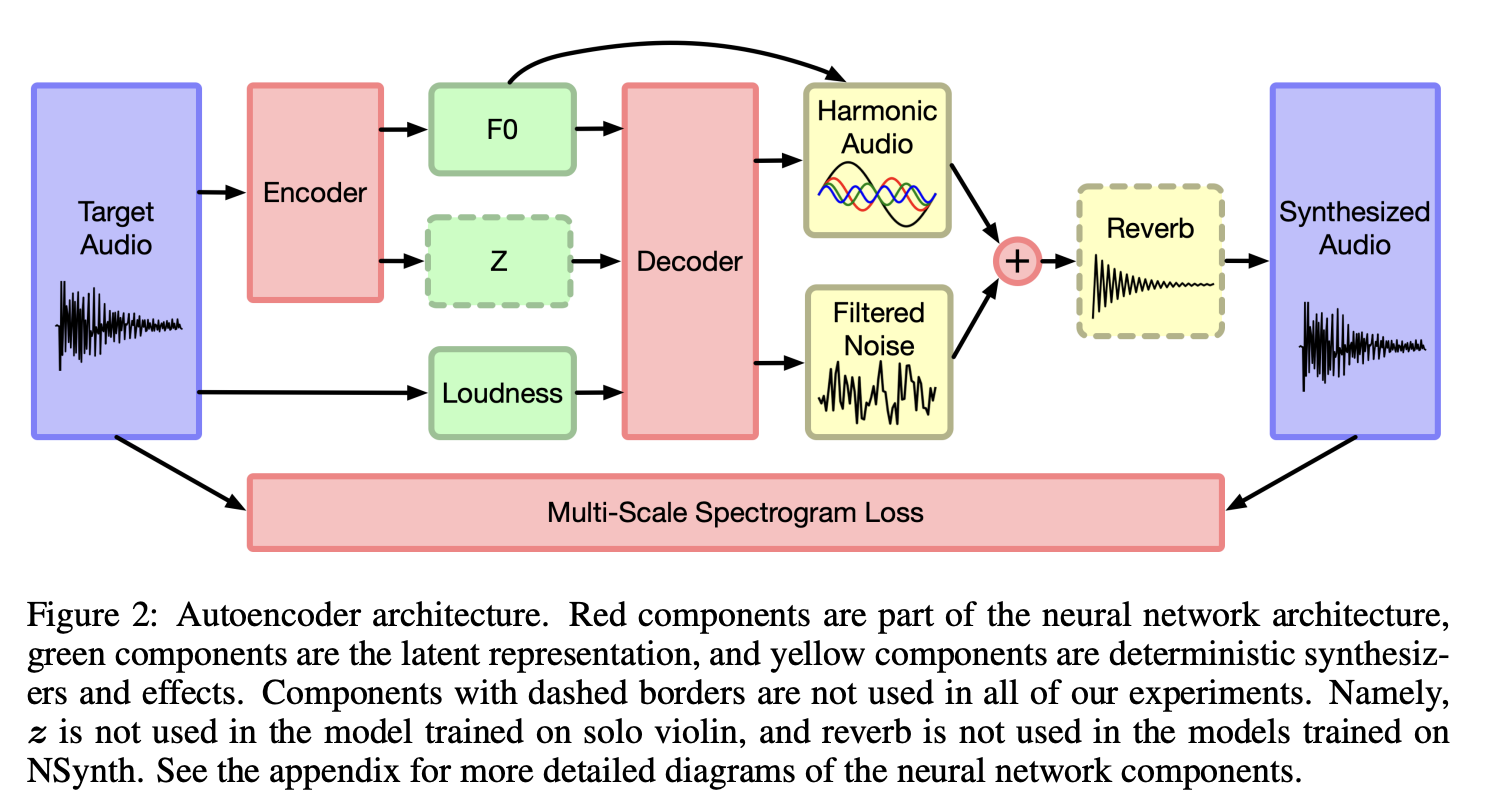
الشكل الأصلي: بنية المشفّر التلقائي DDSP.
المشفّر
يحوّل المشفّر الصوت الداخل إلى منحنيي تحكم: التردد الأساسي، f0، أي الارتفاع النغمي، الذي يقدّره متتبّع الارتفاع النغمي CREPE المدرّب مسبقا، والجهارة التي تُحسب مباشرة من الإشارة. يضيف مشفّر متبقّيات اختياري، يعتمد على GRU لمعالجة MFCC، متجها كامنا لتفاصيل الطابع الصوتي التي لا يلتقطها الارتفاع النغمي والجهارة. تصف هذه الإشارات منخفضة الأبعاد الأداء.
مفكّك الترميز ووحدات التوليف
يحوّل مفكّك ترميز متكرر من نوع GRU إشارات التحكم إلى معاملات لثلاثة مكونات DSP:
- مولّف توافقي جمعي: يولّد حتى 100 مكوّن جيبي عند مضاعفات التردد الأساسي للجزء ذي الارتفاع النغمي من الصوت.
- مولّف ضوضاء مرشّحة: يشكّل الضوضاء البيضاء بمرشحات FIR متغيرة زمنيا لنمذجة أصوات النفس واحتكاك القوس.
- صدى غرفة قابل للاشتقاق: يضيف الخصائص الصوتية للغرفة عبر استجابة نبضية يتعلمها النموذج.
كل مكوّن قابل للاشتقاق، لذلك يُدرّب النموذج كله بصورة متكاملة من الإدخال إلى الإخراج باستخدام خسارة طيفية متعددة المقاييس. يتنبأ بمئات معاملات التوليف لكل إطار بدلا من توليد الصوت عينة بعينة.
تدريب نماذج DDSP للأبحاث
لنموذج ستعزفون به في DDSP VST، استخدموا دفتر تدريب DDSP VST المذكور في البداية السريعة أعلاه. لتغيير البنية أو الخسارة، ابدؤوا من دروس Colab في المكتبة. تحتاج إلى مهارات Python أساسية، وتغطي المعالجة المسبقة والإعداد والتدريب على GPU في Colab.
إضافات DDSP للاستخدام في الوقت الحقيقي
أُرشفت مشروعات Magenta الرسمية، لكن يمكنكم تشغيل DDSP في DAW بهذه الأدوات:
1. Magenta DDSP VST المؤرشفة
ما زالت DDSP VST الرسمية تعمل للتجارب؛ راجعوا خطوات التثبيت في البداية السريعة أعلاه. تتضمن خمسة نماذج للآلات وتقبل مدخلي MIDI والصوت. يذكر المستخدمون وجود صدى غرفة كثيف في الناتج، ويبدو أنه يخفي شوائب المعالجة.
2. منصة Neutone FX
تقدّم Neutone FX إضافة مجانية تشغّل نماذج درّبها المجتمع، ومنها شبكات نقل الطابع الصوتي المبنية على DDSP. تتيح للمنتجين الوصول إلى عشرات النماذج، لا آلات Magenta الأصلية فقط.

3. MAWF من yaboihanoi، الخيار الموصى به
تعمل إضافة MAWF على توليف DDSP عند 48 kHz داخل DAW. تتضمن عدة نماذج للآلات، وهي التطبيق الأكثر صقلا لـDDSP المتاح حاليا.

لكن موقع تنزيل MAWF متوقف منذ نوفمبر 2025. سأحدّث المقال إذا وجدت مصدرا آخر للإضافة.
ما حدود DDSP؟
تأتي حدود DDSP من بنيته ونهج التوليف:
- نغمة واحدة فقط: نماذج DDSP لا تستطيع توليد صوت متعدد النغمات. دُرّبت على تسجيلات أحادية النغمة، ويفترض المولّف التوافقي ترددا أساسيا واحدا في كل خطوة زمنية.
- جودة الصوت: تبدو نماذج MAWF عند 48 kHz أفضل، لكن تطبيقات 16 kHz الأصلية تحتوي على شوائب معدنية ومحتوى قليل من الترددات العليا. يمكن لنموذج رفع الدقة الصوتية إعادة توليد الترددات العليا المفقودة من النواتج القديمة: راجعوا كيفية تثبيت AudioSR وتشغيله من GitHub، أو كيف رمّم UniverSR مؤثرات RPG Maker عند 22 kHz إلى 48 kHz.
- توازٍ محدود على GPU: تعالج الطبقات المتكررة الإطارات واحدا تلو الآخر، فلا يستطيع النموذج موازاة المعالجة عبر الزمن على GPU كما تفعل النماذج الالتفافية.
ما بعد DDSP: RAVE وDDSP-CNN-Tiny وAFTER
RAVE في 2021
يستخدم RAVE شبكات CNN سببية بدلا من RNN، فيوفّر تدريبا أسرع وتوليفا عند 48 kHz مع نمذجة أفضل للطابع الصوتي. هو مشفّر تلقائي تغايري تُحسّنه عملية تدريب خصومية تعتمد على مميّز، ويبلغ جودة صوت أعلى بكمية بيانات مشابهة.
DDSP-CNN-Tiny في 2022
يستبدل DDSP-CNN-Tiny شبكات RNN في DDSP بشبكات CNN خفيفة، فيصغّر النموذج ويسرّع الاستدلال. تبقى جودة الصوت مماثلة، ويعمل في الوقت الحقيقي على CPU. تعتمد إضافات مضخمات الغيتار العصبية المجانية مثل NAM وAIDA-X أيضا على شبكات صغيرة تعمل على CPU. طوّره Václav Volhejn لأطروحته في ETH Zurich، وتعد أطروحته عن DDSP في الوقت الحقيقي قراءة تقنية ممتازة.
AFTER في 2024
يشغّل نموذج AFTER الانتشار الكامن فوق مُرمّز صوت عصبي لتحقيق توليف بجودة الاستوديو. هو أثقل حسابيا من DDSP، لكن نقل الطابع الصوتي فيه أقل شوائب بكثير، مما يجعله أنسب للإنتاج الاحترافي.
أسئلة شائعة حول DDSP
هل لا يزال Magenta DDSP يُصان؟
جزئيا. لم تُؤرشف مكتبة ddsp، وما زالت تتلقى تعديلات برمجية. أرشفت Magenta مشروع MIDI DDSP في فبراير 2024 وDDSP VST في أكتوبر 2024، لذلك لا تتلقى الإضافة تحديثات. كانت تنزيلات الإضافة ودفتر التدريب لا تزال تعمل عند تحديث هذا الدليل في أكتوبر 2026.
هل تعمل DDSP VST على Linux؟
لا توجد نسخة Linux رسمية. ستحتاجون إلى بنائها بأنفسكم من الشفرة المصدرية.
هل يستطيع DDSP عزف التآلفات؟
لا. نماذج DDSP أحادية النغمة: تتبع ارتفاعا نغميا واحدا في كل مرة. للتحكم عبر MIDI متعدد النغمات، اطّلعوا على AFTER.
هل ينبغي أن أدرّب DDSP أم RAVE؟
اختاروا DDSP لآلة واحدة ذات ارتفاع نغمي عندما لا يتوفر لديكم سوى نحو 10 دقائق من الصوت وGPU مجاني في Colab. اختاروا RAVE لأي نوع من الصوت، بما فيه الطبول والأنسجة الصوتية والأصوات البشرية. يحتاج RAVE إلى بضع ساعات من الصوت وأيام من التدريب على GPU. تقارن الأسئلة الشائعة كمية صوت التدريب التي تحتاجها DDSP وRAVE وAFTER، والإضافة التي تعزف كل نموذج مدرّب في DAW.