IRCAM AFTER: التثبيت والنماذج المدربة مسبقا والتدريب
نموذج AFTER من IRCAM هو نموذج لتوليف الصوت بالشبكات العصبية، يستطيع الموسيقيون التحكم فيه في الوقت الفعلي وبأصوات متعددة عبر مدخلات مألوفة: نغمات MIDI أو طبقة الصوت وجهارته في إشارة صوتية أخرى.
لتجربته، نزّلوا النماذج المدربة مسبقا ورقع Max من مجلد IRCAM المشترك، وثبّتوا الكائن الخارجي nn~، ثم افتحوا الرقعة في Max أو أجهزة Max for Live في Ableton Live. لتدريب نموذجكم الخاص، ثبّتوا حزمة Python من GitHub واتبعوا خطوات التدريب أدناه.

ما نموذج AFTER؟
AFTER اختصار لعبارة Audio Features Transfer and Exploration in Real-time. وهو يفصل التعبير الموسيقي (البنية) عن هوية الصوت (الطابع الصوتي)، لتتمكنوا من تغيير كل منهما على نحو مستقل.
تولّد نماذج «الصندوق الأسود» السابقة الصوت من إحداثيات كامنة مجردة يصعب توجيهها. أما AFTER فيستخدم عناصر تحكم صريحة. يمكنكم تطبيق أداء آلة، مثل منحنى طبقة الصوت في الغناء، على الطابع الصوتي الذي تعلمه النموذج من آلة أخرى، أو عزف النموذج بالكامل عبر MIDI. وبخلاف DDSP الذي يتتبع طبقة صوت واحدة في كل مرة، يستطيع AFTER عزف تآلفات من MIDI إذا كان مدربا على بيانات متعددة الأصوات.
لتغيير أسلوب أغنية مكتملة بدلا من أداء منفرد، يحتفظ الريمكس بالذكاء الاصطناعي بطبقة الغناء ويعيد توليد الجزء الآلي من موجّه نصي.
التاريخ والمنشأ: فريق ACIDS
نشأ AFTER من أبحاث الدكتوراه التي أجراها Nils Demerlé في IRCAM (معهد الأبحاث والتنسيق في الصوتيات/الموسيقى) بباريس. عمل ضمن مجموعة ACIDS مع Ninon Devis وPhilippe Esling وGuillaume Doras وDavid Genova لمعالجة أحد قيود المشفّرات التلقائية التغايرية (VAEs).
تضغط المشفّرات التلقائية التغايرية، مثل نموذج RAVE، الصوت جيدا، لكن طبقة الصوت والطابع الصوتي غالبا ما يختلطان في الأبعاد الكامنة نفسها، أي يحدث «تشابك»، فيصعب التحكم فيهما منفصلين. قدّم الفريق حله في ورقة «الجمع بين التحكم بالصوت ونقل الأسلوب باستخدام الانتشار الكامن» في أغسطس 2024. وكان الهدف نقل جودة صوت نماذج الانتشار إلى الأداء الموسيقي الحي.

كيف يعمل AFTER؟ بنية الانتشار الكامن
يستخدم AFTER الانتشار الكامن المشروط. وبدلا من توليد عينات الصوت الخام واحدة تلو الأخرى، وهي عملية بطيئة، يعمل في فضاء «كامن» مضغوط يوفّره مشفّر تلقائي مدرب مسبقا.

البنية والطابع الصوتي
يقسّم AFTER الصوت إلى مسارين:
- البنية (الخصائص المحلية): عناصر تحكم صريحة تتغير بمرور الوقت.
- مدخل الصوت: طبقة الصوت (f_0) والجهارة (بترجيح A).
- مدخل MIDI: تمثيل متعدد الأصوات على شبكة نغمات البيانو.
- الطابع الصوتي (الخصائص العامة): متجه تضمين متعلَّم يظل ثابتا بمرور الوقت ويمثل هوية الصوت، مثل «التشيلو» أو «غيتار بتأثير التشويه».
خطوات المعالجة
- الضغط (المرمّز): يضغط مرمّز صوت عصبي، عادة مشفّر تلقائي من RAVE، الصوت الوارد إلى متجهات كامنة منخفضة الأبعاد.
- إعداد الشروط: يستخرج النظام منحنيات طبقة الصوت والجهارة باستخدام أدوات مثل CREPE أو Basic Pitch لبناء شرط البنية.
- الانتشار الكامن: تتنبأ شبكة U-Net مشروطة بالتمثيلات الكامنة للصوت بناء على البنية والطابع الصوتي المستهدف.
- فك الترميز: يحوّل مرمّز الصوت التمثيلات الكامنة المتوقعة إلى أشكال موجية خام من جديد.
كيفية تدريب نماذج AFTER
يتألف التدريب من ثلاث مراحل. يحتوي مستودع AFTER على GitHub على السكربتات الكاملة. ثبّتوا AFTER في بيئة Python 3.12:
git clone https://github.com/acids-ircam/AFTER.git
cd AFTER/
pip install -e .1. إعداد مجموعة البيانات
تحتاجون إلى مجموعة بيانات صوتية، وعادة إلى أكثر من ساعة واحدة للحصول على نتائج جيدة (كمية البيانات اللازمة لكل من DDSP وRAVE وAFTER). إذا كانت الآلة المطلوبة ممزوجة بآلات أخرى، فاعزلوها أولا عبر فصل طبقات عالي الجودة بالذكاء الاصطناعي.
- المعالجة المسبقة: يحلّل سكربت
after prepare_datasetالصوت ويستخرج الخصائص المرجعية الصحيحة. - الأدوات: يستخدم Basic Pitch من Spotify لتدوين نغمات MIDI، وأدوات استخراج الجهارة للصوت. تُخزّن البيانات في قاعدة بيانات LMDB للوصول السريع إليها أثناء التدريب.
- تحققوا من التدوين أولا: لتسمعوا مدى نجاح تحويل موادكم إلى نغمات قبل تشغيل تدريب طويل، جرّبوا تحويل الصوت إلى MIDI على مقتطف قصير. يشرح دليل تحويل الصوت إلى MIDI الخطوات في الاستوديو.
أعدّوا أولا مجموعة بيانات أشكال موجية للمشفّر التلقائي:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_audio --save_waveform True2. تدريب المشفّر التلقائي (المرمّز)
قبل تدريب نموذج الانتشار، تحتاجون إلى «مرمّز» يضغط الصوت.
- الخيار A: درّبوا مشفّرا تلقائيا سببيا جديدا باستخدام خسارة طيفية متعددة المقاييس وخسارة مفصلية خصومية.
- الخيار B: استخدموا مرمّزا مدربا مسبقا من مجلد IRCAM المشترك أو نموذج RAVE كمحرّك خلفي. هذه الطريقة أسرع إذا كان هناك بالفعل نموذج جيد لنوع الصوت الذي تستخدمونه.
للخيار A، درّبوا المشفّر التلقائي وصدّروه:
after train_autoencoder --name AE_model_name --db_path /dataset/path_audio --config AE_4096 --gpu 0
after export_autoencoder --model_path autoencoder_runs/AE_model_name
ينشئ التصدير export.ts للمعالجة خارج الوقت الفعلي وexport_stream.ts للمعالجة في الوقت الفعلي.
3. تدريب نموذج الانتشار
في هذه المرحلة، يتعلم النموذج كيفية ربط إشارات التحكم بالصوت.
- الهدف: يقلّل النموذج خطأ التنبؤ بالضوضاء (MSE). أي إنه يتعلم إزالة الضوضاء تدريجيا حتى يتبقى الصوت المستهدف.
- فك التشابك: يعاقب معيار خصومي النموذج كلما التقط مشفّر الطابع الصوتي معلومات عن طبقة الصوت. وهذا يبقي عنصري التحكم مستقلين.
رمّزوا الصوت باستخدام المرمّز، ثم درّبوا نموذج الانتشار:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_latent --emb_model_path AE_model_run/export.ts
after train --name diff_model_name --db_path /dataset/path_latent --emb_model_path AE_model_run/export.ts --config audio
4. التصدير للاستخدام في الوقت الفعلي
صدّروا باستخدام after export لجهاز Audio-to-Audio، أو after export_midi لجهاز MIDI-to-Audio:
after export --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
after export_midi --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
ينشئ التصدير أيضا خريطة للفضاء الكامن بصيغة .png. ويطلب README الاحتفاظ بها مع ملف .ts.
استخدام AFTER في الوقت الفعلي: Max for Live وMax/MSP
التكامل مع Max for Live (M4L)
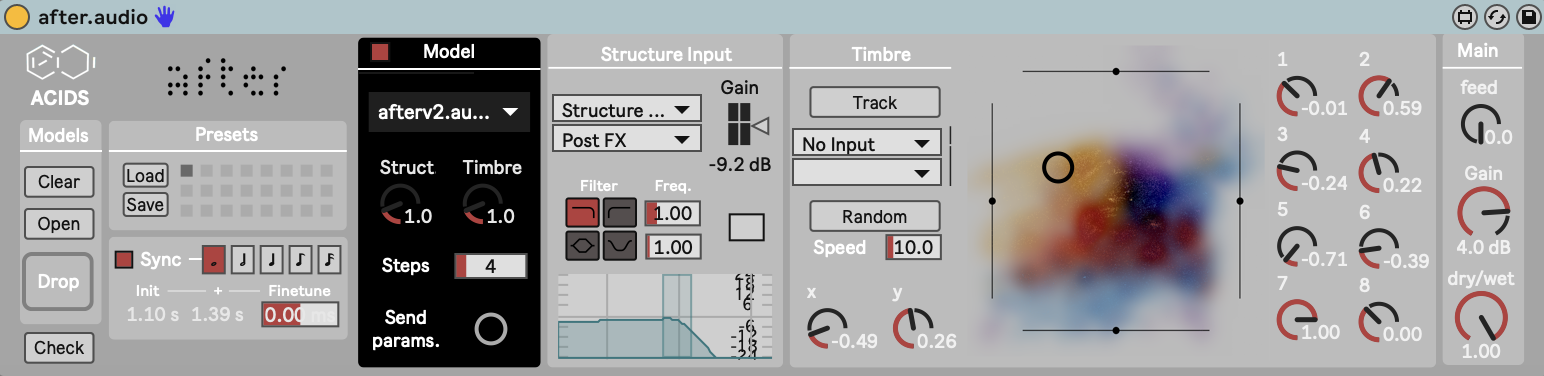
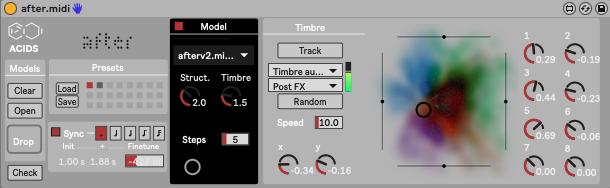
يوفّر AFTER لمستخدمي Ableton Live جهازين من أجهزة Max for Live يربطان Live بالنموذج.
الأول هو Audio-to-Audio. يستخدم مدخل سلسلة جانبية، مثل صوتكم، للتحكم في طبقة الصوت والجهارة في النموذج العصبي.
الثاني هو MIDI-to-Audio. يرسل نغمات MIDI إلى النموذج بوصفها مدخلا للبنية على هيئة شبكة نغمات البيانو. وبفضل بنية الانتشار الكامن، يدعم تعدد الأصوات عندما يكون النموذج مدربا على بيانات متعددة الأصوات. لعزف MIDI نفسه عبر عينات مسجلة بدلا من ذلك، حمّلوا آلة SFZ في sforzando.
Max/MSP وnn~
للمطورين، يعمل AFTER داخل Max/MSP عبر الكائن الخارجي nn~، الذي يحمّل نماذج TorchScript المصدّرة (ملفات .ts) مباشرة في الرقعة.
ما مقدار التأخر في AFTER؟
يعمل AFTER بشكل مختلف عن نماذج التغذية الأمامية ذات المرور الواحد مثل RAVE، لأن الانتشار يحتاج إلى خطوات متعددة.
التأخر: تضيف كل خطوة لإزالة الضوضاء عبئا حسابيا، لذلك يكون التأخر في التنفيذ بالوقت الفعلي عادة 200 إلى 500 ms. يولّد AFTER الصوت أثناء العزف، لكن عزفه يشبه المرور عبر تأخر يمكن توقعه أكثر من آلة تستجيب فورا. في العروض الحية، يستخدم بعض الفنانين أسلوب «التكرار الحلقي»: يعيد AFTER تشغيل كل عبارة موسيقية في دورة التكرار التالية. إذا أردتم آلة تستجيب فورا، فالشبكات الصغيرة، مثل المستخدمة في إضافات مضخمات الغيتار العصبية المجانية، أنسب.
استخدام GPU: يجري الاستدلال عبر nn~، الذي يدعم تسريع GPU، لكن المستخدمين يلاحظون فرقا ضئيلا في الواقع. ولأن الانتشار عملية تكرارية، يبقى استخدام CPU مرتفعا مقارنة بمعالجة DSP المعتادة.
الأسئلة الشائعة عن AFTER
هل توجد إضافة AFTER بصيغة VST؟
لا. يوفّر المستودع الرسمي أجهزة Max for Live لبرنامج Ableton Live ورقع Max تعمل عبر nn~. ولا يذكر إضافة بصيغة VST أو AU.
أين توجد نماذج AFTER المدربة مسبقا؟
يستضيف IRCAM النماذج المدربة مسبقا والمرمّزات المدربة مسبقا ورقع Max في مجلد مشترك، يوجد رابطه في README الخاص بـAFTER.
هل AFTER هو نفسه IRCAMAX؟
لا. IRCAMAX حزمة تجارية من أجهزة Max for Live من IRCAM، تبيعها Ableton. أما AFTER فهو نموذج بحثي من فريق ACIDS في IRCAM، وكوده متاح للعامة على GitHub.
هل تختارون AFTER أم RAVE؟
RAVE نموذج ذو مرور واحد وتأخر أقل، لكن عناصر التحكم فيه عبارة عن أبعاد كامنة مجردة. يضيف AFTER تحكما صريحا في طبقة الصوت والجهارة وMIDI متعدد الأصوات فوق مرمّز، مقابل تأخر أكبر واستخدام أعلى للمعالج CPU.