IRCAM AFTER modeli: kurulum, önceden eğitilmiş modeller ve eğitim
IRCAM'ın AFTER modeli, müzisyenlerin tanıdık girdilerle gerçek zamanlı ve polifonik olarak kontrol edebileceği bir sinir ağı ses sentezi modelidir: MIDI notaları veya başka bir ses sinyalinin perde ve algılanan ses yüksekliği.
Denemek için IRCAM'ın paylaşılan klasöründen önceden eğitilmiş modelleri ve Max patch'lerini indirin, nn~ haricî modülünü kurun ve patch'i Max'te ya da Max for Live cihazlarını Ableton Live'da açın. Kendi modelinizi eğitmek için GitHub'daki Python paketini kurun ve aşağıdaki eğitim adımlarını izleyin.

AFTER modeli nedir?
AFTER, Audio Features Transfer and Exploration in Real-time ifadesinin kısaltmasıdır. Müzikal ifadeyi (yapı) ses kimliğinden (tını) ayırır; böylece her birini bağımsız olarak değiştirebilirsiniz.
Önceki "kara kutu" modelleri, kontrol edilmesi zor soyut gizil koordinatlardan ses üretir. AFTER bunun yerine açık kontrol parametreleri kullanır. Bir enstrümanın icrasını (örneğin sesin perde eğrisini) başka bir enstrümanın öğrenilmiş tınısına uygulayabilir veya modeli tamamen MIDI ile çalabilirsiniz. Aynı anda yalnızca bir perdeyi takip eden DDSP'nin aksine AFTER, polifonik verilerle eğitilmişse MIDI'den akor çalabilir.
Tek bir icra yerine tamamlanmış bir şarkının tarzını değiştirmek için yapay zekâ remiksi, vokal stem'ini korur ve bir metin promptuyla enstrümantal bölümü yeniden üretir.
Tarihçe ve köken: ACIDS ekibi
AFTER, Nils Demerlé'nin Paris'teki IRCAM (Akustik ve Müzik Araştırma ve Koordinasyon Enstitüsü) bünyesinde yürüttüğü doktora araştırmasından doğdu. Varyasyonel otoenkoderlerin (VAE) bir sınırlamasını çözmek için ACIDS grubunda Ninon Devis, Philippe Esling, Guillaume Doras ve David Genova ile çalıştı.
RAVE modeli gibi VAE'ler sesi iyi sıkıştırır; ancak perde ve tını çoğu zaman aynı gizil boyutlarda karışır ("iç içe geçme"), bu nedenle ayrı ayrı kontrol edilmeleri zordur. Ekip çözümünü Ağustos 2024'te "Gizil difüzyon kullanarak ses kontrolünü ve stil aktarımını birleştirme" başlıklı makalede sundu. Amaç, difüzyon modellerinin ses kalitesini canlı müzik performansına taşımaktı.

AFTER nasıl çalışır? Gizil difüzyon mimarisi
AFTER, koşullu gizil difüzyon kullanır. Ham ses örneklerini tek tek üretmek yavaş olduğundan bunun yerine önceden eğitilmiş bir otoenkoderin sağladığı sıkıştırılmış "gizil" uzayda çalışır.

Yapı ve tını
AFTER sesi iki akışa ayırır:
- Yapı (yerel özellikler): Zaman içinde değişen açık kontrol parametreleri.
- Ses girdisi: Perde (f_0) ve algılanan ses yüksekliği (A ağırlıklı).
- MIDI girdisi: Polifonik piyano rulosu gösterimi.
- Tını (genel özellikler): Zaman içinde sabit kalan ve sesin kimliğini temsil eden öğrenilmiş bir gömme vektörü (örneğin "çello", "distorsiyonlu gitar").
İşleme adımları
- Sıkıştırma (kodek): Bir sinir ağı ses kodeği (genellikle bir RAVE otoenkoderi), gelen sesi düşük boyutlu gizil vektörlere sıkıştırır.
- Koşullandırma: Sistem yapı koşulunu oluşturmak için perde ve ses yüksekliği eğrilerini çıkarır (CREPE veya Basic Pitch gibi araçlarla).
- Gizil difüzyon: Koşullu bir U-Net, yapı ve hedef tınıya dayanarak gizil ses temsillerini tahmin eder.
- Çözme: Ses kodeği, tahmin edilen gizil temsilleri yeniden ham dalga biçimlerine çözer.
AFTER modelleri nasıl eğitilir?
Eğitim üç aşamadan oluşur. AFTER GitHub deposu tüm betikleri içerir. AFTER'ı bir Python 3.12 ortamında kurun:
git clone https://github.com/acids-ircam/AFTER.git
cd AFTER/
pip install -e .1. Veri kümesini hazırlama
İyi sonuçlar için genellikle 1 saatten fazla ses içeren bir veri kümesine ihtiyacınız vardır (DDSP, RAVE ve AFTER'ın her biri ne kadar veri ister?). İstediğiniz enstrüman diğerleriyle mikslenmişse önce yüksek kaliteli yapay zekâ stem ayırma ile onu ayırın.
- Ön işleme:
after prepare_datasetbetiği sesi analiz eder ve referans özellikleri çıkarır. - Araçlar: MIDI transkripsiyonu için Spotify'ın Basic Pitch aracını, ses için de ses yüksekliği çıkarıcılarını kullanır. Eğitim sırasında hızlı erişim için veriler bir LMDB veritabanında saklanır.
- Önce transkripsiyonu kontrol edin: Uzun bir eğitimden önce materyalinizin notalara ne kadar iyi dönüştüğünü duymak için kısa bir bölümde sesten MIDI'ye dönüştürmeyi deneyin. Sesten MIDI'ye rehberi Studio'daki adımları açıklar.
Önce otoenkoder için bir dalga biçimi veri kümesi hazırlayın:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_audio --save_waveform True2. Otoenkoder eğitimi (kodek)
Difüzyon modelini eğitmeden önce sesi sıkıştıran bir "kodeğe" ihtiyacınız vardır.
- Seçenek A: Çok ölçekli spektral kayıp ve çekişmeli menteşe kaybı ile yeni bir nedensel otoenkoder eğitin.
- Seçenek B: IRCAM'ın paylaşılan klasöründen önceden eğitilmiş bir kodek veya altyapı olarak bir RAVE modeli kullanın. Ses türünüz için iyi bir model zaten varsa bu daha hızlıdır.
Seçenek A için otoenkoderi eğitin ve dışa aktarın:
after train_autoencoder --name AE_model_name --db_path /dataset/path_audio --config AE_4096 --gpu 0
after export_autoencoder --model_path autoencoder_runs/AE_model_name
Dışa aktarma, gerçek zamanlı olmayan işleme için export.ts, gerçek zamanlı kullanım için export_stream.ts oluşturur.
3. Difüzyon modeli eğitimi
Bu aşamada model, kontrol sinyallerinin sese nasıl dönüştüğünü öğrenir.
- Amaç: Model bir gürültü tahmin hatasını (MSE) en aza indirir. Başka bir deyişle, hedef ses kalana kadar adım adım gürültüyü gidermeyi öğrenir.
- Ayrıştırma: Çekişmeli bir ölçüt, tını kodlayıcısı perde bilgisi aldığında modeli cezalandırır. Bu, iki kontrolün bağımsız kalmasını sağlar.
Sesinizi kodekle kodlayın, ardından difüzyon modelini eğitin:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_latent --emb_model_path AE_model_run/export.ts
after train --name diff_model_name --db_path /dataset/path_latent --emb_model_path AE_model_run/export.ts --config audio
4. Gerçek zamanlı kullanım için dışa aktarma
Audio-to-Audio cihazı için after export veya MIDI-to-Audio cihazı için after export_midi ile dışa aktarın:
after export --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
after export_midi --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
Dışa aktarma ayrıca bir .png gizil haritası yazar. README, bunu .ts dosyasıyla birlikte tutmanızı ister.
AFTER gerçek zamanlı nasıl kullanılır? Max for Live ve Max/MSP
Max for Live (M4L) entegrasyonu
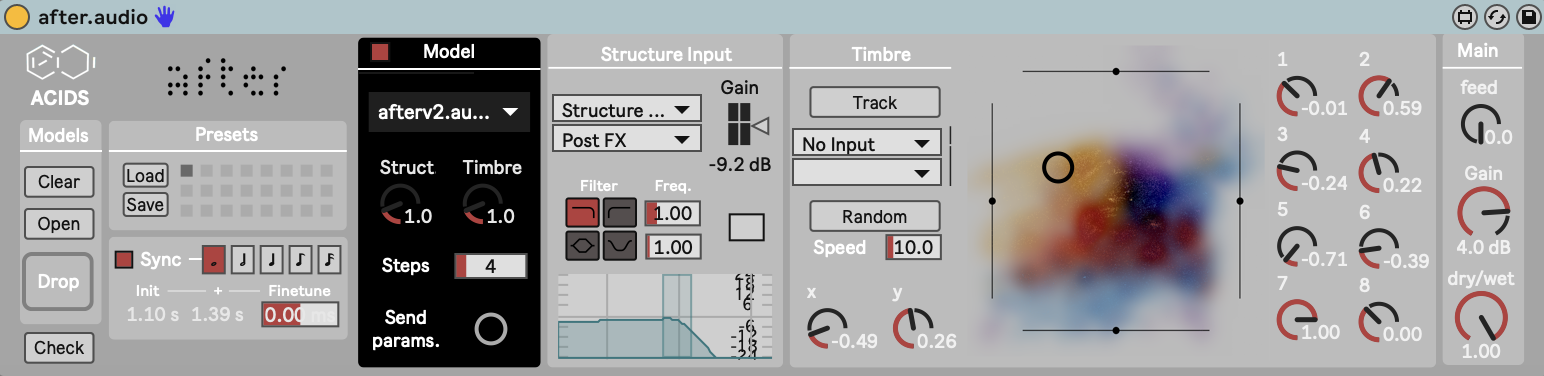
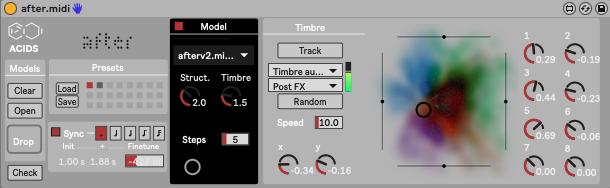
Ableton Live kullanıcıları için AFTER, Live'ı modele bağlayan iki Max for Live cihazı sunar.
İlki Audio-to-Audio. Sinir ağı modelinin perdesini ve ses yüksekliğini yönlendirmek için bir sidechain girdisi (örneğin sesiniz) kullanır.
İkincisi MIDI-to-Audio. MIDI notalarını piyano rulosu yapı girdisi olarak modele iletir. Gizil difüzyon mimarisi sayesinde model polifonik verilerle eğitilmişse polifoniyi destekler. Aynı MIDI'yi kayıtlı sample'lar üzerinden çalmak için sforzando'da bir SFZ enstrümanı yükleyin.
Max/MSP ve nn~
Geliştiriciler için AFTER, dışa aktarılmış TorchScript modellerini (.ts dosyalarını) doğrudan bir patch'e yükleyen nn~ haricî modülü aracılığıyla Max/MSP içinde çalışır.
AFTER'ın gecikmesi ne kadardır?
Difüzyon birkaç adım gerektirdiğinden AFTER, RAVE gibi tek geçişli ileri beslemeli modellerden farklı davranır.
Gecikme: Her gürültü giderme adımı hesaplama ekler; bu nedenle gerçek zamanlı uygulama genellikle 200 ila 500 ms gecikmeye sahiptir. AFTER çalma sırasında ses üretir; ancak anında yanıt veren bir enstrümandan çok, öngörülebilir bir gecikme üzerinden çalıyormuş gibi hissedilir. Canlı performanslarda bazı sanatçılar bunun yerine "döngüleme" yaklaşımını kullanır: AFTER her müzik cümlesini sonraki döngüde çalar. Anında yanıt veren bir enstrüman için ücretsiz sinir ağı gitar amfi eklentilerindeki gibi küçük ağlar daha uygundur.
GPU kullanımı: Çıkarım, GPU hızlandırmasını destekleyen nn~ üzerinden çalışır; ancak pratikte kullanıcılar pek fark görmez. Difüzyon yinelemeli olduğundan CPU kullanımı standart DSP'ye kıyasla yüksek kalır.
AFTER hakkında sık sorulan sorular
AFTER VST eklentisi var mı?
Hayır. Resmî depo, Ableton Live için Max for Live cihazları ve nn~ üzerinden çalışan Max patch'leri sunar. VST veya AU eklentisinden söz etmez.
Önceden eğitilmiş AFTER modelleri nerede?
IRCAM, önceden eğitilmiş modelleri, önceden eğitilmiş kodekleri ve Max patch'lerini paylaşılan klasörde barındırır; klasörün bağlantısı AFTER README içinde yer alır.
AFTER, IRCAMAX ile aynı mı?
Hayır. IRCAMAX, IRCAM'ın Max for Live cihazlarından oluşan ve Ableton tarafından satılan ticari bir pakettir. AFTER ise IRCAM'ın ACIDS ekibinin GitHub'da herkese açık kodu olan bir araştırma modelidir.
AFTER mı, RAVE mi?
RAVE, daha düşük gecikmeli tek geçişli bir modeldir; ancak kontrolleri soyut gizil boyutlardır. AFTER, daha yüksek gecikme ve CPU kullanımı karşılığında bir kodeğe açık perde, ses yüksekliği ve polifonik MIDI kontrolü ekler.