Модель AFTER от IRCAM: настройка, готовые модели и обучение
Модель AFTER от IRCAM — нейросетевая модель синтеза аудио, которой музыканты могут управлять в реальном времени и полифонически с помощью привычных входных данных: MIDI-нот или высоты тона и воспринимаемой громкости другого аудиосигнала.
Чтобы попробовать её, скачайте готовые модели и патчи Max из общей папки IRCAM, установите внешний модуль nn~ и откройте патч в Max или устройства Max for Live в Ableton Live. Чтобы обучить собственную модель, установите Python-пакет с GitHub и выполните описанные ниже шаги обучения.

Что такое модель AFTER?
AFTER расшифровывается как Audio Features Transfer and Exploration in Real-time. Она разделяет музыкальное исполнение (структуру) и характер звука (тембр), позволяя менять их независимо друг от друга.
Более ранние модели типа «чёрного ящика» генерируют звук по абстрактным латентным координатам, которыми сложно управлять. Вместо них AFTER использует явные параметры управления. Вы можете применить исполнение одного инструмента (например, кривую высоты голоса) к изученному тембру другого или целиком управлять моделью через MIDI. В отличие от DDSP, отслеживающей только одну высоту тона за раз, AFTER может играть аккорды по MIDI, если её обучили на полифонических данных.
Чтобы изменить стиль готовой песни, а не отдельного исполнения, ИИ-ремикс сохраняет стем вокала и заново генерирует инструментальную часть по текстовому промпту.
История и происхождение: команда ACIDS
AFTER выросла из диссертационного исследования Nils Demerlé в IRCAM (Институте исследования и координации акустики и музыки) в Париже. Он работал в группе ACIDS вместе с Ninon Devis, Philippe Esling, Guillaume Doras и David Genova, чтобы преодолеть ограничение вариационных автоэнкодеров (VAE).
VAE, такие как модель RAVE, хорошо сжимают аудио, но высота тона и тембр часто смешиваются в одних латентных измерениях («переплетение»), поэтому ими сложно управлять отдельно. Команда представила решение в статье «Совмещение управления аудио и переноса стиля с помощью латентной диффузии» в августе 2024 года. Целью было перенести качество аудио диффузионных моделей в живое музыкальное исполнение.

Как работает AFTER? Архитектура латентной диффузии
AFTER использует условную латентную диффузию. Вместо медленной генерации отсчётов аудио по одному она работает в сжатом «латентном» пространстве, которое предоставляет предварительно обученный автоэнкодер.

Структура и тембр
AFTER разделяет звук на два потока:
- Структура (локальные признаки): Явные параметры управления, меняющиеся во времени.
- Аудиовход: Высота тона (f_0) и воспринимаемая громкость (со взвешиванием A).
- MIDI-вход: Представление полифонии в виде пианоролла.
- Тембр (глобальные признаки): Изученный вектор представления, который остаётся постоянным во времени и описывает характер звука (например, «виолончель» или «гитара с дисторшном»).
Этапы обработки
- Сжатие (кодек): Нейросетевой аудиокодек (обычно автоэнкодер RAVE) сжимает входное аудио в латентные векторы низкой размерности.
- Формирование условий: Система извлекает кривые высоты тона и громкости (с помощью инструментов вроде CREPE или Basic Pitch), чтобы сформировать условие структуры.
- Латентная диффузия: Условная U-Net предсказывает латентные представления аудио на основе структуры и целевого тембра.
- Декодирование: Аудиокодек декодирует предсказанные латентные представления обратно в несжатый аудиосигнал.
Как обучать модели AFTER
Обучение состоит из трёх этапов. Репозиторий AFTER на GitHub содержит все скрипты. Установите AFTER в окружении Python 3.12:
git clone https://github.com/acids-ircam/AFTER.git
cd AFTER/
pip install -e .1. Подготовка датасета
Вам нужен набор аудиоданных, обычно больше 1 часа для хорошего результата (сколько данных требуется DDSP, RAVE и AFTER). Если нужный инструмент смешан с другими, сначала выделите его с помощью высококачественного ИИ-разделения на стемы.
- Предобработка: Скрипт
after prepare_datasetанализирует аудио и извлекает эталонные признаки. - Инструменты: Он использует Basic Pitch от Spotify для транскрипции MIDI и средства извлечения громкости из аудио. Данные хранятся в базе LMDB для быстрого доступа во время обучения.
- Сначала проверьте транскрипцию: Чтобы до долгого обучения услышать, насколько хорошо ваш материал превращается в ноты, попробуйте преобразование аудио в MIDI на коротком фрагменте. Руководство по преобразованию аудио в MIDI описывает шаги в Studio.
Сначала подготовьте датасет звуковых волн для автоэнкодера:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_audio --save_waveform True2. Обучение автоэнкодера (кодека)
Перед обучением диффузионной модели нужен «кодек», сжимающий аудио.
- Вариант A: Обучите новый причинный автоэнкодер с многомасштабной спектральной функцией потерь и состязательной шарнирной функцией потерь.
- Вариант B: Используйте готовый кодек из общей папки IRCAM или модель RAVE в качестве основы. Это быстрее, если уже есть подходящая модель для вашего типа аудио.
Для варианта A обучите и экспортируйте автоэнкодер:
after train_autoencoder --name AE_model_name --db_path /dataset/path_audio --config AE_4096 --gpu 0
after export_autoencoder --model_path autoencoder_runs/AE_model_name
Экспорт создаёт export.ts для обработки вне реального времени и export_stream.ts для работы в реальном времени.
3. Обучение диффузионной модели
На этом этапе модель изучает, как управляющие сигналы преобразуются в звук.
- Цель: Модель минимизирует ошибку предсказания шума (MSE). Иными словами, она учится поэтапно удалять шум, пока не останется целевой звук.
- Разделение признаков: Состязательный критерий штрафует модель, когда энкодер тембра извлекает информацию о высоте тона. Это сохраняет независимость двух параметров управления.
Закодируйте аудио с помощью кодека, затем обучите диффузионную модель:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_latent --emb_model_path AE_model_run/export.ts
after train --name diff_model_name --db_path /dataset/path_latent --emb_model_path AE_model_run/export.ts --config audio
4. Экспорт для работы в реальном времени
Экспортируйте с помощью after export для устройства Audio-to-Audio или after export_midi для устройства MIDI-to-Audio:
after export --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
after export_midi --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
Экспорт также создаёт латентную карту .png. README просит хранить её вместе с файлом .ts.
Как использовать AFTER в реальном времени: Max for Live и Max/MSP
Интеграция с Max for Live (M4L)
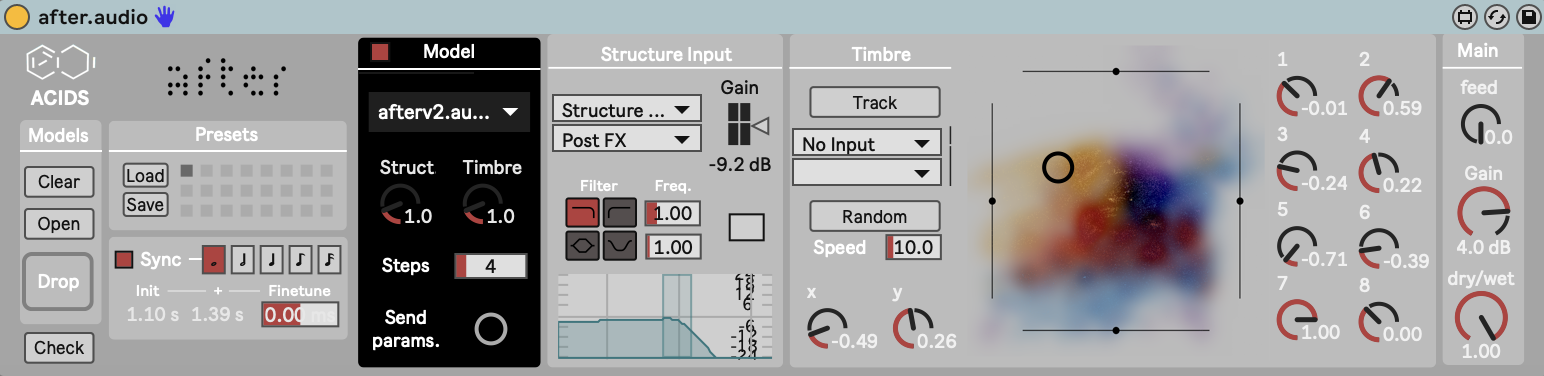
Для пользователей Ableton Live AFTER предлагает два устройства Max for Live, соединяющих Live с моделью.
Первое — Audio-to-Audio. Оно использует вход сайдчейна (например, ваш голос), чтобы управлять высотой тона и громкостью нейросетевой модели.
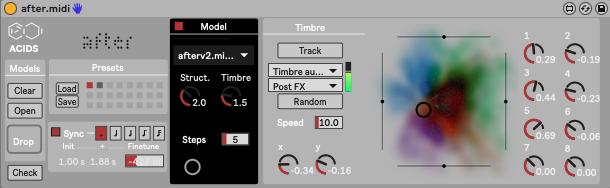
Второе — MIDI-to-Audio. Оно передаёт MIDI-ноты модели в виде структурного входа пианоролла. Благодаря архитектуре латентной диффузии оно поддерживает полифонию, если модель обучили на полифонических данных. Чтобы воспроизвести те же MIDI-ноты через записанные сэмплы, загрузите инструмент SFZ в sforzando.
Max/MSP и nn~
Для разработчиков AFTER работает внутри Max/MSP через внешний модуль nn~, который загружает экспортированные модели TorchScript (файлы .ts) прямо в патч.
Какова задержка AFTER?
AFTER ведёт себя иначе, чем однопроходные модели прямого распространения, такие как RAVE, поскольку диффузии требуется несколько шагов.
Задержка: Каждый шаг удаления шума добавляет вычисления, поэтому реализация реального времени обычно имеет задержку от 200 до 500 мс. AFTER генерирует аудио на ходу, но игра на ней больше напоминает игру через предсказуемую задержку, чем на мгновенно реагирующем инструменте. На живых выступлениях некоторые артисты вместо этого используют подход с «зацикливанием»: AFTER воспроизводит каждую фразу на следующем цикле петли. Для инструмента с мгновенной реакцией лучше подходят небольшие сети, такие как в бесплатных нейросетевых гитарных плагинах усилителей.
Использование GPU: Нейросетевой вывод работает через nn~, поддерживающий ускорение на GPU, но на практике пользователи замечают небольшую разницу. Поскольку диффузия итеративна, нагрузка на CPU остаётся высокой по сравнению с обычным DSP.
Вопросы об AFTER
Есть ли VST-плагин AFTER?
Нет. Официальный репозиторий предлагает устройства Max for Live для Ableton Live и патчи Max, работающие через nn~. В нём не упоминается плагин VST или AU.
Где находятся готовые модели AFTER?
IRCAM размещает готовые модели, готовые кодеки и патчи Max в общей папке, ссылка на которую есть в README AFTER.
AFTER — это то же самое, что IRCAMAX?
Нет. IRCAMAX — коммерческий набор устройств Max for Live от IRCAM, который продаёт Ableton. AFTER — исследовательская модель команды ACIDS из IRCAM с общедоступным кодом на GitHub.
AFTER или RAVE?
RAVE — однопроходная модель с меньшей задержкой, но её параметры управления представляют собой абстрактные латентные измерения. AFTER добавляет к кодеку явное управление высотой тона, громкостью и полифоническими MIDI-нотами, расплачиваясь большей задержкой и нагрузкой на CPU.