Modelo AFTER do IRCAM: instalação, modelos pré-treinados e treinamento
O modelo AFTER do IRCAM é um modelo de síntese de áudio neural que músicos podem controlar em tempo real e de forma polifônica com entradas familiares: notas MIDI ou a altura e o nível sonoro de outro sinal de áudio.
Para experimentar, baixe os modelos pré-treinados e os patches de Max da pasta compartilhada do IRCAM, instale o objeto externo nn~ e abra o patch no Max ou os dispositivos Max for Live no Ableton Live. Para treinar seu próprio modelo, instale o pacote Python pelo GitHub e siga as etapas de treinamento abaixo.

O que é o modelo AFTER?
AFTER significa Audio Features Transfer and Exploration in Real-time. Ele separa a expressão musical (estrutura) da identidade sonora (timbre) para que você possa modificar cada uma de forma independente.
Modelos anteriores de "caixa-preta" geram som a partir de coordenadas latentes abstratas difíceis de controlar. O AFTER usa controles explícitos. Você pode aplicar a execução de um instrumento, como a curva de altura de uma voz, ao timbre aprendido de outro, ou tocar o modelo inteiramente por MIDI. Diferentemente do DDSP, que acompanha apenas uma altura por vez, o AFTER pode tocar acordes por MIDI quando foi treinado com dados polifônicos.
Para mudar o estilo de uma música pronta em vez de uma única execução, o remix com IA preserva o stem vocal e regenera o instrumental a partir de um prompt de texto.
História e origem: a equipe ACIDS
O AFTER vem da pesquisa de doutorado de Nils Demerlé no IRCAM (Instituto de Pesquisa e Coordenação Acústica/Música), em Paris. Ele trabalhou no grupo ACIDS com Ninon Devis, Philippe Esling, Guillaume Doras e David Genova para lidar com uma limitação dos autoencoders variacionais (VAE).
Os VAE, como o modelo RAVE, comprimem bem o áudio, mas altura e timbre costumam acabar misturados nas mesmas dimensões latentes ("entrelaçamento"), tornando difícil controlá-los separadamente. A equipe apresentou sua solução no artigo "Combinação de controle de áudio e transferência de estilo usando difusão latente" em agosto de 2024. O objetivo era levar a qualidade de áudio dos modelos de difusão às apresentações musicais ao vivo.

Como o AFTER funciona? Arquitetura de difusão latente
O AFTER usa difusão latente condicional. Em vez de gerar amostras de áudio bruto uma por uma, o que é lento, ele trabalha em um espaço "latente" comprimido fornecido por um autoencoder pré-treinado.

Estrutura e timbre
O AFTER divide o som em dois fluxos:
- A estrutura (características locais): controles explícitos que variam com o tempo.
- Entrada de áudio: altura (f_0) e nível sonoro (com ponderação A).
- Entrada MIDI: representação polifônica em piano roll.
- O timbre (características globais): um vetor de representação aprendido que permanece fixo no tempo e representa a identidade do som, por exemplo "violoncelo" ou "guitarra distorcida".
Etapas do processamento
- Compressão (o codec): um codec de áudio neural, normalmente um autoencoder RAVE, comprime o áudio de entrada em vetores latentes de baixa dimensão.
- Condicionamento: o sistema extrai curvas de altura e nível sonoro com ferramentas como CREPE ou Basic Pitch para criar a condição de estrutura.
- Difusão latente: uma U-Net condicional prevê as representações latentes do áudio com base na estrutura e no timbre desejado.
- Decodificação: o codec de áudio decodifica as representações latentes previstas em formas de onda brutas.
Como treinar modelos AFTER
O treinamento tem três etapas. O repositório do AFTER no GitHub contém os scripts completos. Instale o AFTER em um ambiente Python 3.12:
git clone https://github.com/acids-ircam/AFTER.git
cd AFTER/
pip install -e .1. Preparação do conjunto de dados
Você precisa de um conjunto de dados de áudio, normalmente com mais de 1 hora para obter bons resultados (quanto áudio DDSP, RAVE e AFTER precisam). Se o instrumento desejado estiver misturado a outros, isole-o primeiro com separação de stems com IA de alta qualidade.
- Pré-processamento: o script
after prepare_datasetanalisa o áudio e extrai as características de referência. - Ferramentas: ele usa o Basic Pitch do Spotify para transcrição MIDI e extratores de nível sonoro para o áudio. Os dados são armazenados em um banco de dados LMDB para acesso rápido durante o treinamento.
- Confira a transcrição primeiro: para ouvir como seu material se transforma em notas antes de um treinamento longo, experimente a conversão de áudio para MIDI em um trecho curto. O guia de áudio para MIDI explica as etapas no Studio.
Primeiro, prepare um conjunto de dados de formas de onda para o autoencoder:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_audio --save_waveform True2. Treinamento do autoencoder (o codec)
Antes de treinar o modelo de difusão, você precisa de um "codec" que comprima o áudio.
- Opção A: treine um novo autoencoder causal com uma perda espectral multiescala e uma perda adversarial do tipo hinge.
- Opção B: use um codec pré-treinado da pasta compartilhada do IRCAM ou um modelo RAVE como mecanismo de execução. Isso é mais rápido se já existir um bom modelo para o seu tipo de áudio.
Na opção A, treine e exporte o autoencoder:
after train_autoencoder --name AE_model_name --db_path /dataset/path_audio --config AE_4096 --gpu 0
after export_autoencoder --model_path autoencoder_runs/AE_model_name
A exportação cria export.ts para processamento fora de tempo real e export_stream.ts para tempo real.
3. Treinamento do modelo de difusão
Nesta etapa, o modelo aprende como os sinais de controle se relacionam com o som.
- Objetivo: o modelo minimiza um erro de previsão de ruído (MSE). Em outras palavras, aprende a remover o ruído passo a passo até restar o som desejado.
- Desentrelaçamento: um critério adversarial penaliza o modelo quando o codificador de timbre capta informações de altura. Isso mantém os dois controles independentes.
Codifique o áudio com o codec e depois treine o modelo de difusão:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_latent --emb_model_path AE_model_run/export.ts
after train --name diff_model_name --db_path /dataset/path_latent --emb_model_path AE_model_run/export.ts --config audio
4. Exportação para uso em tempo real
Exporte com after export para o dispositivo Audio-to-Audio, ou com after export_midi para o dispositivo MIDI-to-Audio:
after export --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
after export_midi --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
A exportação também gera um mapa latente .png. O README pede que você o mantenha junto com o arquivo .ts.
Como usar o AFTER em tempo real: Max for Live e Max/MSP
Integração com Max for Live (M4L)
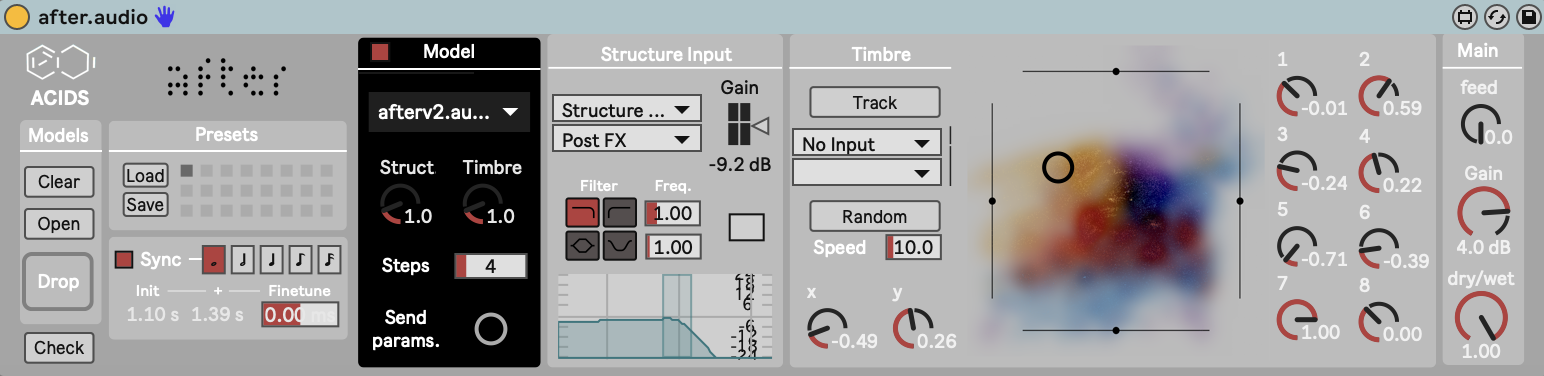
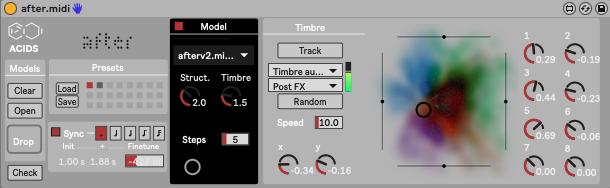
Para usuários do Ableton Live, o AFTER oferece dois dispositivos Max for Live que conectam o Live ao modelo.
O primeiro é o Audio-to-Audio. Ele usa uma entrada sidechain, como sua voz, para controlar a altura e o nível sonoro do modelo neural.
O segundo é o MIDI-to-Audio. Ele envia notas MIDI ao modelo como entrada de estrutura em piano roll. Graças à arquitetura de difusão latente, oferece suporte à polifonia quando o modelo foi treinado com dados polifônicos. Para tocar o mesmo MIDI com samples gravados, carregue um instrumento SFZ no sforzando.
Max/MSP e nn~
Para desenvolvedores, o AFTER funciona dentro do Max/MSP pelo objeto externo nn~, que carrega modelos TorchScript exportados (arquivos .ts) diretamente em um patch.
Qual é a latência do AFTER?
O AFTER se comporta de forma diferente de modelos de propagação direta em uma única passagem, como o RAVE, porque a difusão precisa de vários passos.
Latência: cada passo de remoção de ruído acrescenta cálculos, então a implementação em tempo real normalmente tem 200 a 500 ms de latência. O AFTER gera áudio durante a execução, mas tocá-lo se parece mais com tocar através de um atraso previsível do que com um instrumento instantâneo. Em apresentações ao vivo, alguns artistas preferem uma abordagem de "gravador de loops": o AFTER reproduz cada frase no próximo ciclo do loop. Para um instrumento que responde instantaneamente, redes pequenas como as dos plugins neurais gratuitos de amplificadores de guitarra são mais adequadas.
Uso de GPU: a inferência é executada por nn~, que aceita aceleração por GPU, mas na prática os usuários percebem pouca diferença. Como a difusão é iterativa, o uso de CPU continua alto em comparação com DSP padrão.
Perguntas frequentes sobre AFTER
Existe um plugin VST do AFTER?
Não. O repositório oficial oferece dispositivos Max for Live para Ableton Live e patches de Max que funcionam por nn~. Ele não menciona um plugin VST ou AU.
Onde estão os modelos AFTER pré-treinados?
O IRCAM hospeda modelos pré-treinados, codecs pré-treinados e patches de Max em uma pasta compartilhada vinculada no README do AFTER.
AFTER é a mesma coisa que IRCAMAX?
Não. IRCAMAX é um pacote comercial de dispositivos Max for Live do IRCAM, vendido pela Ableton. O AFTER é um modelo de pesquisa da equipe ACIDS do IRCAM com código público no GitHub.
AFTER ou RAVE?
RAVE é um modelo de uma única passagem com menor latência, mas seus controles são dimensões latentes abstratas. O AFTER acrescenta controle explícito de altura, nível sonoro e MIDI polifônico sobre um codec, ao custo de mais latência e uso de CPU.