Guia DDSP: VST Magenta DDSP, treinamento e funcionamento
DDSP (processamento digital de sinais diferenciável, de Differentiable Digital Signal Processing) é a biblioteca de código aberto da Google Magenta que permite a uma rede neural controlar geradores de som clássicos: osciladores, ruído filtrado e reverberação. A Magenta arquivou o VST DDSP em 2024, mas o plugin gratuito ainda pode ser baixado e executado no Windows e no macOS. Você também pode treinar seu próprio modelo de instrumento em um notebook gratuito do Google Colab.
Este guia começa com essas duas etapas práticas. Depois, explica como o DDSP funciona, quais são suas limitações e quais modelos mais recentes o substituíram.
Como usar o DDSP hoje: início rápido
Baixar e instalar o VST DDSP
- Baixe o plugin para macOS ou Windows. Os dois links vêm do repositório oficial do VST DDSP.
- Descompacte o arquivo. Ele contém dois plugins: DDSP Effect, que transforma o áudio de entrada, como sua voz, no som de um instrumento, e DDSP Synth, que você toca via MIDI.
- No macOS, copie-os para
/Library/Audio/Plug-Ins/Components(AU) e/Library/Audio/Plug-Ins/VST3. No Windows, copie os arquivos VST3 paraC:\Program Files\Common Files\VST3. - Faça uma nova busca de plugins na sua DAW.
Não há uma versão oficial para Linux. Para ouvir o DDSP sem instalar nada, experimente a demonstração web do Tone Transfer.
Treinar seu próprio instrumento DDSP
O notebook de treinamento do VST DDSP da Magenta funciona no Google Colab, então você não precisa de uma GPU local:
- Coloque pelo menos 10 minutos de áudio
.wavou.mp3em uma pasta do Google Drive. Use áudio monofônico, uma nota por vez, de uma única sessão de gravação, com o mesmo microfone e na mesma sala. - Abra o notebook, execute a célula de instalação, que leva cerca de 5 minutos, e depois execute a célula de treinamento e selecione sua pasta.
- Aguarde. O treinamento leva cerca de 2 a 3 horas no Colab gratuito e menos de uma hora no Colab Pro+. Se o Colab desconectar, execute a célula novamente com a mesma pasta para retomar o treinamento.
- Descompacte a pasta do modelo baixado dentro da pasta de modelos do plugin. No Mac, ela fica em
~/Documents/Magenta/DDSP/Models, e você também pode abri-la pelo próprio plugin.
O notebook informa que bons resultados costumam aparecer após 30.000 a 50.000 etapas de treinamento. Poucas etapas deixam o som sem expressão; etapas demais podem causar falhas intermitentes e grandes saltos de volume.
História e evolução: da Magenta aos plugins atuais
Laboratório de pesquisa Magenta (2016-2024)
O Google lançou a Magenta em 2016 como um projeto de pesquisa de código aberto sobre aprendizado de máquina para música e arte. Ele lançou muitas ferramentas de geração musical, mas a maioria de seus projetos já havia sido arquivada em 2024.
Open NSynth Super (2017)
Antes do DDSP, a Magenta apresentou o Open NSynth Super, um instrumento físico baseado no NSynth. O conjunto de dados NSynth contém cerca de 305.000 amostras de notas individuais de 1.006 instrumentos. O dispositivo, construído com um Raspberry Pi e uma placa de circuito impresso personalizada, permitia transformar gradualmente o som entre instrumentos em tempo real.
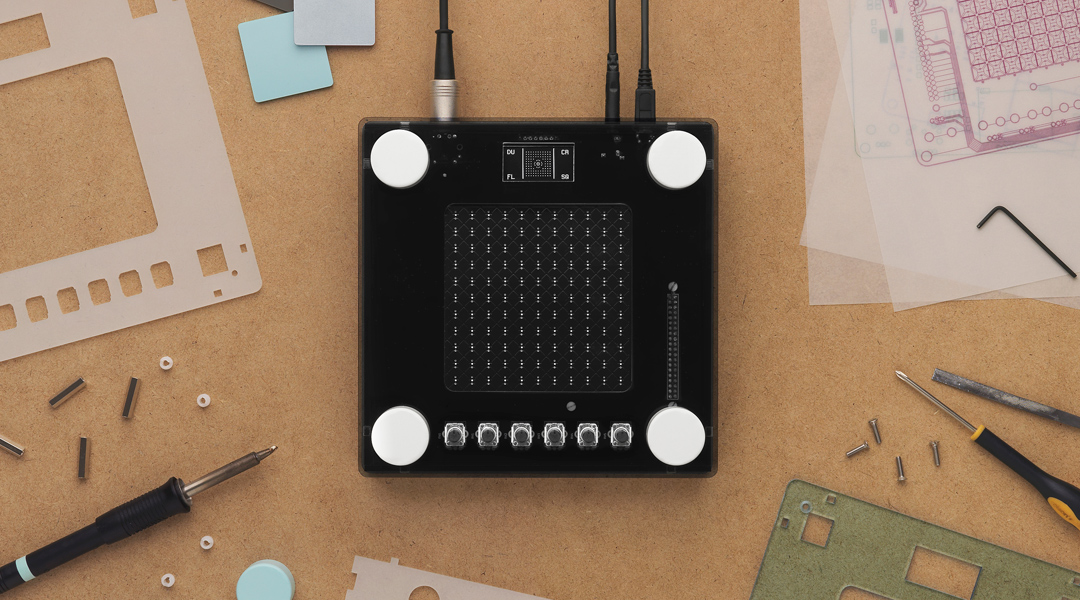
O modelo NSynth, um autoencoder no estilo WaveNet, estava limitado a áudio de 16 bits/16 kHz devido ao custo computacional, por isso o resultado tem um som claramente lo-fi. O engenheiro de áudio Joe Boston o descreveu como "granulado", mas encontrou usos criativos ao processá-lo com efeitos externos. O projeto de hardware foi arquivado em agosto de 2025.
DDSP e Tone Transfer (2020)
Em 2020, a Magenta publicou a biblioteca DDSP e seu artigo na ICLR, que introduziu versões diferenciáveis de módulos comuns de processamento de sinais. A demonstração web do Tone Transfer permitia transformar gravações, como voz cantada, em violino, saxofone, trompete ou flauta.
Os modelos eram autoencoders baseados em RNN, treinados com cerca de 10 minutos de áudio monofônico por instrumento. A demonstração funcionava, mas a saída a 16 kHz e a modelagem limitada das articulações restringiam seus recursos.
MIDI DDSP e o plugin VST (2022-2024)
A Magenta ampliou o DDSP com o MIDI DDSP em janeiro de 2022. Ele sintetiza áudio de instrumentos diretamente a partir de sequências MIDI monofônicas. Para tocar amostras gravadas via MIDI em vez de usar um modelo neural, carregue um instrumento SFZ no player gratuito sforzando.
Em junho de 2022, a Magenta lançou o plugin VST DDSP para transferência de timbre em tempo real em uma DAW. Os dois projetos foram arquivados em 2024: MIDI DDSP em fevereiro e o VST em outubro.

Plugin de áudio MAWF (2023)
Hanoi Hantrakul (yaboihanoi), ex-líder técnico do Tone Transfer e na ByteDance desde 2020, lançou o MAWF em 2023. O plugin VST/AU gratuito executa síntese de áudio neural em tempo real a 48 kHz, eliminando o limite de 16 kHz das primeiras implementações do DDSP.

Como o DDSP funciona? Autoencoders encontram DSP
O DDSP é um autoencoder cujo decodificador controla componentes DSP modulares em vez de gerar diretamente a forma de onda.
Arquitetura do autoencoder DDSP
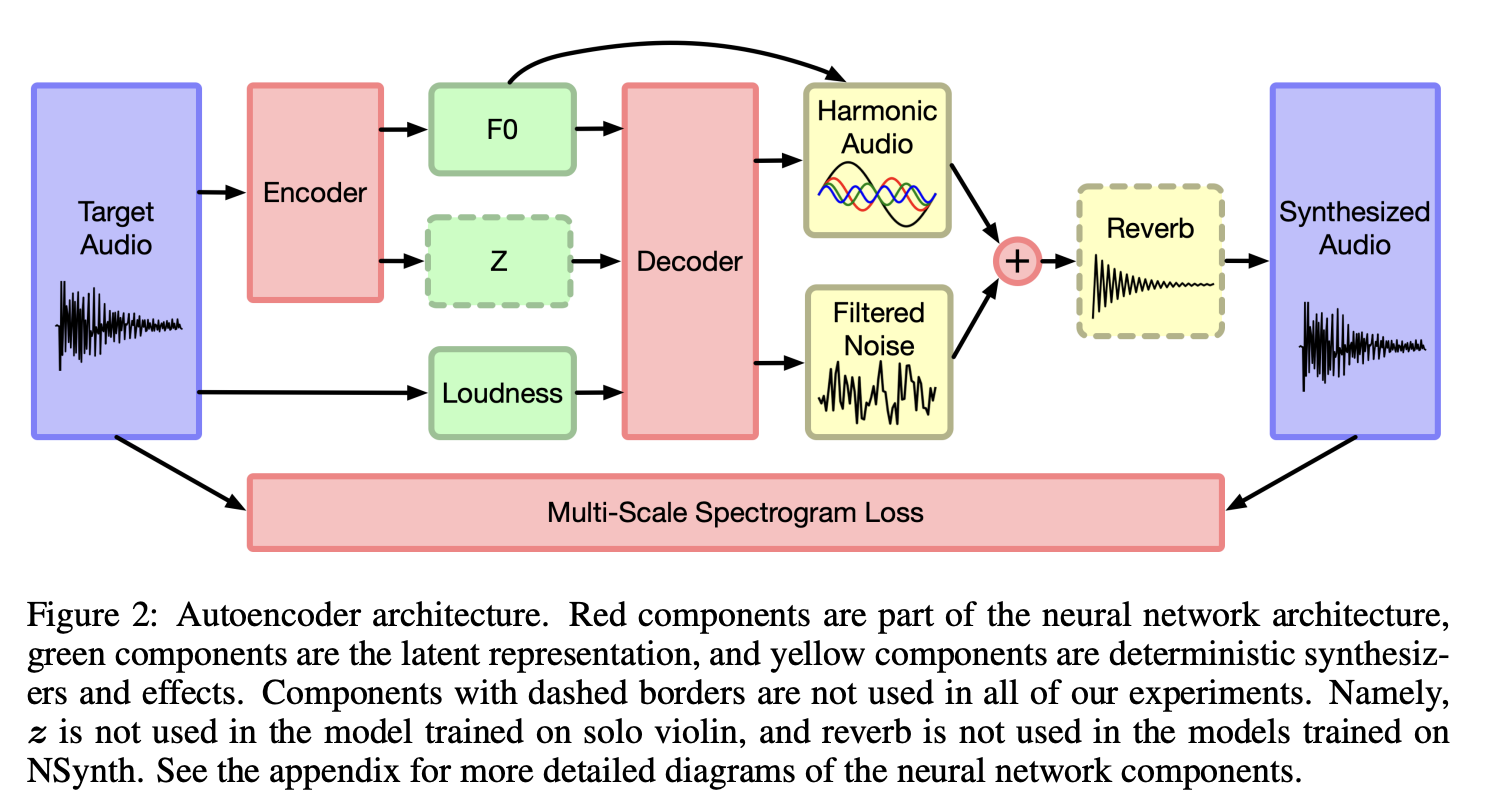
Figura original: Arquitetura do autoencoder DDSP.
Codificador
O codificador transforma o áudio de entrada em duas curvas de controle: a frequência fundamental (f0, a altura da nota), estimada com um rastreador de altura CREPE pré-treinado, e a sonoridade, calculada diretamente a partir do sinal. Um codificador residual opcional, uma GRU aplicada aos MFCCs, acrescenta um vetor latente para os detalhes de timbre que a altura e a sonoridade não capturam. Esses sinais de baixa dimensionalidade descrevem a execução musical.
Decodificador e módulos de síntese
Um decodificador recorrente (GRU) transforma os sinais de controle em parâmetros para três componentes DSP:
- Sintetizador aditivo harmônico: gera até 100 parciais senoidais em múltiplos da frequência fundamental para a parte do som com altura definida.
- Sintetizador de ruído filtrado: molda o ruído branco com filtros FIR que variam no tempo para modelar o sopro e o ruído do arco.
- Reverberação diferenciável: acrescenta a acústica de uma sala por meio de uma resposta ao impulso aprendida.
Cada componente é diferenciável, então o modelo inteiro é treinado de ponta a ponta com uma perda espectral multiescala. Ele prevê centenas de parâmetros de síntese por quadro em vez de gerar o áudio amostra por amostra.
Treinamento de modelos DDSP para pesquisa
Para um modelo que você vai tocar no VST DDSP, use o notebook de treinamento do VST DDSP descrito no início rápido acima. Para alterar a arquitetura ou a função de perda, comece pelos tutoriais do Colab da biblioteca. Eles exigem conhecimentos básicos de Python e abordam pré-processamento, configuração e treinamento em uma GPU do Colab.
Plugins DDSP para uso em tempo real
Os projetos oficiais da Magenta estão arquivados, mas você ainda pode usar o DDSP em uma DAW com estas ferramentas:
1. VST Magenta DDSP (arquivado)
O VST DDSP oficial ainda funciona para experimentar; consulte as etapas de instalação no início rápido acima. Ele inclui cinco modelos de instrumentos e aceita entrada MIDI e de áudio. Os usuários relatam muita reverberação na saída, que parece mascarar os artefatos.
2. Plataforma Neutone FX
O Neutone FX oferece um plugin gratuito que hospeda modelos treinados pela comunidade, incluindo redes de transferência de timbre baseadas em DDSP. Ele dá aos produtores acesso a dezenas de modelos além dos instrumentos originais da Magenta.

3. MAWF de yaboihanoi (recomendado)
O plugin MAWF executa a síntese DDSP a 48 kHz dentro da sua DAW. Ele inclui vários modelos de instrumentos e é a implementação DDSP mais refinada disponível.

No entanto, o site de download do MAWF está fora do ar desde novembro de 2025. Atualizarei este artigo se encontrar outra fonte para o plugin.
Quais são as limitações do DDSP?
As limitações do DDSP vêm de sua arquitetura e de sua abordagem de síntese:
- Somente monofônico: os modelos DDSP não conseguem gerar áudio polifônico. Eles foram treinados com gravações monofônicas, e o sintetizador harmônico pressupõe uma única frequência fundamental a cada passo de tempo.
- Qualidade de áudio: os modelos MAWF de 48 kHz soam melhor, mas as implementações originais de 16 kHz apresentam artefatos metálicos e pouco conteúdo de alta frequência. Um modelo de super-resolução de áudio pode regenerar os agudos que faltam em renderizações antigas: veja como instalar e executar o AudioSR do GitHub, ou como o UniverSR restaurou a 48 kHz efeitos sonoros do RPG Maker de 22 kHz.
- Paralelismo limitado em GPU: as camadas recorrentes processam os quadros um após o outro, então o modelo não pode paralelizar o processamento temporal em uma GPU como os modelos convolucionais.
Além do DDSP: RAVE, DDSP-CNN-Tiny e AFTER
RAVE (2021)
O RAVE usa CNNs causais em vez de RNNs, o que traz treinamento mais rápido e síntese a 48 kHz, além de uma melhor modelagem de timbre. Ele é um autoencoder variacional refinado com treinamento adversarial com um discriminador e alcança maior fidelidade com uma quantidade semelhante de dados.
DDSP-CNN-Tiny (2022)
O DDSP-CNN-Tiny substitui as RNNs do DDSP por CNNs leves, o que reduz o tamanho do modelo e acelera a inferência. A qualidade de áudio continua comparável, e ele funciona em tempo real em CPU. Redes pequenas executadas em CPU também são a base dos plugins neurais gratuitos de amplificador de guitarra, como NAM e AIDA-X. Václav Volhejn o desenvolveu para sua tese na ETH Zurich, e sua tese sobre DDSP em tempo real é uma ótima leitura técnica.
AFTER (2024)
O modelo AFTER executa difusão latente sobre um codec de áudio neural para alcançar síntese com qualidade de estúdio. Ele exige mais processamento que o DDSP, mas sua transferência de timbre tem muito menos artefatos, o que o torna mais adequado para produção profissional.
Perguntas frequentes sobre DDSP
O Magenta DDSP ainda recebe manutenção?
Em parte. A biblioteca ddsp não está arquivada e ainda recebe commits. A Magenta arquivou o MIDI DDSP em fevereiro de 2024 e o VST DDSP em outubro de 2024, então o plugin não recebe atualizações. Os downloads do plugin e o notebook de treinamento ainda funcionavam quando este guia foi atualizado em outubro de 2026.
O VST DDSP funciona no Linux?
Não há uma versão oficial para Linux. Você teria que compilá-lo por conta própria a partir do código-fonte.
O DDSP consegue tocar acordes?
Não. Os modelos DDSP são monofônicos: acompanham uma altura por vez. Para controle MIDI polifônico, veja o AFTER.
DDSP ou RAVE: qual devo treinar?
Escolha o DDSP para um único instrumento de altura definida quando você tiver apenas cerca de 10 minutos de áudio e uma GPU gratuita do Colab. Escolha o RAVE para qualquer tipo de som, incluindo bateria, texturas e vozes. O RAVE precisa de algumas horas de áudio e dias de treinamento em GPU. As perguntas frequentes comparam quanto áudio de treinamento DDSP, RAVE e AFTER precisam e explicam qual plugin toca cada modelo treinado na sua DAW.