Poradnik DDSP: Magenta DDSP VST, trening i zasada działania
DDSP (różniczkowalne cyfrowe przetwarzanie sygnałów) to biblioteka Google Magenta o otwartym kodzie źródłowym, która pozwala sieci neuronowej sterować klasycznymi generatorami dźwięku: oscylatorami, filtrowanym szumem i pogłosem. Magenta zarchiwizowała DDSP VST w 2024 roku, ale darmową wtyczkę nadal można pobrać i uruchomić na Windows i macOS. Możesz też wytrenować własny model instrumentu w darmowym notatniku Google Colab.
Poradnik zaczyna się od tych dwóch praktycznych kroków. Następnie wyjaśnia, jak działa DDSP, jakie ma ograniczenia i jakie nowsze modele go zastąpiły.
Jak korzystać z DDSP dziś: szybki start
Pobierz i zainstaluj DDSP VST
- Pobierz wtyczkę dla macOS lub Windows. Oba linki pochodzą z oficjalnego repozytorium DDSP VST.
- Rozpakuj plik. Zawiera dwie wtyczki: DDSP Effect, która zamienia wejściowe audio (na przykład twój głos) w instrument, oraz DDSP Synth, na której grasz za pomocą MIDI.
- Na macOS skopiuj je do
/Library/Audio/Plug-Ins/Components(AU) i/Library/Audio/Plug-Ins/VST3. Na Windows skopiuj pliki VST3 doC:\Program Files\Common Files\VST3. - Ponownie przeskanuj wtyczki w swoim DAW.
Nie ma oficjalnej wersji dla Linux. Aby posłuchać DDSP bez instalowania czegokolwiek, wypróbuj internetowe demo Tone Transfer.
Wytrenuj własny instrument DDSP
Notatnik treningowy DDSP VST od Magenta działa w Google Colab, więc nie potrzebujesz lokalnego GPU:
- Umieść co najmniej 10 minut audio
.wavlub.mp3w folderze Google Drive. Użyj monofonicznego audio (jedna nuta naraz) z jednej sesji nagraniowej, z tym samym mikrofonem i w tym samym pomieszczeniu. - Otwórz notatnik, uruchom komórkę instalacji (około 5 minut), następnie komórkę treningu i wybierz swój folder.
- Poczekaj. Trening zajmuje około 2 do 3 godzin w darmowym Colab i mniej niż godzinę w Colab Pro+. Jeśli Colab się rozłączy, uruchom komórkę ponownie z tym samym folderem, a trening zostanie wznowiony.
- Rozpakuj pobrany folder modelu do folderu modeli wtyczki. Na Macu jest to
~/Documents/Magenta/DDSP/Models; możesz też otworzyć go z poziomu wtyczki.
Notatnik podaje, że dobre wyniki zwykle pojawiają się po wykonaniu od 30 000 do 50 000 kroków treningu. Zbyt mało kroków daje nijakie brzmienie; zbyt wiele może powodować przerywanie dźwięku i duże skoki głośności.
Historia i rozwój: od Magenta do współczesnych wtyczek
Laboratorium badawcze Magenta (2016-2024)
Google uruchomiło Magenta w 2016 roku jako projekt badawczy o otwartym kodzie dotyczący uczenia maszynowego w muzyce i sztuce. Udostępniło wiele narzędzi do generowania muzyki, ale do 2024 roku większość jego projektów była już zarchiwizowana.
Open NSynth Super (2017)
Przed DDSP Magenta przedstawiła Open NSynth Super, sprzętowy instrument oparty na NSynth. Zbiór danych NSynth zawiera około 305 000 próbek pojedynczych nut z 1 006 instrumentów. Urządzenie zbudowane na Raspberry Pi i własnej płytce drukowanej pozwalało muzykom płynnie przechodzić między brzmieniami instrumentów w czasie rzeczywistym.
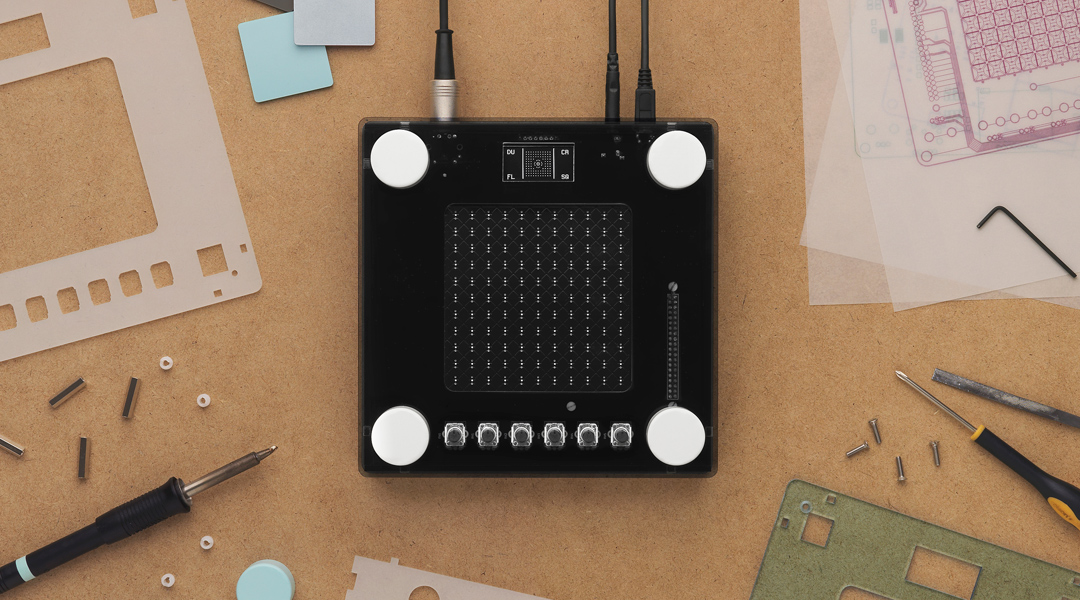
Model NSynth, autoenkoder w stylu WaveNet, był ograniczony do audio 16-bitowego/16 kHz z powodu kosztu obliczeń, więc wynik wyraźnie brzmi w stylu lo-fi. Realizator dźwięku Joe Boston opisał je jako „ziarniste”, ale znalazł dla niego kreatywne zastosowania, przepuszczając je przez zewnętrzne efekty. Projekt sprzętowy zarchiwizowano w sierpniu 2025 roku.
DDSP i Tone Transfer (2020)
W 2020 roku Magenta opublikowała bibliotekę DDSP i artykuł ICLR, który wprowadził różniczkowalne wersje popularnych modułów przetwarzania sygnałów. Internetowe demo Tone Transfer pozwalało zamieniać nagrania, na przykład śpiew, w skrzypce, saksofon, trąbkę lub flet.
Modele były autoenkoderami opartymi na RNN, trenowanymi na około 10 minutach monofonicznego audio dla każdego instrumentu. Demo działało, ale wyjście 16 kHz i ograniczone modelowanie artykulacji hamowały jego możliwości.
MIDI DDSP i wtyczka VST (2022-2024)
Magenta rozszerzyła DDSP o MIDI DDSP w styczniu 2022 roku. Syntezuje on audio instrumentu bezpośrednio z monofonicznych sekwencji MIDI. Aby odtwarzać MIDI przy użyciu nagranych próbek zamiast modelu neuronowego, załaduj instrument SFZ w darmowym odtwarzaczu sforzando.
W czerwcu 2022 roku Magenta wydała wtyczkę DDSP VST do transferu barwy w czasie rzeczywistym w DAW. Oba projekty zarchiwizowano w 2024 roku: MIDI DDSP w lutym, a VST w październiku.

Wtyczka audio MAWF (2023)
Hanoi Hantrakul (yaboihanoi), były lider techniczny Tone Transfer, pracujący w ByteDance od 2020 roku, udostępnił MAWF w 2023 roku. Darmowa wtyczka VST/AU zapewnia neuronową syntezę audio w czasie rzeczywistym przy 48 kHz, usuwając ograniczenie 16 kHz wcześniejszych implementacji DDSP.

Jak działa DDSP? Autoenkodery spotykają DSP
DDSP to autoenkoder, którego dekoder steruje modułowymi komponentami DSP zamiast bezpośrednio generować przebieg falowy.
Architektura autoenkodera DDSP
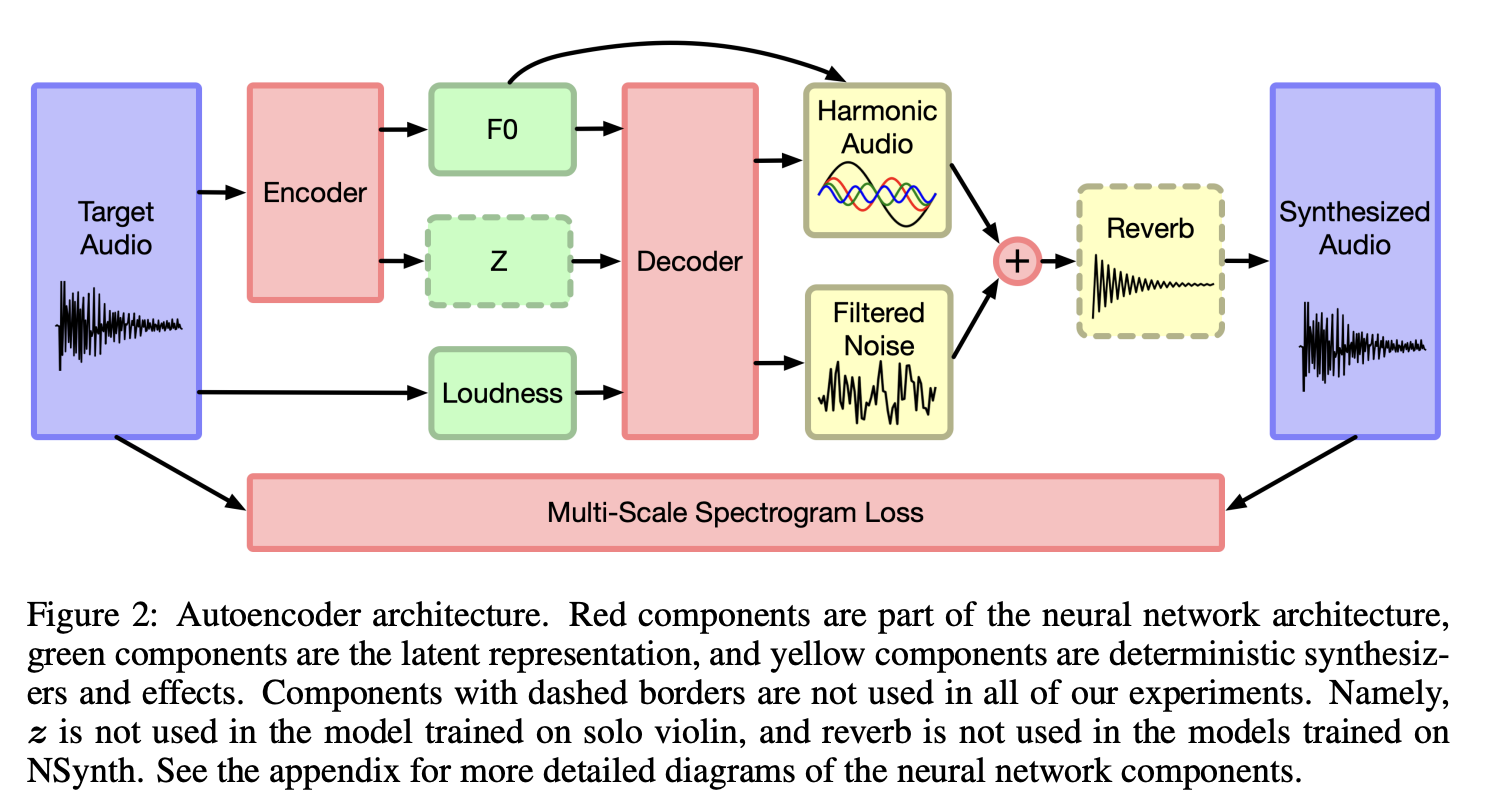
Oryginalny diagram: Architektura autoenkodera DDSP.
Enkoder
Enkoder zamienia wejściowe audio w dwie krzywe sterujące: częstotliwość podstawową (f0, wysokość dźwięku), szacowaną przez wstępnie wytrenowany detektor wysokości CREPE, oraz głośność, obliczaną bezpośrednio z sygnału. Opcjonalny enkoder resztkowy (GRU przetwarzający MFCC) dodaje wektor ukryty opisujący szczegóły barwy, których nie obejmują wysokość i głośność. Te sygnały o niskiej wymiarowości opisują wykonanie.
Dekoder i moduły syntezy
Dekoder rekurencyjny (GRU) odwzorowuje sygnały sterujące na parametry trzech komponentów DSP:
- Harmoniczny syntezator addytywny: generuje do 100 sinusoidalnych składowych o częstotliwościach będących wielokrotnościami częstotliwości podstawowej dla tonalnej części dźwięku.
- Syntezator filtrowanego szumu: kształtuje biały szum za pomocą zmiennych w czasie filtrów FIR, aby modelować szum oddechu i smyczka.
- Różniczkowalny pogłos: dodaje akustykę pomieszczenia za pomocą wyuczonej odpowiedzi impulsowej.
Każdy komponent jest różniczkowalny, więc cały model trenuje się od początku do końca z wieloskalową spektralną funkcją straty. Przewiduje setki parametrów syntezy na klatkę zamiast generować audio próbka po próbce.
Trening modeli DDSP do badań
Dla modelu, którego będziesz używać w DDSP VST, skorzystaj z notatnika treningowego DDSP VST opisanego w szybkim starcie powyżej. Aby zmienić architekturę lub funkcję straty, zacznij od samouczków biblioteki w Colab. Wymagają podstawowej znajomości Python i obejmują przetwarzanie wstępne, konfigurację oraz trening na GPU Colab.
Wtyczki DDSP do pracy w czasie rzeczywistym
Oficjalne projekty Magenta są zarchiwizowane, ale nadal możesz uruchamiać DDSP w DAW za pomocą tych narzędzi:
1. Magenta DDSP VST (zarchiwizowany)
Oficjalny DDSP VST nadal działa do eksperymentów (instrukcja instalacji znajduje się w szybkim starcie powyżej). Zawiera pięć modeli instrumentów i przyjmuje wejście MIDI oraz audio. Użytkownicy zgłaszają silny pogłos na wyjściu, który wydaje się maskować artefakty.
2. Platforma Neutone FX
Neutone FX oferuje darmową wtyczkę, która uruchamia modele wytrenowane przez społeczność, w tym sieci transferu barwy oparte na DDSP. Daje producentom dostęp do dziesiątek modeli poza oryginalnymi instrumentami Magenta.

3. MAWF od yaboihanoi (polecany)
Wtyczka MAWF wykonuje syntezę DDSP przy 48 kHz w twoim DAW. Zawiera kilka modeli instrumentów i jest najbardziej dopracowaną dostępną implementacją DDSP.

Jednak strona pobierania MAWF nie działa od listopada 2025 roku. Zaktualizuję artykuł, jeśli znajdę inne źródło wtyczki.
Jakie ograniczenia ma DDSP?
Ograniczenia DDSP wynikają z architektury i sposobu syntezy:
- Tylko monofonia: modele DDSP nie mogą generować polifonicznego audio. Trenowano je na monofonicznych nagraniach, a syntezator harmoniczny zakłada jedną częstotliwość podstawową w każdym kroku czasowym.
- Jakość audio: modele MAWF przy 48 kHz brzmią lepiej, ale oryginalne implementacje 16 kHz mają metaliczne artefakty i mało wysokich częstotliwości. Model zwiększania rozdzielczości audio może odtworzyć brakującą górę starszych renderów: zobacz jak zainstalować i uruchomić AudioSR z GitHub lub jak UniverSR odtworzył efekty dźwiękowe RPG Maker z 22 kHz do 48 kHz.
- Ograniczona równoległość GPU: warstwy rekurencyjne przetwarzają klatki jedna po drugiej, więc model nie może równolegle przetwarzać kolejnych kroków czasowych na GPU tak jak modele konwolucyjne.
Po DDSP: RAVE, DDSP-CNN-Tiny i AFTER
RAVE (2021)
RAVE używa przyczynowych CNN zamiast RNN, co zapewnia szybszy trening i syntezę przy 48 kHz oraz lepsze modelowanie barwy. To autoenkoder wariacyjny dopracowany przez trening adwersarialny (z dyskryminatorem), który osiąga wyższą wierność dźwięku przy podobnej ilości danych.
DDSP-CNN-Tiny (2022)
DDSP-CNN-Tiny zastępuje RNN z DDSP lekkimi CNN, zmniejszając model i przyspieszając inferencję. Jakość audio pozostaje porównywalna, a model działa w czasie rzeczywistym na CPU. Małe sieci na CPU są też podstawą działania darmowych neuronowych wtyczek wzmacniaczy gitarowych, takich jak NAM i AIDA-X. Václav Volhejn opracował model do swojej pracy dyplomowej na ETH Zurich, a jego praca o DDSP w czasie rzeczywistym to wartościowa lektura techniczna.
AFTER (2024)
Model AFTER uruchamia dyfuzję w przestrzeni ukrytej nad neuronowym kodekiem audio, aby osiągnąć syntezę jakości studyjnej. Wymaga więcej obliczeń niż DDSP, ale jego transfer barwy ma znacznie mniej artefaktów, co lepiej pasuje do profesjonalnej produkcji.
Pytania o DDSP
Czy Magenta DDSP jest nadal utrzymywany?
Częściowo. Biblioteka ddsp nie jest zarchiwizowana i nadal otrzymuje commity. Magenta zarchiwizowała MIDI DDSP w lutym 2024 roku i DDSP VST w październiku 2024 roku, więc wtyczka nie dostaje aktualizacji. Pobieranie wtyczki i notatnik treningowy nadal działały, gdy poradnik aktualizowano w październiku 2026 roku.
Czy DDSP VST działa na Linux?
Nie ma oficjalnej wersji dla Linux. Trzeba samodzielnie zbudować ją z kodu źródłowego.
Czy DDSP może grać akordy?
Nie. Modele DDSP są monofoniczne: śledzą jedną wysokość dźwięku naraz. Do polifonicznego sterowania MIDI sprawdź AFTER.
DDSP czy RAVE: który model trenować?
Wybierz DDSP dla jednego instrumentu o określonej wysokości dźwięku, gdy masz tylko około 10 minut audio i darmowe GPU Colab. Wybierz RAVE dla dowolnych dźwięków, w tym perkusji, tekstur i głosów. RAVE potrzebuje kilku godzin audio i dni treningu na GPU. FAQ porównuje ile audio treningowego potrzebują DDSP, RAVE i AFTER oraz która wtyczka odtwarza każdy wytrenowany model w DAW.