Guida DDSP: VST Magenta DDSP, addestramento e funzionamento
DDSP (elaborazione digitale del segnale differenziabile, dall'inglese Differentiable Digital Signal Processing) è la libreria open source di Google Magenta che permette a una rete neurale di controllare generatori sonori classici: oscillatori, rumore filtrato e riverbero. Magenta ha archiviato il VST DDSP nel 2024, ma il plugin gratuito si può ancora scaricare e usare su Windows e macOS. Puoi anche addestrare il tuo modello di strumento in un notebook gratuito di Google Colab.
Questa guida inizia con questi due passaggi pratici. Poi spiega come funziona DDSP, quali sono i suoi limiti e quali modelli più recenti lo hanno sostituito.
Come usare DDSP oggi: guida rapida
Scaricare e installare il VST DDSP
- Scarica il plugin per macOS o Windows. Entrambi i link provengono dal repository ufficiale del VST DDSP.
- Decomprimi il file. Contiene due plugin: DDSP Effect, che trasforma l'audio in ingresso, per esempio la tua voce, nel suono di uno strumento, e DDSP Synth, che suoni tramite MIDI.
- Su macOS, copiali in
/Library/Audio/Plug-Ins/Components(AU) e/Library/Audio/Plug-Ins/VST3. Su Windows, copia i file VST3 inC:\Program Files\Common Files\VST3. - Esegui una nuova scansione dei plugin nella tua DAW.
Non esiste una versione ufficiale per Linux. Per ascoltare DDSP senza installare nulla, prova la demo web di Tone Transfer.
Addestrare il tuo strumento DDSP
Il notebook di addestramento del VST DDSP di Magenta viene eseguito in Google Colab, quindi non serve una GPU locale:
- Metti almeno 10 minuti di audio
.wavo.mp3in una cartella di Google Drive. Usa audio monofonico, una nota alla volta, da un'unica sessione di registrazione, con lo stesso microfono e nella stessa stanza. - Apri il notebook, esegui la cella di installazione, che richiede circa 5 minuti, poi esegui la cella di addestramento e seleziona la tua cartella.
- Attendi. L'addestramento richiede circa 2-3 ore su Colab gratuito e meno di un'ora su Colab Pro+. Se Colab si disconnette, esegui di nuovo la cella con la stessa cartella per riprendere l'addestramento.
- Decomprimi la cartella del modello scaricato nella cartella dei modelli del plugin. Su Mac si trova in
~/Documents/Magenta/DDSP/Models, e puoi aprirla anche dall'interno del plugin.
Il notebook indica che di solito si ottengono buoni risultati dopo un numero di passi di addestramento compreso tra 30.000 e 50.000. Con troppo pochi passi il suono risulta poco espressivo; con troppi possono comparire interruzioni e forti sbalzi di volume.
Storia ed evoluzione: da Magenta ai plugin attuali
Il laboratorio di ricerca Magenta (2016-2024)
Google ha lanciato Magenta nel 2016 come progetto di ricerca open source sull'apprendimento automatico per musica e arte. Ha pubblicato molti strumenti di generazione musicale, ma la maggior parte dei suoi progetti era già stata archiviata entro il 2024.
Open NSynth Super (2017)
Prima di DDSP, Magenta ha presentato Open NSynth Super, uno strumento hardware basato su NSynth. Il dataset NSynth contiene circa 305.000 campioni di note singole da 1.006 strumenti. Il dispositivo, costruito con un Raspberry Pi e una scheda a circuito stampato personalizzata, permetteva di trasformare gradualmente il suono tra strumenti diversi in tempo reale.
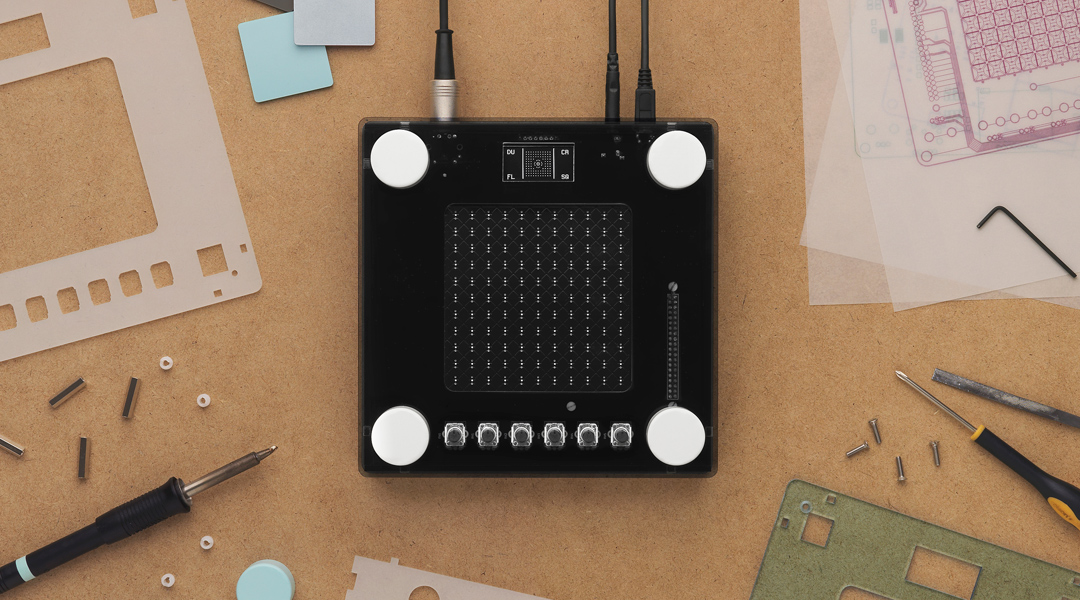
Il modello NSynth, un autoencoder di tipo WaveNet, era limitato ad audio a 16 bit/16 kHz per il suo costo computazionale, quindi il risultato ha un carattere decisamente lo-fi. L'ingegnere del suono Joe Boston lo descriveva come "granuloso", ma gli ha trovato impieghi creativi usando effetti esterni. Il progetto hardware è stato archiviato nell'agosto 2025.
DDSP e Tone Transfer (2020)
Nel 2020, Magenta ha pubblicato la libreria DDSP e il suo articolo all'ICLR, che presentava versioni differenziabili di moduli comuni di elaborazione del segnale. La demo web di Tone Transfer permetteva di trasformare registrazioni, per esempio il canto, in violino, sassofono, tromba o flauto.
I modelli erano autoencoder basati su RNN, addestrati con circa 10 minuti di audio monofonico per strumento. La demo funzionava, ma l'uscita a 16 kHz e la modellazione limitata delle articolazioni ne riducevano le possibilità.
MIDI DDSP e il plugin VST (2022-2024)
Magenta ha esteso DDSP con MIDI DDSP nel gennaio 2022. Sintetizza audio strumentale direttamente da sequenze MIDI monofoniche. Per suonare campioni registrati tramite MIDI invece di usare un modello neurale, carica uno strumento SFZ nel player gratuito sforzando.
Nel giugno 2022, Magenta ha pubblicato il plugin VST DDSP per il trasferimento timbrico in tempo reale in una DAW. Entrambi i progetti sono stati archiviati nel 2024: MIDI DDSP a febbraio e il VST a ottobre.

Il plugin audio MAWF (2023)
Hanoi Hantrakul (yaboihanoi), ex responsabile tecnico di Tone Transfer e in ByteDance dal 2020, ha lanciato MAWF nel 2023. Il plugin gratuito VST/AU esegue sintesi audio neurale in tempo reale a 48 kHz, eliminando il limite di 16 kHz delle prime implementazioni di DDSP.

Come funziona DDSP? Autoencoder e DSP si incontrano
DDSP è un autoencoder il cui decoder controlla componenti DSP modulari invece di generare direttamente la forma d'onda.
Architettura dell'autoencoder DDSP
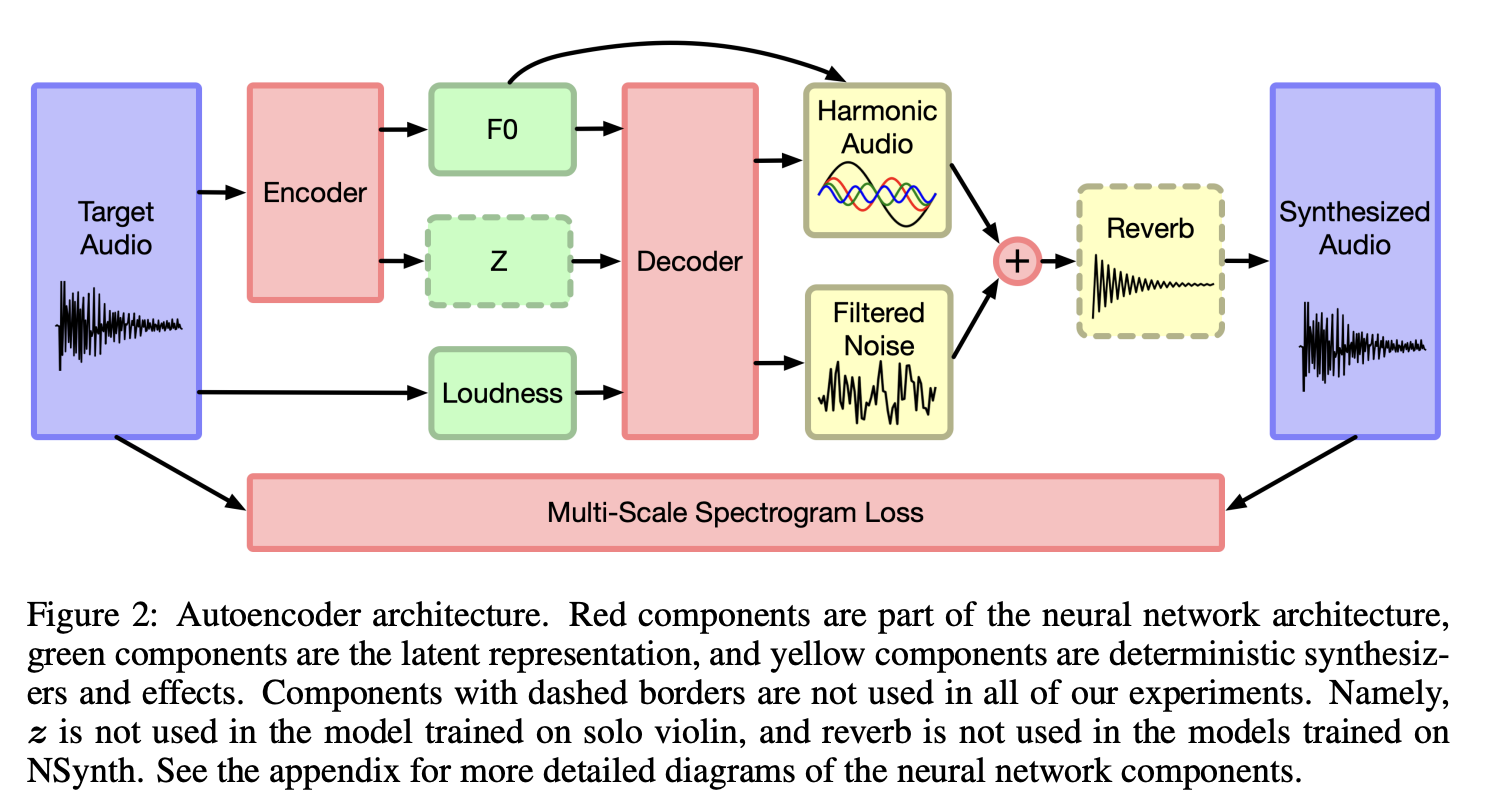
Figura originale: Architettura dell'autoencoder DDSP.
Encoder
L'encoder trasforma l'audio in ingresso in due curve di controllo: la frequenza fondamentale (f0, l'altezza del suono), stimata con un rilevatore di altezza CREPE preaddestrato, e la sonorità, calcolata direttamente dal segnale. Un encoder residuo opzionale, una GRU applicata agli MFCC, aggiunge un vettore latente per i dettagli timbrici che altezza e sonorità non catturano. Questi segnali a bassa dimensionalità descrivono l'esecuzione.
Decoder e moduli di sintesi
Un decoder ricorrente (GRU) trasforma i segnali di controllo in parametri per tre componenti DSP:
- Sintetizzatore additivo armonico: genera fino a 100 parziali sinusoidali a multipli della frequenza fondamentale per la parte del suono con un'altezza definita.
- Sintetizzatore di rumore filtrato: modella il rumore bianco con filtri FIR variabili nel tempo per riprodurre il soffio e il rumore dell'archetto.
- Riverbero differenziabile: aggiunge l'acustica di una stanza attraverso una risposta all'impulso appresa.
Ogni componente è differenziabile, quindi l'intero modello viene addestrato da un capo all'altro con una perdita spettrale multiscala. Prevede centinaia di parametri di sintesi per frame invece di generare l'audio campione per campione.
Addestrare modelli DDSP per la ricerca
Per un modello da suonare nel VST DDSP, usa il notebook di addestramento del VST DDSP descritto nella guida rapida sopra. Per modificare l'architettura o la funzione di perdita, parti dai tutorial Colab della libreria. Richiedono conoscenze di base di Python e trattano pre-elaborazione, configurazione e addestramento su una GPU di Colab.
Plugin DDSP da usare in tempo reale
I progetti ufficiali di Magenta sono archiviati, ma puoi ancora usare DDSP in una DAW con questi strumenti:
1. VST Magenta DDSP (archiviato)
Il VST DDSP ufficiale funziona ancora per sperimentare; consulta la guida rapida sopra per l'installazione. Include cinque modelli di strumenti e accetta ingressi MIDI e audio. Gli utenti segnalano un riverbero intenso in uscita, che sembra nascondere gli artefatti.
2. Piattaforma Neutone FX
Neutone FX offre un plugin gratuito che ospita modelli addestrati dalla comunità, comprese reti di trasferimento timbrico basate su DDSP. Offre ai produttori l'accesso a decine di modelli oltre agli strumenti originali di Magenta.

3. MAWF di yaboihanoi (consigliato)
Il plugin MAWF esegue la sintesi DDSP a 48 kHz nella tua DAW. Include diversi modelli di strumenti ed è l'implementazione DDSP più rifinita disponibile.

Tuttavia, il sito di download di MAWF non è disponibile dal novembre 2025. Aggiornerò questo articolo se troverò un'altra fonte per il plugin.
Quali sono i limiti di DDSP?
I limiti di DDSP derivano dalla sua architettura e dal suo approccio alla sintesi:
- Solo monofonico: i modelli DDSP non possono generare audio polifonico. Sono stati addestrati con registrazioni monofoniche e il sintetizzatore armonico presuppone una sola frequenza fondamentale a ogni passo temporale.
- Qualità audio: i modelli MAWF a 48 kHz suonano meglio, ma le implementazioni originali a 16 kHz presentano artefatti metallici e poco contenuto nelle alte frequenze. Un modello di super-risoluzione audio può rigenerare gli acuti mancanti nei vecchi rendering: vedi come installare ed eseguire AudioSR da GitHub, oppure come UniverSR ha ripristinato a 48 kHz gli effetti sonori a 22 kHz di RPG Maker.
- Parallelismo limitato su GPU: gli strati ricorrenti elaborano i frame uno dopo l'altro, quindi il modello non può parallelizzare l'elaborazione nel tempo su una GPU come i modelli convoluzionali.
Oltre DDSP: RAVE, DDSP-CNN-Tiny e AFTER
RAVE (2021)
RAVE usa CNN causali invece di RNN, offrendo addestramento più rapido e sintesi a 48 kHz, oltre a una migliore modellazione timbrica. È un autoencoder variazionale affinato con addestramento avversariale mediante un discriminatore e raggiunge una fedeltà maggiore con una quantità di dati simile.
DDSP-CNN-Tiny (2022)
DDSP-CNN-Tiny sostituisce le RNN di DDSP con CNN leggere, riducendo le dimensioni del modello e accelerando l'inferenza. La qualità audio resta comparabile e funziona in tempo reale su CPU. Piccole reti eseguite su CPU sono anche alla base dei plugin neurali gratuiti per amplificatori di chitarra come NAM e AIDA-X. Václav Volhejn lo ha sviluppato per la sua tesi all'ETH Zurich, e la sua tesi su DDSP in tempo reale è un'ottima lettura tecnica.
AFTER (2024)
Il modello AFTER esegue diffusione latente su un codec audio neurale per ottenere una sintesi di qualità da studio. Richiede più calcolo di DDSP, ma il suo trasferimento timbrico ha molti meno artefatti, quindi è più adatto alla produzione professionale.
Domande frequenti su DDSP
Magenta DDSP è ancora mantenuto?
In parte. La libreria ddsp non è archiviata e riceve ancora commit. Magenta ha archiviato MIDI DDSP nel febbraio 2024 e il VST DDSP nell'ottobre 2024, quindi il plugin non riceve aggiornamenti. I download del plugin e il notebook di addestramento funzionavano ancora quando questa guida è stata aggiornata nell'ottobre 2026.
Il VST DDSP funziona su Linux?
Non esiste una versione ufficiale per Linux. Dovresti compilarlo autonomamente dal codice sorgente.
DDSP può suonare accordi?
No. I modelli DDSP sono monofonici: seguono una sola altezza alla volta. Per il controllo MIDI polifonico, guarda AFTER.
DDSP o RAVE: quale dovrei addestrare?
Scegli DDSP per un singolo strumento con un'altezza definita quando hai solo circa 10 minuti di audio e una GPU gratuita di Colab. Scegli RAVE per qualsiasi tipo di suono, inclusi batteria, texture e voci. RAVE richiede alcune ore di audio e giorni di addestramento su GPU. Le domande frequenti confrontano quanto audio serve per addestrare DDSP, RAVE e AFTER e spiegano quale plugin riproduce ogni modello addestrato nella tua DAW.