DDSP: Magenta DDSP VST, Training und Funktionsweise
DDSP (differenzierbare digitale Signalverarbeitung, englisch Differentiable Digital Signal Processing) ist die Open-Source-Bibliothek von Google Magenta, mit der ein neuronales Netz klassische Klangerzeuger steuert: Oszillatoren, gefiltertes Rauschen und Hall. Magenta hat das DDSP-VST 2024 archiviert, doch das kostenlose Plugin lässt sich weiterhin herunterladen und unter Windows und macOS ausführen. Sie können auch Ihr eigenes Instrumentenmodell in einem kostenlosen Google-Colab-Notebook trainieren.
Dieser Leitfaden beginnt mit diesen beiden praktischen Schritten. Anschließend erklärt er die Funktionsweise und Grenzen von DDSP sowie die neueren Modelle, die es abgelöst haben.
DDSP heute verwenden: Schnellstart
DDSP-VST herunterladen und installieren
- Laden Sie das Plugin für macOS oder Windows herunter. Beide Links stammen aus dem offiziellen DDSP-VST-Repository.
- Entpacken Sie die Datei. Sie enthält zwei Plugins: DDSP Effect, das eingehendes Audio, etwa Ihre Stimme, in einen Instrumentenklang verwandelt, und DDSP Synth, das Sie per MIDI spielen.
- Kopieren Sie sie unter macOS nach
/Library/Audio/Plug-Ins/Components(AU) und/Library/Audio/Plug-Ins/VST3. Kopieren Sie die VST3-Dateien unter Windows nachC:\Program Files\Common Files\VST3. - Lassen Sie Ihre DAW erneut nach Plugins suchen.
Es gibt keine offizielle Linux-Version. Wenn Sie DDSP ohne Installation hören möchten, probieren Sie die Webdemo von Tone Transfer.
Ihr eigenes DDSP-Instrument trainieren
Magentas Trainingsnotebook für das DDSP-VST läuft in Google Colab, sodass Sie keine lokale GPU benötigen:
- Legen Sie mindestens 10 Minuten Audio im Format
.wavoder.mp3in einem Google-Drive-Ordner ab. Verwenden Sie monophones Audio, jeweils nur eine Note, aus derselben Aufnahmesitzung mit demselben Mikrofon und im selben Raum. - Öffnen Sie das Notebook, führen Sie die Installationszelle aus, die etwa 5 Minuten benötigt, und starten Sie anschließend die Trainingszelle. Wählen Sie dabei Ihren Ordner aus.
- Warten Sie. Das Training dauert etwa 2 bis 3 Stunden im kostenlosen Colab und weniger als eine Stunde mit Colab Pro+. Falls Colab die Verbindung trennt, führen Sie die Zelle mit demselben Ordner erneut aus, um das Training fortzusetzen.
- Entpacken Sie den heruntergeladenen Modellordner in den Modellordner des Plugins. Auf einem Mac ist das
~/Documents/Magenta/DDSP/Models; Sie können ihn auch direkt im Plugin öffnen.
Laut Notebook entstehen gute Ergebnisse meist nach 30.000 bis 50.000 Trainingsschritten. Bei zu wenigen Schritten klingt das Ergebnis ausdruckslos; zu viele können Aussetzer und starke Lautstärkesprünge verursachen.
Geschichte und Entwicklung: von Magenta zu heutigen Plugins
Magenta-Forschungslabor (2016-2024)
Google startete Magenta 2016 als Open-Source-Forschungsprojekt zu maschinellem Lernen für Musik und Kunst. Es veröffentlichte zahlreiche Werkzeuge zur Musikgenerierung, doch bis 2024 waren die meisten seiner Projekte archiviert.
Open NSynth Super (2017)
Vor DDSP stellte Magenta Open NSynth Super vor, ein Hardware-Instrument auf Basis von NSynth. Der NSynth-Datensatz enthält etwa 305.000 Samples einzelner Noten von 1.006 Instrumenten. Das Gerät wurde aus einem Raspberry Pi und einer eigens entworfenen Leiterplatte aufgebaut und ermöglichte fließende Übergänge zwischen Instrumentenklängen in Echtzeit.
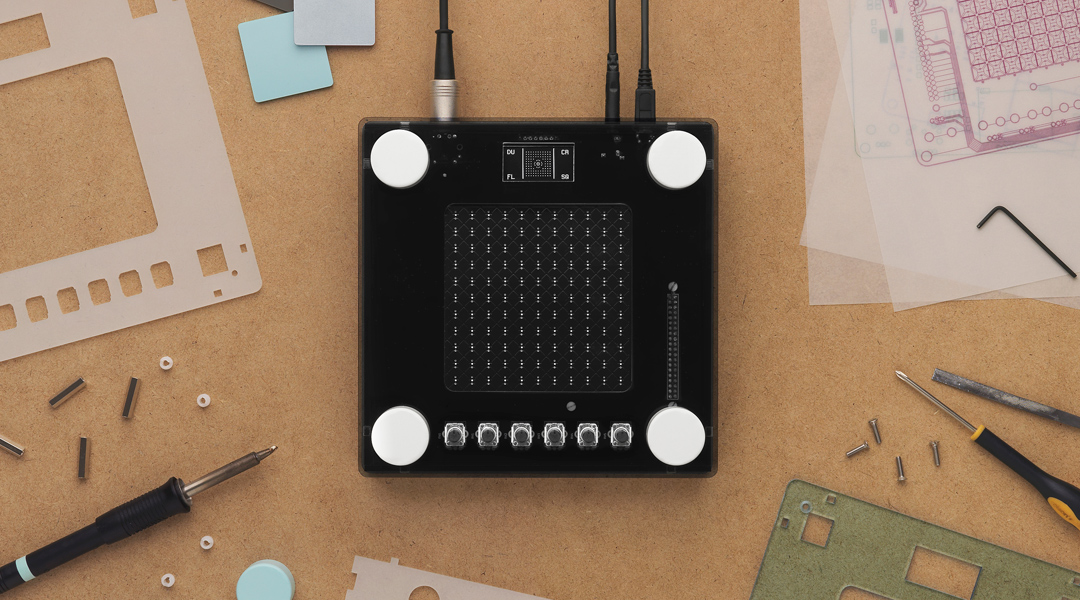
Das NSynth-Modell, ein Autoencoder im Stil von WaveNet, war wegen seines Rechenaufwands auf Audio mit 16 Bit/16 kHz beschränkt. Das Ergebnis klingt daher deutlich nach Lo-Fi. Toningenieur Joe Boston beschrieb es als „körnig“, fand aber kreative Einsatzmöglichkeiten mit externen Effekten. Das Hardware-Projekt wurde im August 2025 archiviert.
DDSP und Tone Transfer (2020)
2020 veröffentlichte Magenta die DDSP-Bibliothek und den zugehörigen ICLR-Fachartikel, der differenzierbare Versionen gängiger Signalverarbeitungsmodule vorstellte. Mit der Webdemo von Tone Transfer konnten Nutzer Aufnahmen, etwa Gesang, in Violine, Saxofon, Trompete oder Flöte verwandeln.
Die Modelle waren RNN-basierte Autoencoder, die mit etwa 10 Minuten monophonem Audio pro Instrument trainiert wurden. Die Demo funktionierte, doch die Ausgabe mit 16 kHz und die begrenzte Modellierung von Artikulationen schränkten ihre Möglichkeiten ein.
MIDI DDSP und das VST-Plugin (2022-2024)
Magenta erweiterte DDSP im Januar 2022 um MIDI DDSP. Es synthetisiert Instrumentenaudio direkt aus monophonen MIDI-Sequenzen. Um per MIDI aufgenommene Samples statt eines neuronalen Modells zu spielen, laden Sie ein SFZ-Instrument im kostenlosen sforzando-Player.
Im Juni 2022 veröffentlichte Magenta das DDSP-VST-Plugin für Klangfarbentransfer in Echtzeit in einer DAW. Beide Projekte wurden 2024 archiviert: MIDI DDSP im Februar und das VST im Oktober.

MAWF-Audioplugin (2023)
Hanoi Hantrakul (yaboihanoi), früher technischer Leiter von Tone Transfer und seit 2020 bei ByteDance, veröffentlichte MAWF im Jahr 2023. Das kostenlose VST/AU-Plugin ermöglicht neuronale Audiosynthese in Echtzeit mit 48 kHz und hebt damit die 16-kHz-Grenze früher DDSP-Implementierungen auf.

Wie funktioniert DDSP? Autoencoder treffen auf DSP
DDSP ist ein Autoencoder, dessen Decoder modulare DSP-Komponenten steuert, statt die Wellenform direkt zu erzeugen.
Architektur des DDSP-Autoencoders
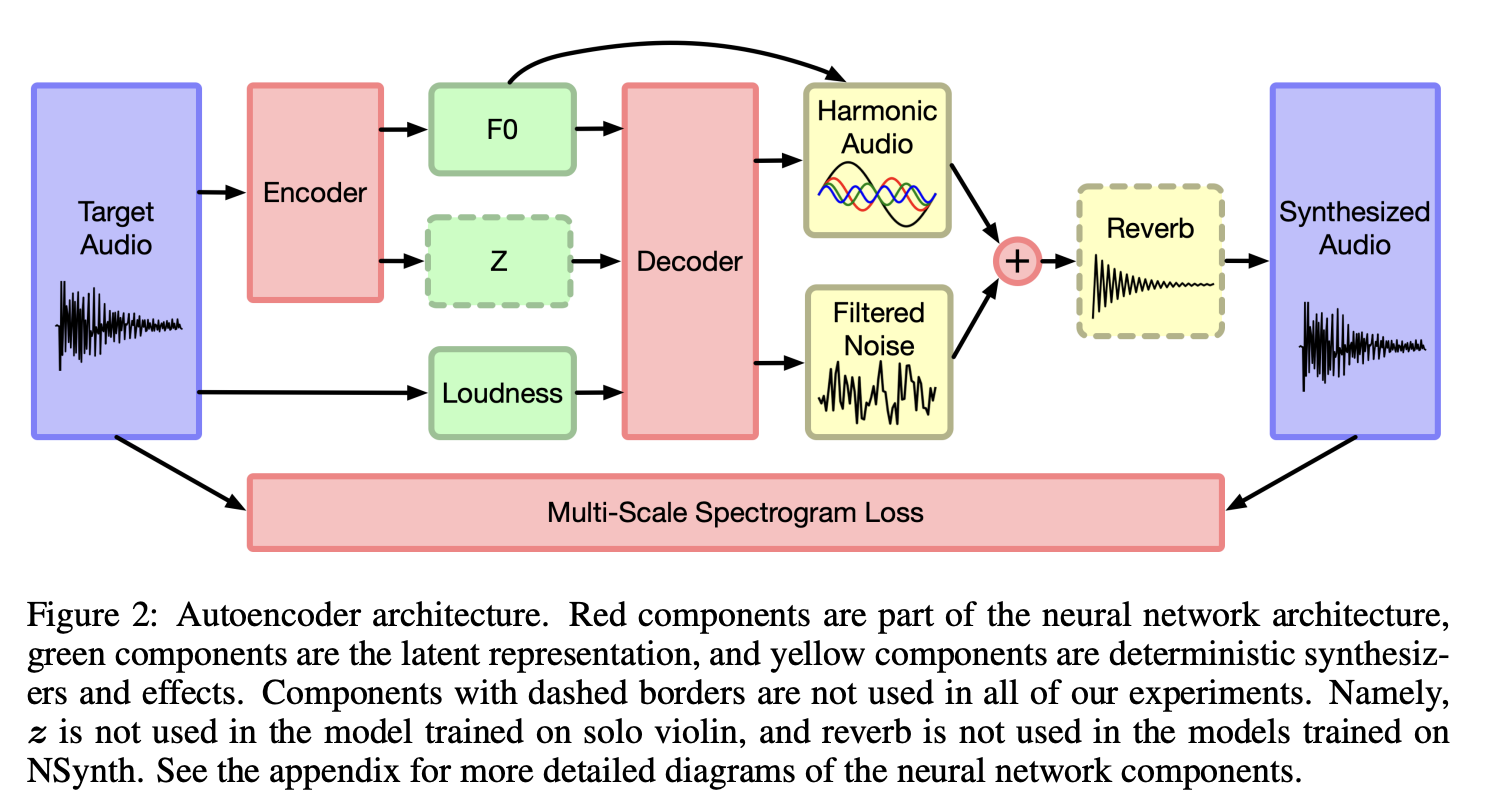
Originalabbildung: Architektur des DDSP-Autoencoders.
Encoder
Der Encoder wandelt das Eingangsaudio in zwei Steuerkurven um: die Grundfrequenz (f0, die Tonhöhe), geschätzt mit einem vortrainierten CREPE-Tonhöhendetektor, und die Lautheit, die direkt aus dem Signal berechnet wird. Ein optionaler Residual-Encoder, eine GRU über MFCCs, ergänzt einen latenten Vektor für Klangfarbendetails, die Tonhöhe und Lautheit nicht erfassen. Diese niedrigdimensionalen Signale beschreiben die Darbietung.
Decoder und Synthesemodule
Ein rekurrenter Decoder (GRU) bildet die Steuersignale auf Parameter für drei DSP-Komponenten ab:
- Harmonischer additiver Synthesizer: erzeugt bis zu 100 sinusförmige Teiltöne bei Vielfachen der Grundfrequenz für den Teil des Klangs mit definierter Tonhöhe.
- Synthesizer für gefiltertes Rauschen: formt weißes Rauschen mit zeitlich veränderlichen FIR-Filtern, um Atem- und Bogengeräusche zu modellieren.
- Differenzierbarer Hall: ergänzt die Raumakustik über eine erlernte Impulsantwort.
Jede Komponente ist differenzierbar. Deshalb lässt sich das gesamte Modell Ende zu Ende mit einer spektralen Verlustfunktion auf mehreren Skalen trainieren. Es sagt pro Frame Hunderte Syntheseparameter voraus, statt Audio Sample für Sample zu erzeugen.
DDSP-Modelle für die Forschung trainieren
Für ein Modell, das Sie im DDSP-VST spielen möchten, verwenden Sie das oben im Schnellstart beschriebene Trainingsnotebook für das DDSP-VST. Um die Architektur oder die Verlustfunktion zu ändern, beginnen Sie mit den Colab-Tutorials der Bibliothek. Sie setzen grundlegende Python-Kenntnisse voraus und behandeln Vorverarbeitung, Konfiguration und Training auf einer Colab-GPU.
DDSP-Plugins für den Echtzeiteinsatz
Magentas offizielle Projekte sind archiviert, aber mit diesen Werkzeugen können Sie DDSP weiterhin in einer DAW nutzen:
1. Magenta DDSP VST (archiviert)
Das offizielle DDSP-VST funktioniert weiterhin für Experimente; die Installationsschritte finden Sie oben im Schnellstart. Es enthält fünf Instrumentenmodelle und akzeptiert MIDI- und Audioeingänge. Nutzer berichten von starkem Hall in der Ausgabe, der offenbar Artefakte verdeckt.
2. Neutone-FX-Plattform
Neutone FX bietet ein kostenloses Plugin, das von der Community trainierte Modelle lädt, darunter DDSP-basierte Netzwerke für Klangfarbentransfer. Produzenten erhalten damit Zugang zu Dutzenden Modellen über die ursprünglichen Magenta-Instrumente hinaus.

3. MAWF von yaboihanoi (empfohlen)
Das MAWF-Plugin führt DDSP-Synthese mit 48 kHz in Ihrer DAW aus. Es enthält mehrere Instrumentenmodelle und ist die ausgereifteste verfügbare DDSP-Implementierung.

Die Downloadseite von MAWF ist allerdings seit November 2025 nicht erreichbar. Ich werde diesen Artikel aktualisieren, falls ich eine andere Quelle für das Plugin finde.
Welche Grenzen hat DDSP?
Die Grenzen von DDSP ergeben sich aus seiner Architektur und dem Syntheseverfahren:
- Nur monophon: DDSP-Modelle können kein polyphones Audio erzeugen. Sie wurden mit monophonen Aufnahmen trainiert, und der harmonische Synthesizer setzt zu jedem Zeitschritt eine einzige Grundfrequenz voraus.
- Audioqualität: Die 48-kHz-Modelle von MAWF klingen besser, doch die ursprünglichen 16-kHz-Implementierungen haben metallische Artefakte und wenig Inhalt in den hohen Frequenzen. Ein Modell zur Audio-Superauflösung kann die fehlenden Höhen alter Renderings regenerieren: Lesen Sie, wie Sie AudioSR von GitHub installieren und ausführen, oder wie UniverSR die 22-kHz-Soundeffekte von RPG Maker auf 48 kHz restaurierte.
- Begrenzte GPU-Parallelisierung: Die rekurrenten Schichten verarbeiten Frames nacheinander. Das Modell kann daher die Verarbeitung über die Zeit auf einer GPU nicht so parallelisieren wie Faltungsmodelle.
Nach DDSP: RAVE, DDSP-CNN-Tiny und AFTER
RAVE (2021)
RAVE verwendet kausale CNNs statt RNNs. Das ermöglicht schnelleres Training und Synthese mit 48 kHz sowie eine bessere Modellierung der Klangfarbe. Es handelt sich um einen variationalen Autoencoder, der mit adversarialem Training durch einen Diskriminator verfeinert wird und aus einer ähnlichen Datenmenge höhere Wiedergabetreue erzielt.
DDSP-CNN-Tiny (2022)
DDSP-CNN-Tiny ersetzt die RNNs von DDSP durch leichte CNNs. Das verkleinert das Modell und beschleunigt die Inferenz. Die Audioqualität bleibt vergleichbar, und das Modell läuft in Echtzeit auf einer CPU. Kleine Netze, die auf einer CPU laufen, bilden auch die Grundlage für kostenlose neuronale Gitarrenamp-Plugins wie NAM und AIDA-X. Václav Volhejn entwickelte es für seine Abschlussarbeit an der ETH Zurich; seine Arbeit über Echtzeit-DDSP ist eine hervorragende technische Lektüre.
AFTER (2024)
Das AFTER-Modell nutzt latente Diffusion auf einem neuronalen Audiocodec, um Synthese in Studioqualität zu erreichen. Es benötigt mehr Rechenleistung als DDSP, doch sein Klangfarbentransfer hat erheblich weniger Artefakte und eignet sich deshalb besser für professionelle Produktionen.
DDSP-FAQ
Wird Magenta DDSP noch gepflegt?
Teilweise. Die ddsp-Bibliothek ist nicht archiviert und erhält weiterhin Commits. Magenta archivierte MIDI DDSP im Februar 2024 und das DDSP-VST im Oktober 2024, sodass das Plugin keine Updates mehr erhält. Die Plugin-Downloads und das Trainingsnotebook funktionierten noch, als dieser Leitfaden im Oktober 2026 aktualisiert wurde.
Funktioniert das DDSP-VST unter Linux?
Es gibt keine offizielle Linux-Version. Sie müssten es selbst aus dem Quellcode kompilieren.
Kann DDSP Akkorde spielen?
Nein. DDSP-Modelle sind monophon: Sie folgen jeweils nur einer Tonhöhe. Für polyphone MIDI-Steuerung sehen Sie sich AFTER an.
DDSP oder RAVE: Welches Modell sollte ich trainieren?
Wählen Sie DDSP für ein einzelnes Instrument mit definierter Tonhöhe, wenn Sie nur etwa 10 Minuten Audio und eine kostenlose Colab-GPU haben. Wählen Sie RAVE für beliebige Klänge, einschließlich Schlagzeug, Texturen und Stimmen. RAVE benötigt einige Stunden Audio und mehrere Tage GPU-Training. Die FAQ vergleichen, wie viel Trainingsaudio DDSP, RAVE und AFTER benötigen, und erklären, welches Plugin die trainierten Modelle in Ihrer DAW abspielt.