DDSP-gids: Magenta DDSP VST, training en hoe het werkt
DDSP (differentieerbare digitale signaalverwerking) is de opensourcebibliotheek van Google Magenta waarmee een neuraal netwerk klassieke geluidsgeneratoren aanstuurt: oscillatoren, gefilterde ruis en galm. Magenta archiveerde de DDSP VST in 2024, maar je kunt de gratis plug-in nog steeds downloaden en uitvoeren op Windows en macOS. Je kunt ook je eigen instrumentmodel trainen in een gratis Google Colab-notebook.
Deze gids begint met die twee praktische stappen. Daarna wordt uitgelegd hoe DDSP werkt, waar het tekortschiet en welke nieuwere modellen het hebben vervangen.
DDSP vandaag gebruiken: snel aan de slag
De DDSP VST downloaden en installeren
- Download de plug-in voor macOS of Windows. Beide links komen uit de officiële DDSP VST-repository.
- Pak het bestand uit. Het bevat twee plug-ins: DDSP Effect, die inkomende audio (zoals je stem) in een instrument omzet, en DDSP Synth, die je met MIDI bespeelt.
- Kopieer ze op macOS naar
/Library/Audio/Plug-Ins/Components(AU) en/Library/Audio/Plug-Ins/VST3. Kopieer op Windows de VST3-bestanden naarC:\Program Files\Common Files\VST3. - Scan je plug-ins opnieuw in je DAW.
Er is geen officiële Linux-versie. Wil je DDSP horen zonder iets te installeren, probeer dan de Tone Transfer-webdemo.
Je eigen DDSP-instrument trainen
Magenta's DDSP VST-trainingsnotebook draait in Google Colab, dus je hebt geen lokale GPU nodig:
- Zet minstens 10 minuten
.wav- of.mp3-audio in een Google Drive-map. Gebruik monofone audio (één noot tegelijk) uit één opnamesessie, met dezelfde microfoon en in dezelfde ruimte. - Open het notebook, voer de installatiecel uit (ongeveer 5 minuten), voer daarna de trainingscel uit en selecteer je map.
- Wacht. Training duurt ongeveer 2 tot 3 uur op gratis Colab en minder dan een uur op Colab Pro+. Verbreekt Colab de verbinding, voer dan de cel opnieuw uit met dezelfde map en de training wordt hervat.
- Pak de gedownloade modelmap uit in de modelmap van de plug-in. Op een Mac is dat
~/Documents/Magenta/DDSP/Models; je kunt die ook vanuit de plug-in openen.
Het notebook vermeldt dat goede resultaten meestal na 30.000 tot 50.000 trainingsstappen ontstaan. Te weinig stappen klinken vlak; te veel kunnen haperingen en grote volumesprongen veroorzaken.
Geschiedenis en ontwikkeling: van Magenta naar moderne plug-ins
Magenta-onderzoekslab (2016-2024)
Google begon Magenta in 2016 als opensourceonderzoeksproject naar machinelearning voor muziek en kunst. Het bracht veel tools voor muziekgeneratie uit, maar de meeste projecten waren in 2024 al gearchiveerd.
Open NSynth Super (2017)
Vóór DDSP introduceerde Magenta Open NSynth Super, een hardware-instrument op basis van NSynth. De NSynth-dataset bevat ongeveer 305.000 samples van afzonderlijke noten van 1.006 instrumenten. Het apparaat, gebouwd met een Raspberry Pi en een speciaal ontworpen printplaat, liet spelers in realtime vloeiend tussen instrumentklanken overgaan.
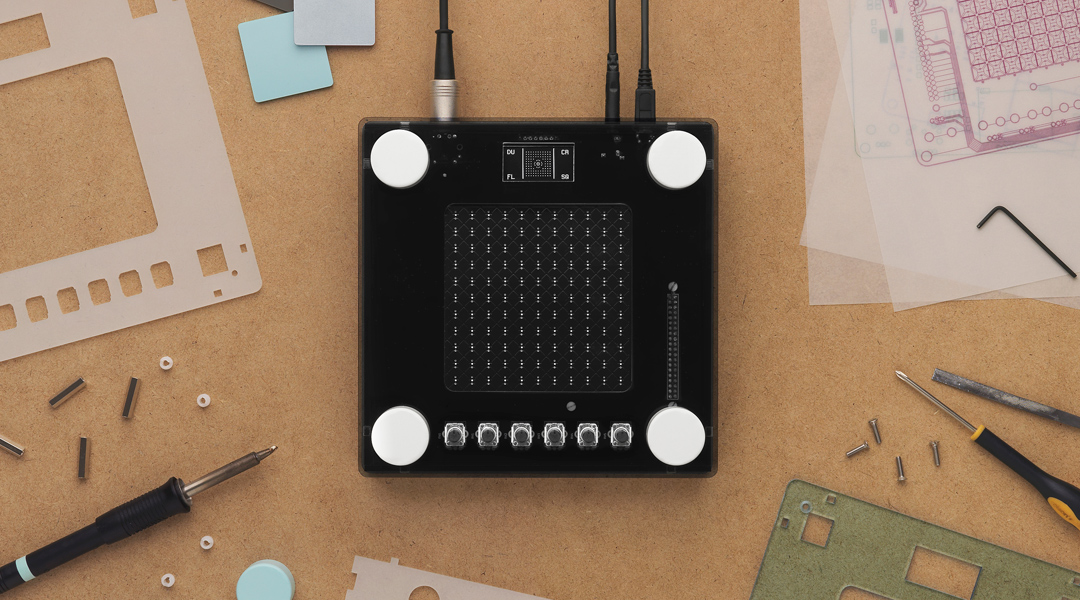
Het NSynth-model, een autoencoder in de stijl van WaveNet, was door de rekenkosten beperkt tot 16-bit/16 kHz-audio, waardoor de uitvoer duidelijk lo-fi klinkt. Audiotechnicus Joe Boston omschreef het als ‘korrelig’, maar vond creatieve toepassingen door het door externe effecten te sturen. Het hardwareproject werd in augustus 2025 gearchiveerd.
DDSP en Tone Transfer (2020)
In 2020 publiceerde Magenta de DDSP-bibliotheek en het ICLR-paper, dat differentieerbare versies van gangbare signaalverwerkingsmodules introduceerde. Met de Tone Transfer-webdemo konden gebruikers opnamen zoals zang omzetten in viool, saxofoon, trompet of fluit.
De modellen waren autoencoders op basis van RNN's, getraind op ongeveer 10 minuten monofone audio per instrument. De demo werkte, maar de uitvoer op 16 kHz en de beperkte modellering van articulatie remden de mogelijkheden.
MIDI DDSP en VST-plug-in (2022-2024)
Magenta breidde DDSP in januari 2022 uit met MIDI DDSP. Het synthetiseert instrumentaudio rechtstreeks uit monofone MIDI-sequenties. Wil je MIDI via opgenomen samples bespelen in plaats van via een neuraal model, laad dan een SFZ-instrument in de gratis sforzando-speler.
In juni 2022 bracht Magenta de DDSP VST-plug-in uit voor realtime klankkleuroverdracht in een DAW. Beide projecten werden in 2024 gearchiveerd: MIDI DDSP in februari en de VST in oktober.

MAWF-audioplug-in (2023)
Hanoi Hantrakul (yaboihanoi), voormalig technisch leider van Tone Transfer en sinds 2020 werkzaam bij ByteDance, lanceerde MAWF in 2023. De gratis VST/AU-plug-in voert realtime neurale audiosynthese op 48 kHz uit en neemt daarmee de 16 kHz-beperking van eerdere DDSP-implementaties weg.

Hoe werkt DDSP? Autoencoders en DSP gecombineerd
DDSP is een autoencoder waarvan de decoder modulaire DSP-componenten aanstuurt in plaats van de golfvorm rechtstreeks te genereren.
Architectuur van de DDSP-autoencoder
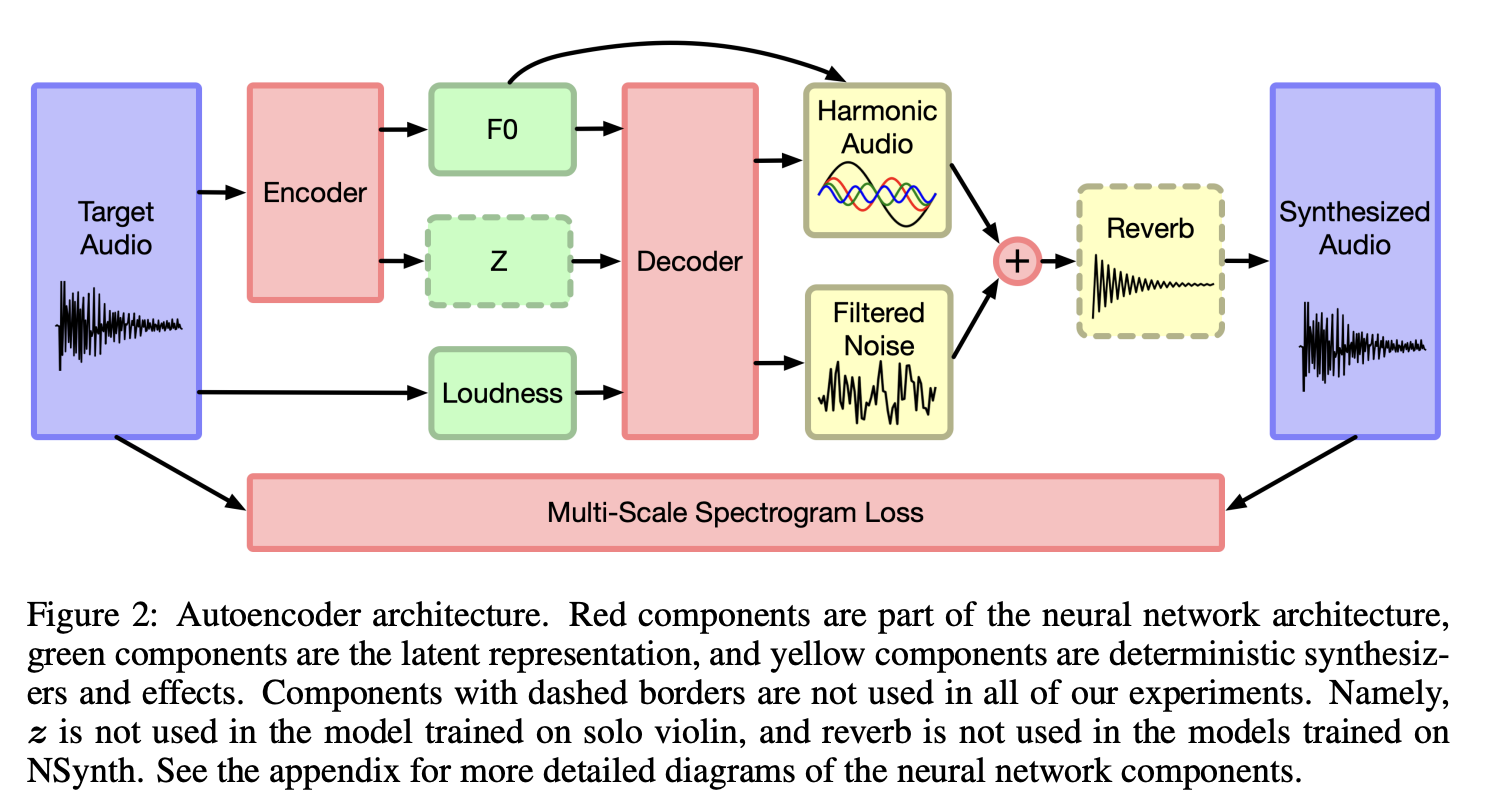
Oorspronkelijke figuur: Architectuur van de DDSP-autoencoder.
Encoder
De encoder zet invoeraudio om in twee regelcurves: grondfrequentie (f0, de toonhoogte), geschat met een vooraf getrainde CREPE-toonhoogtetracker, en luidheid, rechtstreeks berekend uit het signaal. Een optionele residuele encoder (een GRU die MFCC's verwerkt) voegt een latente vector toe voor klankkleurdetails die toonhoogte en luidheid niet vastleggen. Deze laagdimensionale signalen beschrijven de uitvoering.
Decoder en synthesemodules
Een recurrente decoder (GRU) zet de regelsignalen om in parameters voor drie DSP-componenten:
- Harmonische additieve synthesizer: genereert tot 100 sinusvormige deeltonen op veelvouden van de grondfrequentie voor het tonale deel van het geluid.
- Synthesizer voor gefilterde ruis: vormt witte ruis met tijdsafhankelijke FIR-filters om adem- en strijkstokruis te modelleren.
- Differentieerbare galm: voegt ruimteakoestiek toe via een geleerde impulsrespons.
Elke component is differentieerbaar, zodat het hele model van begin tot eind wordt getraind met een spectrale verliesfunctie op meerdere schalen. Het voorspelt honderden syntheseparameters per frame in plaats van audio sample voor sample te genereren.
DDSP-modellen trainen voor onderzoek
Gebruik voor een model dat je in de DDSP VST gaat bespelen het DDSP VST-trainingsnotebook uit de snelle start hierboven. Wil je de architectuur of verliesfunctie wijzigen, begin dan met de Colab-tutorials van de bibliotheek. Ze vragen om basiskennis van Python en behandelen voorbewerking, configuratie en training op een Colab-GPU.
DDSP-plug-ins voor realtime gebruik
De officiële projecten van Magenta zijn gearchiveerd, maar je kunt DDSP nog steeds in een DAW draaien met deze tools:
1. Magenta DDSP VST (gearchiveerd)
De officiële DDSP VST werkt nog steeds voor experimenten (zie de snelle start hierboven voor de installatie). Hij bevat vijf instrumentmodellen en accepteert zowel MIDI- als audio-invoer. Gebruikers melden veel galm op de uitvoer, die artefacten lijkt te maskeren.
2. Neutone FX-platform
Neutone FX biedt een gratis plug-in die modellen uitvoert die door de community zijn getraind, waaronder netwerken voor klankkleuroverdracht op basis van DDSP. Producers krijgen hiermee toegang tot tientallen modellen naast de oorspronkelijke Magenta-instrumenten.

3. MAWF van yaboihanoi (aanbevolen)
De MAWF-plug-in voert DDSP-synthese op 48 kHz uit in je DAW. Hij bevat meerdere instrumentmodellen en is de meest verfijnde beschikbare DDSP-implementatie.

De MAWF-downloadsite is echter sinds november 2025 niet bereikbaar. Ik werk dit artikel bij als ik een andere bron voor de plug-in vind.
Wat zijn de beperkingen van DDSP?
De beperkingen van DDSP komen voort uit de architectuur en syntheseaanpak:
- Alleen monofoon: DDSP-modellen kunnen geen polyfone audio genereren. Ze zijn getraind op monofone opnamen en de harmonische synthesizer gaat op elke tijdstap uit van één grondfrequentie.
- Audiokwaliteit: de 48 kHz-modellen van MAWF klinken beter, maar de oorspronkelijke 16 kHz-implementaties hebben metaalachtige artefacten en weinig hoge frequenties. Een model voor audiosuperresolutie kan de ontbrekende hoge frequenties van oude renders reconstrueren: bekijk hoe je AudioSR vanaf GitHub installeert en uitvoert, of hoe UniverSR RPG Maker-geluidseffecten van 22 kHz naar 48 kHz herstelde.
- Beperkte GPU-parallellisatie: de recurrente lagen verwerken frames achter elkaar, waardoor het model de verwerking in de tijd op een GPU niet kan parallelliseren zoals convolutionele modellen dat kunnen.
Na DDSP: RAVE, DDSP-CNN-Tiny en AFTER
RAVE (2021)
RAVE gebruikt causale CNN's in plaats van RNN's, wat snellere training en synthese op 48 kHz en betere klankkleurmodellering oplevert. Het is een variationele autoencoder die met adversariële training (een discriminator) is verfijnd en met een vergelijkbare hoeveelheid data een hogere geluidsgetrouwheid bereikt.
DDSP-CNN-Tiny (2022)
DDSP-CNN-Tiny vervangt de RNN's van DDSP door lichte CNN's, waardoor het model kleiner wordt en inferentie sneller gaat. De audiokwaliteit blijft vergelijkbaar en het werkt in realtime op een CPU. Kleine netwerken die op een CPU draaien, zijn ook de basis van gratis neurale gitaarversterkerplug-ins zoals NAM en AIDA-X. Václav Volhejn ontwikkelde het voor zijn scriptie aan ETH Zurich, en zijn scriptie over realtime DDSP is interessante technische lectuur.
AFTER (2024)
Het AFTER-model voert latente diffusie boven op een neurale audiocodec uit om synthese van studiokwaliteit te bereiken. Het vraagt meer rekenkracht dan DDSP, maar de klankkleuroverdracht heeft veel minder artefacten en is daardoor geschikter voor professionele productie.
Veelgestelde vragen over DDSP
Wordt Magenta DDSP nog onderhouden?
Gedeeltelijk. De ddsp-bibliotheek is niet gearchiveerd en krijgt nog commits. Magenta archiveerde MIDI DDSP in februari 2024 en de DDSP VST in oktober 2024, dus de plug-in krijgt geen updates. De plug-indownloads en het trainingsnotebook werkten nog toen deze gids in oktober 2026 werd bijgewerkt.
Werkt de DDSP VST op Linux?
Er is geen officiële Linux-versie. Je zou hem zelf uit de broncode moeten bouwen.
Kan DDSP akkoorden spelen?
Nee. DDSP-modellen zijn monofoon: ze volgen één toonhoogte tegelijk. Bekijk voor polyfone MIDI-aansturing AFTER.
DDSP of RAVE: welk model moet ik trainen?
Kies DDSP voor één instrument met een duidelijke toonhoogte als je maar ongeveer 10 minuten audio en een gratis Colab-GPU hebt. Kies RAVE voor elk soort geluid, inclusief drums, texturen en stemmen. RAVE vraagt een paar uur audio en dagen GPU-training. De FAQ vergelijkt hoeveel trainingsaudio DDSP, RAVE en AFTER nodig hebben en welke plug-in elk getraind model in je DAW afspeelt.