RAVE van IRCAM: VST, vooraf getrainde modellen en training
Het RAVE-model van IRCAM is een neuraal audiomodel dat in realtime elk geluid omzet naar het timbre waarop het is getraind. Je kunt vooraf getrainde RAVE-modellen in je DAW gebruiken met Neutone FX of de RAVE VST, ze in Max/MSP of Pure Data laden met nn~, of eigen modellen trainen met het Python-pakket acids-rave.
RAVE gebruiken: snel aan de slag
| Doel | Hulpmiddel | Wat je nodig hebt |
|---|---|---|
| RAVE-modellen in een DAW gebruiken | Neutone FX (gratis VST/AU) | Elke DAW. Vooraf getrainde modellen download je in de plugin. |
| RAVE-modellen in een DAW gebruiken | RAVE VST (bèta) | Een download van IRCAM Forum. De bronrepository is in juni 2023 gearchiveerd en de Windows-versie is alleen een zelfstandige toepassing. |
| RAVE in Max/MSP of Pure Data gebruiken | nn~-external | Max of Pd en een .ts-modelbestand |
| Vooraf getrainde modellen downloaden | Officiële lijst met RAVE-modellen | Streaming .ts-exports voor nn~ |
| Je eigen model trainen | acids-rave met Python | Een NVIDIA-GPU met 5 tot 32 GB geheugen, een paar uur audio en ongeveer 3 dagen |
Om nn~ te installeren, download je de nieuwste release en pak je die uit in Documents/Max [your version]/Packages/ voor Max, of in Documents/Pd/externals/ voor Pure Data. Zet je .ts-modellen in de map nn_tilde/models.

Wat is IRCAM RAVE voor audiosynthese in realtime?
RAVE staat voor Realtime Audio Variational autoEncoder, een variationele audio-autoencoder voor realtimegebruik. Het model werd eind 2021 uitgebracht door onderzoekers van IRCAM in Parijs. Het leert geluiden naar een compacte representatie te coderen en die vervolgens weer naar audio te decoderen. Vergelijk het met een computer leren schetsen wat hij hoort en die schets vervolgens laten uitwerken tot een overtuigende imitatie van het oorspronkelijke geluid.
Dat doet het snel genoeg om in realtime binnen je DAW of opstelling voor liveoptredens te werken.
Wie maakte RAVE en wanneer?
RAVE werd ontwikkeld door Antoine Caillon, die nu bij Google DeepMind werkt, en Philippe Esling van het ACIDS-team van IRCAM in Parijs.
Het team had eerder Googles DDSP-model (Differentiable Digital Signal Processing, differentieerbare digitale signaalverwerking) onderzocht en in maart 2021 gedemonstreerd, maar wilde een flexibeler model dat elk type geluid aankon, niet alleen muziekinstrumenten.
Het doel was een model dat op gewone hardware werkt en audio van studiokwaliteit levert. Ze presenteerden het in hun publicatie uit 2021, ‘RAVE: een variationele autoencoder voor snelle neurale audiosynthese van hoge kwaliteit’.
RAVE-architectuur: hoe deze variationele autoencoder werkt
RAVE is een autoencoder: een neuraal netwerk dat leert gegevens te comprimeren naar een compacte ‘latente ruimte’ en ze vervolgens weer te decomprimeren.
RAVE: training in twee fasen
Fase 1: een representatie leren
Fase 2: adversarieel verfijnen
Trainingsdiagram gebaseerd op de oorspronkelijke RAVE-publicatie. Fase 1 traint de encoder en decoder met een spectrale verliesfunctie over meerdere banden. Fase 2 bevriest de encoder, blokkeert gradiënten door de latente code en traint de decoder en discriminator. PQMF-analyse en -synthese blijven vast.
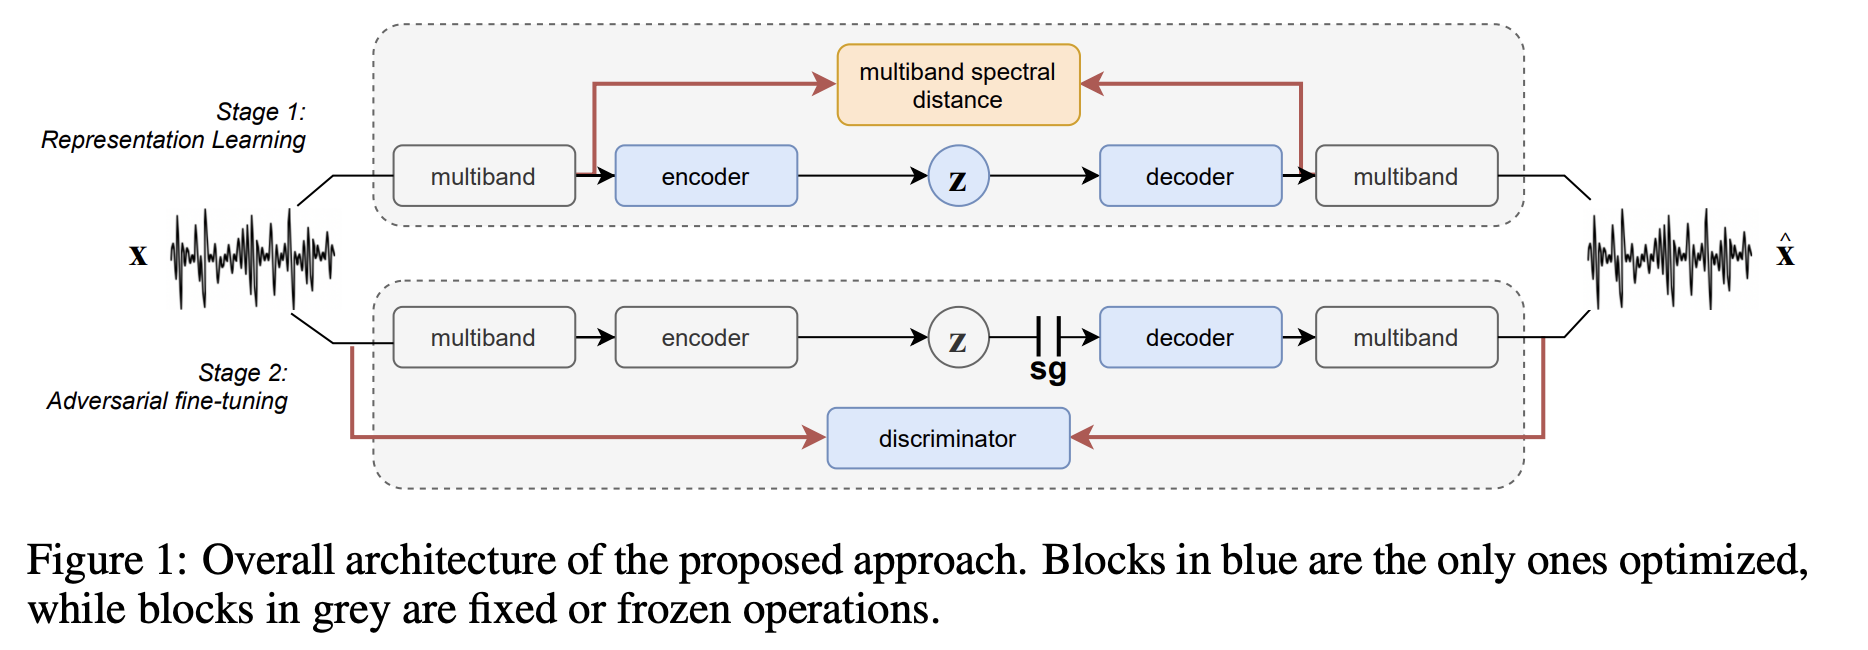
Oorspronkelijke figuur: RAVE: training in twee fasen.
Hoe de training van RAVE in twee fasen werkt
Vergelijk het met een muzikant opleiden in twee fasen:
-
Fase 1: leren luisteren (een representatie leren)
- De encoder leert audio samen te persen tot een compacte reeks getallen, de latente ruimte
- De decoder leert audio uit die getallen te reconstrueren
- De training gebruikt een spectrale verliesfunctie die de frequentie-inhoud van de oorspronkelijke en gereconstrueerde audio vergelijkt
-
Fase 2: leren improviseren (adversarieel verfijnen)
- De encoder wordt bevroren; hij weet al hoe hij moet luisteren
- Er wordt een ‘discriminator’-netwerk toegevoegd: een criticus die beoordeelt of de gereconstrueerde audio echt klinkt
- De decoder leert met die feedback overtuigendere audio te maken
Belangrijkste technische onderdelen
- PQMF-filters: RAVE splitst audio vóór verwerking in meerdere frequentiesubbanden, wat de verwerking efficiënter maakt
- Causale en niet-causale modi: de causale modus ruilt wat kwaliteit in voor minder vertraging bij livegebruik
- Meerdere configuraties: van het lichte "raspberry", dat op een Raspberry Pi werkt, tot het hoogwaardige "v3"
Zie voor implementatiedetails de officiële RAVE-repository op GitHub, met configuratiebestanden en modeldefinities.

RAVE-modellen trainen op je eigen audio
Wil je een model dat je stem in een saxofoon verandert? Een RAVE-model trainen vereist kennis van Python en een GPU. De officiële RAVE-repository beschrijft het hele proces.
Vereisten voor het voorbereiden van je dataset
Om een RAVE-model te trainen heb je nodig:
- 2 tot 3 uur schone audio; meer is beter
- Opnamen van studiokwaliteit, want RAVE leert alles, ook ruis en galm
- Gevarieerde geluiden als je veelzijdigheid wilt
Om een dataset uit volledige mixes te maken, isoleer je eerst het instrument met AI-stemscheiding van hoge kwaliteit. Scheidingsartefacten komen ook in het model terecht, dus gebruik de schoonste stems die je kunt krijgen. De gids voor stemscheiding laat zien hoe dat in Neural Analog werkt.
RAVE installeren en je dataset voorbereiden
Installeer eerst PyTorch en TorchAudio voor je GPU en daarna RAVE. Je hebt ook FFmpeg nodig; installeer dat in een conda-omgeving met conda:
pip install acids-rave
conda install ffmpeg
De voorbewerking zet je audiobestanden om naar het datasetformaat van RAVE:
rave preprocess --input_path /audio/folder --output_path /dataset/path --channels 1Gebruik --channels 1 voor mono of --channels 2 voor stereo. Voeg --lazy toe om rechtstreeks op gecomprimeerde bestanden zoals MP3 te trainen, maar houd tijdens de training rekening met een veel hogere CPU-belasting. Zie voor alle parameters de documentatie over RAVE-datasets voorbereiden.
Trainingsproces en configuraties van RAVE
Start de training met een configuratienaam:
rave train --config v2 --db_path /dataset/path --out_path /model/out --name my_model --channels 1Kies de configuratie die bij je GPU past. De minimale hoeveelheid GPU-geheugen komt uit de officiële README:
| Configuratie | Min. GPU-geheugen | Gebruik |
|---|---|---|
raspberry | 5 GB | Licht model voor realtimegebruik op een Raspberry Pi 4 |
onnx | 6 GB | Ruisloze v1 voor ONNX-export |
v1 | 8 GB | Het oorspronkelijke continue model |
v2_small | 8 GB | Timbreoverdracht bij stationaire geluiden |
v2 | 16 GB | Het verbeterde continue model en een goede standaardkeuze |
discrete | 18 GB | Een discreet model zoals SoundStream of EnCodec |
v3 | 32 GB | Hoogste kwaliteit, met stijloverdracht (AdaIN) |
Je kunt een configuratie combineren met opties zoals causal (minder vertraging) of noise. Een door de community gemaakt Colab-notebook voor RAVEv2, waar de README naar verwijst, traint op Googles GPU's als je er zelf geen hebt.
Wat je tijdens de training kunt verwachten:
- Fase 1 (~1 miljoen stappen): de audiokwaliteit is eerst ruw en verbetert geleidelijk
- Fase 2 (adversariële training): de kwaliteit verbetert sterk
- Totale tijd: ongeveer 3 dagen op een RTX 3080-GPU
Door de community gemaakte RAVE-trainingsnotebooks leggen het proces stap voor stap uit.
RAVE-modellen exporteren voor realtimegebruik
De export is belangrijk voor realtimegebruik. Gebruik de vlag --streaming om gecachete convoluties te activeren; die voorkomen klikartefacten:
rave export --run /path/to/your/run --streamingHet resultaat is een TorchScript-bestand met de extensie .ts dat nn~ kan laden. Zie voor exportparameters en het oplossen van problemen de RAVE-exportdocumentatie.
RAVE-modellen uitvoeren en in realtime gebruiken
Wil je geen 3 dagen op de training wachten? Je kunt vooraf getrainde RAVE-modellen in verschillende hulpmiddelen proberen. Die laden ook modellen die je zelf traint. De FAQ over een getraind model in je DAW gebruiken vermeldt de plugin voor elk modeltype.
Neutone FX: gratis VST/AU-plugin voor RAVE-modellen
Neutone FX is een gratis VST/AU-plugin die RAVE-modellen uitvoert. Het is de oorspronkelijke Neutone-plugin uit 2022, die nu als open platform wordt onderhouden. Installeer hem om een collectie vooraf getrainde modellen rechtstreeks in je DAW te laden, zoals Ableton, Logic, Reaper en andere.

RAVE VST van IRCAM: bèta, gearchiveerd
IRCAM bracht ook een eigen RAVE VST uit, met VST-, AU- en zelfstandige versies. Er zijn twee modi: reconstruction verwerkt de audio uit je DAW en prior genereert zelfstandig geluid door de latente ruimte te doorlopen. Model Explorer downloadt vooraf getrainde modellen. Je kunt ook je eigen modellen importeren als je ze met --stereo true exporteert.
De rave_vst-repository is in juni 2023 gearchiveerd, dus verwacht geen reparaties. Voor Windows is er alleen een experimentele zelfstandige versie en M1 Mac-gebruikers moeten hem zelf bouwen. De ontwikkelaars raden voor realtimegebruik nn~ aan.
Max/MSP en Pure Data integreren met nn~
Voor liveoptredens laadt de nn~-external RAVE-modellen rechtstreeks in Max/MSP en Pure Data. Hij maakt directe manipulatie van de latente ruimte en adaptieve instancenormalisatie (Adaptive Instance Normalization) voor stijloverdracht mogelijk. Hij werkt ook op ingebedde platforms zoals de Raspberry Pi voor draagbare installaties. Op dezelfde borden werken neurale gitaarversterkerplugins zoals ToobAmp en Stompbox. Is je bord een NVIDIA Jetson Nano, houd er dan rekening mee dat die geen analoge audio-uitgang heeft: voeg eerst een I2S-geluidskaart zoals de Raspiaudio Audio+ toe.
Prestatiebeperkingen en technische aandachtspunten van RAVE
Ken deze beperkingen voordat je op RAVE vertrouwt:
- Vertraging: verwacht zelfs in de causale modus merkbare vertraging, ook op krachtige Apple Silicon. In de studio is dat prima, maar test zorgvuldig voordat je RAVE als live-instrument gebruikt.
- GPU-versnelling: het model gebruikt veel kleine convoluties die door geheugentoegang en niet door rekenwerk worden begrensd, waardoor ze slecht parallel uit te voeren zijn. Bij realtimegebruik weegt de GPU-overhead vaak zwaarder dan het voordeel, tenzij je in batches verwerkt.
- Audiokwaliteit: RAVE kan indrukwekkend klinken, maar haalt mogelijk niet de geluidsgetrouwheid van traditionele synthese of geavanceerdere neurale modellen, zoals diffusiemodellen.
- Moeilijk te trainen: een RAVE-model trainen vraagt expertise in machinelearning en audioverwerking en krachtige hardware.
Vervolg op RAVE: Neutone Morpho en het AFTER-model
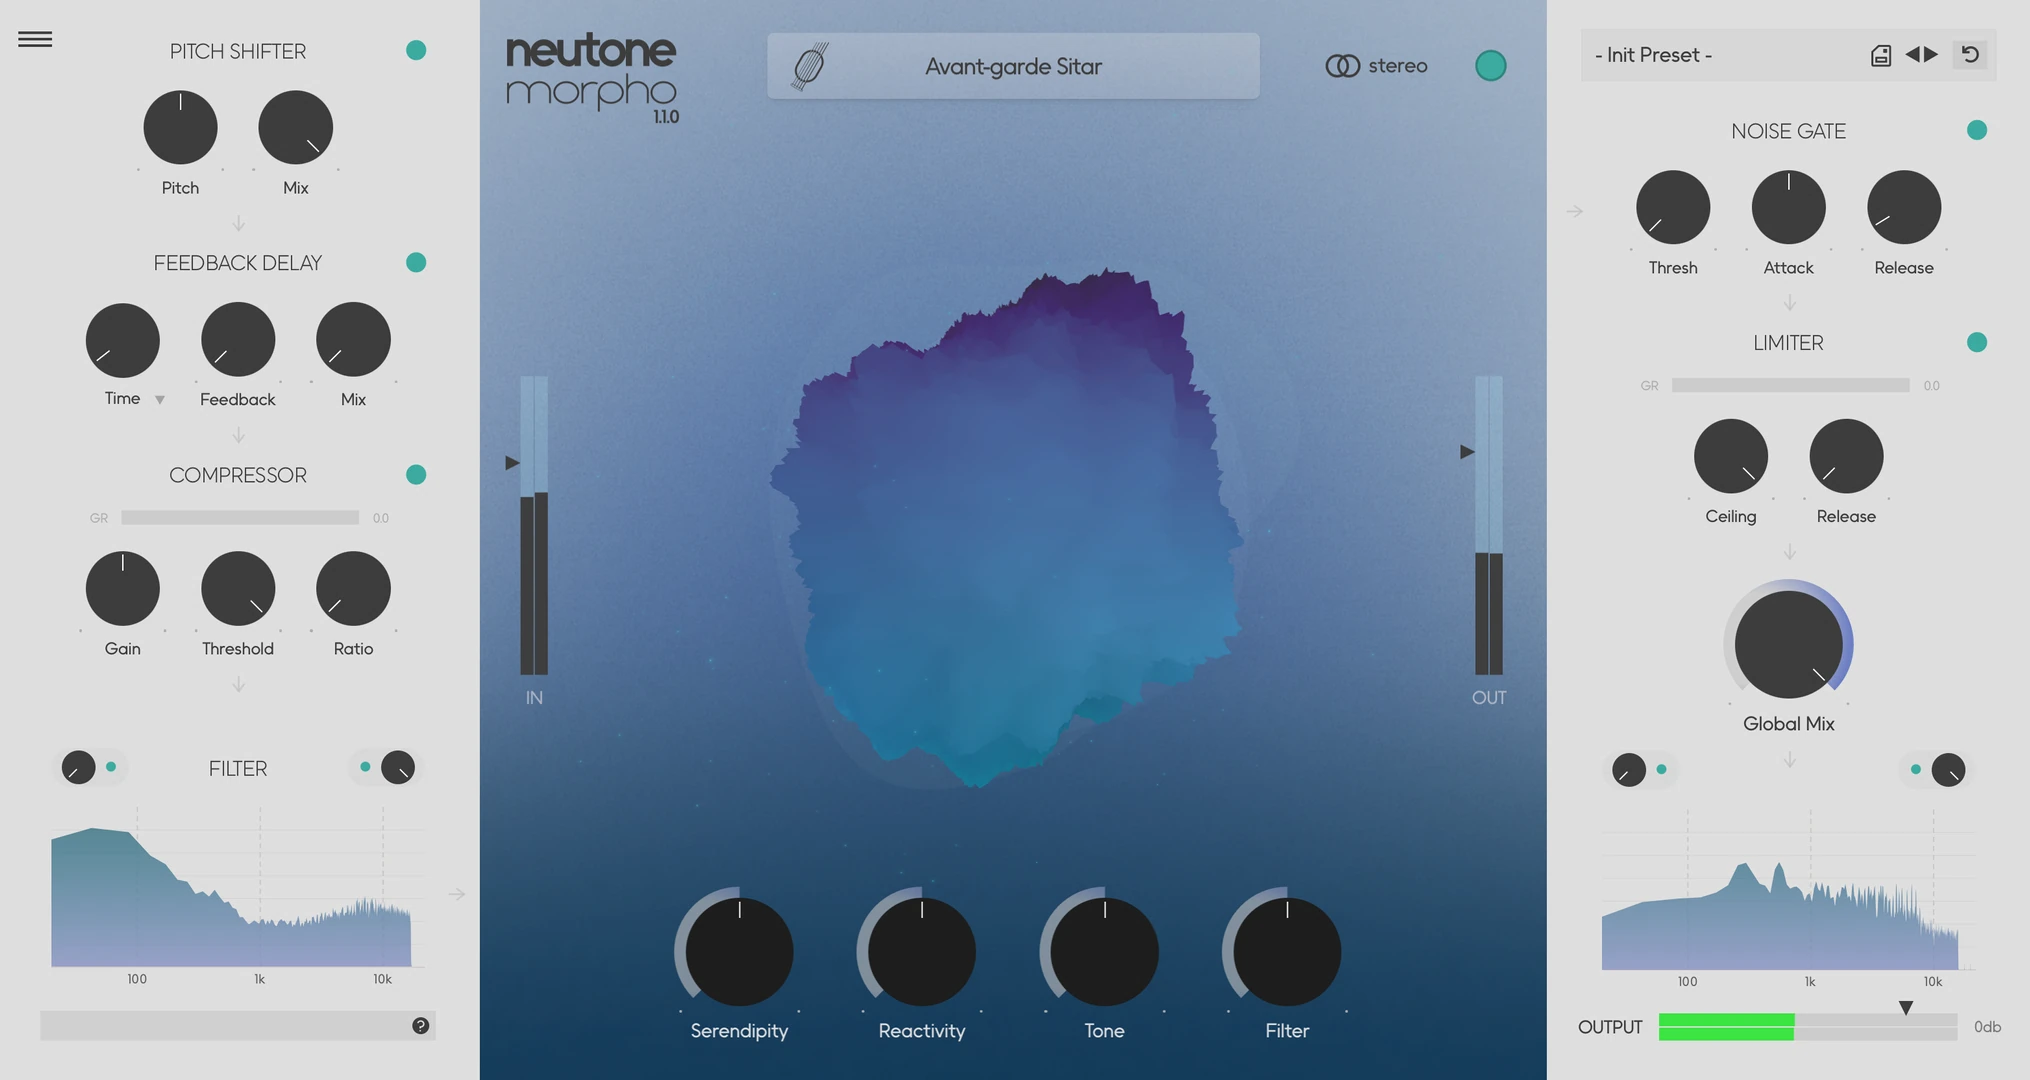
Neutone Morpho: commerciële ontwikkeling van RAVE (2024)
In februari 2024 bracht het Neutone-team onder leiding van Nao Tokui Morpho uit, een commerciële opvolger van hun gratis FX-plugin. RAVE is de open onderzoeksengine. Morpho verwerkt vergelijkbare technologie in een verzorgd product voor muzikanten en producers, ten koste van flexibiliteit.
AFTER-model: op diffusie gebaseerd alternatief van IRCAM
Hetzelfde IRCAM ACIDS-team bracht ook AFTER (Audio Features Transfer and Exploration in Real-time) uit, een diffusiemodel. Het beoogt meer instelmogelijkheden te bieden, met realtimecontrole over timbre zoals bij een traditionele synthesizer.
Om de stijl van een heel nummer op basis van een tekstprompt te veranderen in plaats van één geluid, behoudt AI-remix de vocale stem en genereert het instrumentale deel opnieuw met Stable Audio 3.
RAVE FAQ
Waar kan ik vooraf getrainde RAVE-modellen downloaden?
IRCAM vermeldt streamingmodellen op de officiële RAVE-modelpagina. Neutone FX en de RAVE VST kunnen ook modellen in de plugin downloaden. Controleer de licentie van elk model voordat je het voor een commerciële uitgave gebruikt.
Hoeveel audio heb ik nodig om RAVE te trainen?
Reken op 2 tot 3 uur schone audio uit één bron. RAVE leert alles in de opnamen, ook ruis en kamergalm. Zie voor de hoeveelheden bij DDSP en AFTER hoeveel gegevens je nodig hebt om een model te trainen.
Kan ik RAVE op een Mac trainen?
Dat is geen goede keuze. De RAVE-gids van het UAL Creative Computing Institute vraagt om een NVIDIA-GPU met CUDA en minstens 8 GB geheugen en raadt macOS af. Gebruik een GPU in de cloud of het Colab-notebook van de community.
Waarom klikt mijn RAVE-model in Max?
Het model is zonder --streaming geëxporteerd. Exporteer het opnieuw met die vlag.
RAVE of DDSP?
DDSP heeft maar ongeveer 10 minuten audio nodig, maar modelleert alleen monofone instrumenten met een toonhoogte. RAVE verwerkt elk geluid, ook drums, stemmen en texturen, maar heeft uren audio en dagen training nodig.