IRCAM RAVE 模型:VST、预训练模型与训练
IRCAM 的 RAVE 是一种实时神经音频模型,能将任意声音转换为训练数据的音色。您可以通过 Neutone FX 或 RAVE VST 在 DAW 中播放预训练的 RAVE 模型,通过 nn~ 将其加载到 Max/MSP 或 Pure Data 中,也可以使用 acids-rave Python 包训练自己的模型。
如何使用 RAVE:快速入门
| 目标 | 工具 | 所需条件 |
|---|---|---|
| 在 DAW 中播放 RAVE 模型 | Neutone FX(免费 VST/AU) | 任意 DAW。预训练模型可在插件内下载。 |
| 在 DAW 中播放 RAVE 模型 | RAVE VST(测试版) | 从 IRCAM Forum 下载。源代码仓库已于 2023 年 6 月归档,其 Windows 构建仅支持独立运行。 |
| 在 Max/MSP 或 Pure Data 中使用 RAVE | nn~ 外部对象 | Max 或 Pd,以及一个 .ts 模型文件 |
| 下载预训练模型 | RAVE 官方模型列表 | 为 nn~ 导出的流式 .ts 文件 |
| 训练自己的模型 | Python 上的 acids-rave | 一块显存为 5 至 32 GB 的 NVIDIA GPU、几小时音频,以及约 3 天时间 |
要安装 nn~,请下载最新版本,并将其解压到 Max 的 Documents/Max [your version]/Packages/ 目录,或 Pure Data 的 Documents/Pd/externals/ 目录。将您的 .ts 模型放入 nn_tilde/models 文件夹。

用于实时音频合成的 IRCAM RAVE 是什么?
RAVE 是 Realtime Audio Variational autoEncoder 的缩写,意为实时音频变分自编码器。它由巴黎 IRCAM 的研究人员于 2021 年末发布,学习将声音编码为紧凑的表征,再将其解码回音频。可以把它想象成教计算机为听到的声音画一张草图,再根据草图重绘出对原声的逼真模仿。
它的处理速度足够快,可以在您的 DAW 或现场演出系统中实时运行。
谁在何时开发了 RAVE?
RAVE 由现任职于 Google DeepMind 的 Antoine Caillon 和巴黎 IRCAM ACIDS 团队的 Philippe Esling 开发。
该团队此前研究过 Google 的 DDSP(Differentiable Digital Signal Processing,即可微分数字信号处理)模型,并于 2021 年 3 月进行了展示,但他们希望开发一种更灵活的模型,能处理任何类型的声音,而不局限于乐器。
他们的目标是让模型在普通硬件上运行,同时提供录音室级音质。他们在 2021 年的论文《RAVE:用于快速、高质量神经音频合成的变分自编码器》中介绍了这项工作。
RAVE 架构:这种变分自编码器如何工作
RAVE 是一种自编码器:这种神经网络学习将数据压缩到紧凑的“潜在空间”,再将其解压还原。
RAVE:两阶段训练
阶段 1:表征学习
阶段 2:对抗微调
训练示意图改编自 RAVE 原始论文。阶段 1 使用多频带频谱损失训练编码器和解码器。阶段 2 冻结编码器,阻止梯度通过潜在编码传播,并训练解码器和判别器。PQMF 分析和合成滤波器组保持固定。
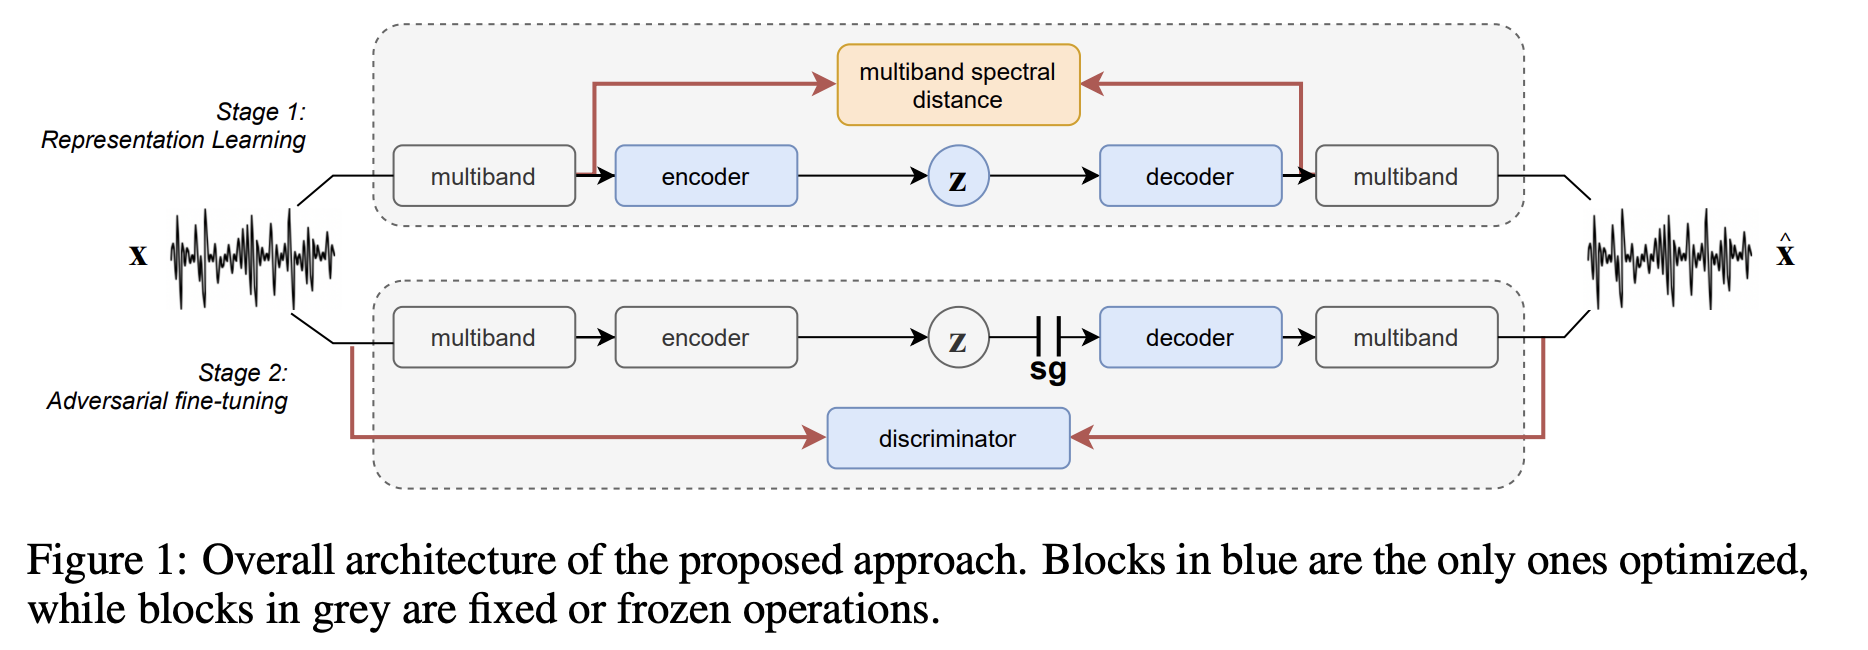
原始图示: RAVE:两阶段训练。
RAVE 的两阶段训练如何进行
可以把它想象成分两个阶段培养一位音乐家:
-
阶段 1:学习聆听(表征学习)
- 编码器学习将音频压缩成一组紧凑的数字,即潜在空间中的表征
- 解码器学习根据这些数字重建音频
- 训练使用频谱损失,比较原始音频与重建音频的频率成分
-
阶段 2:学习即兴演奏(对抗微调)
- 冻结编码器,因为它已经学会如何聆听
- 添加一个“判别器”网络,像评论家一样判断重建音频听起来是否真实
- 解码器根据这些反馈学习,生成更令人信服的音频
关键技术组件
- PQMF 滤波器:RAVE 在处理前将音频拆分成多个频率子带,从而提高效率
- 因果与非因果模式:因果模式以牺牲部分音质为代价,降低现场使用时的延迟
- 多种配置:从可在 Raspberry Pi 上运行的轻量级“raspberry”,到高音质的“v3”
有关实现细节,请参阅 RAVE 官方 GitHub 仓库,其中包含配置文件和模型定义。

如何用自定义音频数据训练 RAVE 模型?
想训练一个将您的声音变成萨克斯音色的模型吗?训练 RAVE 模型需要 Python 知识和 GPU。RAVE 官方仓库记录了完整流程。
数据集准备要求
训练 RAVE 模型需要:
- 2 至 3 小时干净的音频,越多越好
- 录音室级录音,因为 RAVE 会学习其中的所有内容,包括噪声和混响
- 若希望模型用途广泛,需要多样化的声音
要从完整混音中建立数据集,请先通过高质量 AI 分轨分离出乐器。分离伪影也会被模型学进去,因此应尽量使用最干净的分轨。分轨指南说明了如何在 Neural Analog 中完成这些操作。
安装 RAVE 并准备数据集
先为您的 GPU 安装 PyTorch 和 TorchAudio,再安装 RAVE。您还需要 FFmpeg;若使用 conda 环境,请通过 conda 安装:
pip install acids-rave
conda install ffmpeg
预处理会将音频文件转换成 RAVE 的数据集格式:
rave preprocess --input_path /audio/folder --output_path /dataset/path --channels 1单声道使用 --channels 1,立体声使用 --channels 2。添加 --lazy 可以直接使用 MP3 等压缩文件进行训练,但训练期间的 CPU 负载会明显增加。所有参数请参阅 RAVE 数据集准备文档。
RAVE 训练流程与配置
使用配置名称启动训练:
rave train --config v2 --db_path /dataset/path --out_path /model/out --name my_model --channels 1选择适合您 GPU 的配置。最低显存要求来自官方 README:
| 配置 | 最低 GPU 显存 | 适用场景 |
|---|---|---|
raspberry | 5 GB | 可在 Raspberry Pi 4 上实时运行的轻量级模型 |
onnx | 6 GB | 用于 ONNX 导出的无噪声 v1 模型 |
v1 | 8 GB | 原始连续模型 |
v2_small | 8 GB | 稳态声音的音色迁移 |
v2 | 16 GB | 改进后的连续模型,适合作为默认选择 |
discrete | 18 GB | 类似 SoundStream 或 EnCodec 的离散模型 |
v3 | 32 GB | 最高音质,支持风格迁移(AdaIN) |
您可以将配置与 causal(更低延迟)或 noise 等选项组合使用。如果没有自己的 GPU,README 中链接的社区 RAVEv2 Colab 笔记本可使用 Google 的 GPU 进行训练。
训练期间会发生什么:
- 阶段 1(约 100 万步):音质一开始较粗糙,随后逐步改善
- 阶段 2(对抗训练):音质明显提升
- 总耗时:在 RTX 3080 GPU 上约 3 天
社区贡献的 RAVE 训练笔记本提供了逐步操作说明。
导出用于实时运行的 RAVE 模型
导出方式对实时使用很重要。使用 --streaming 标志启用缓存卷积,以避免咔嗒声伪影:
rave export --run /path/to/your/run --streaming导出结果是一个可由 nn~ 加载的 TorchScript .ts 文件。导出参数与故障排查请参阅 RAVE 导出文档。
RAVE 模型推理与实时使用方式
不想等 3 天完成训练?您可以通过多种工具试用预训练的 RAVE 模型。这些工具也支持加载您自己训练的模型,而如何在 DAW 中使用已训练模型的 FAQ 列出了各类模型对应的插件。
Neutone FX:用于 RAVE 模型的免费 VST/AU 插件
Neutone FX 是一个可加载 RAVE 模型的免费 VST/AU 插件。它是 2022 年推出的原版 Neutone 插件,目前作为开放平台持续维护。安装后,您可以直接在 DAW(Ableton、Logic、Reaper 等)中加载一系列预训练模型。

IRCAM 的 RAVE VST(测试版,已归档)
IRCAM 也发布了自己的 RAVE VST,提供 VST、AU 和独立运行的构建。它有两种模式:reconstruction 用于处理 DAW 传来的音频,prior 则通过自行在潜在空间中移动来生成声音。其 Model Explorer 可下载预训练模型;如果使用 --stereo true 导出,您也可以导入自己的模型。
rave_vst 仓库已于 2023 年 6 月归档,因此不要期待后续修复。Windows 仅有实验性的独立构建,M1 Mac 用户必须自行构建。开发者建议实时使用时改用 nn~。
通过 nn~ 集成 Max/MSP 与 Pure Data
在现场演出中,nn~ 外部对象可将 RAVE 模型直接加载到 Max/MSP 和 Pure Data。它支持直接操作潜在空间,并通过自适应实例归一化进行风格迁移。它也能在 Raspberry Pi 等嵌入式平台上运行,适合便携式装置。同类开发板还可运行 ToobAmp、Stompbox 等神经吉他音箱插件。如果您的开发板是 NVIDIA Jetson Nano,请注意它没有模拟音频输出:应先添加 Raspiaudio Audio+ 等 I2S 声卡。
RAVE 的性能限制与技术注意事项
在依赖 RAVE 之前,请了解这些限制:
- 延迟:即使使用因果模式,甚至在高端 Apple Silicon 上,也会有明显延迟。在录音室中通常可以接受,但将 RAVE 作为现场乐器使用前应仔细测试。
- GPU 加速:模型使用大量小型卷积,其瓶颈在内存访问而非计算,因此不易充分并行化。在实时使用中,除非进行批处理,GPU 的额外开销往往超过其带来的收益。
- 音质:RAVE 的声音可能令人印象深刻,但保真度未必能达到传统合成或扩散模型等更高端神经模型的水平。
- 训练难度:训练 RAVE 模型需要机器学习和音频处理专业知识,以及强大的硬件。
RAVE 的后续发展:Neutone Morpho 与 AFTER 模型
Neutone Morpho:RAVE 的商业化演进(2024 年)
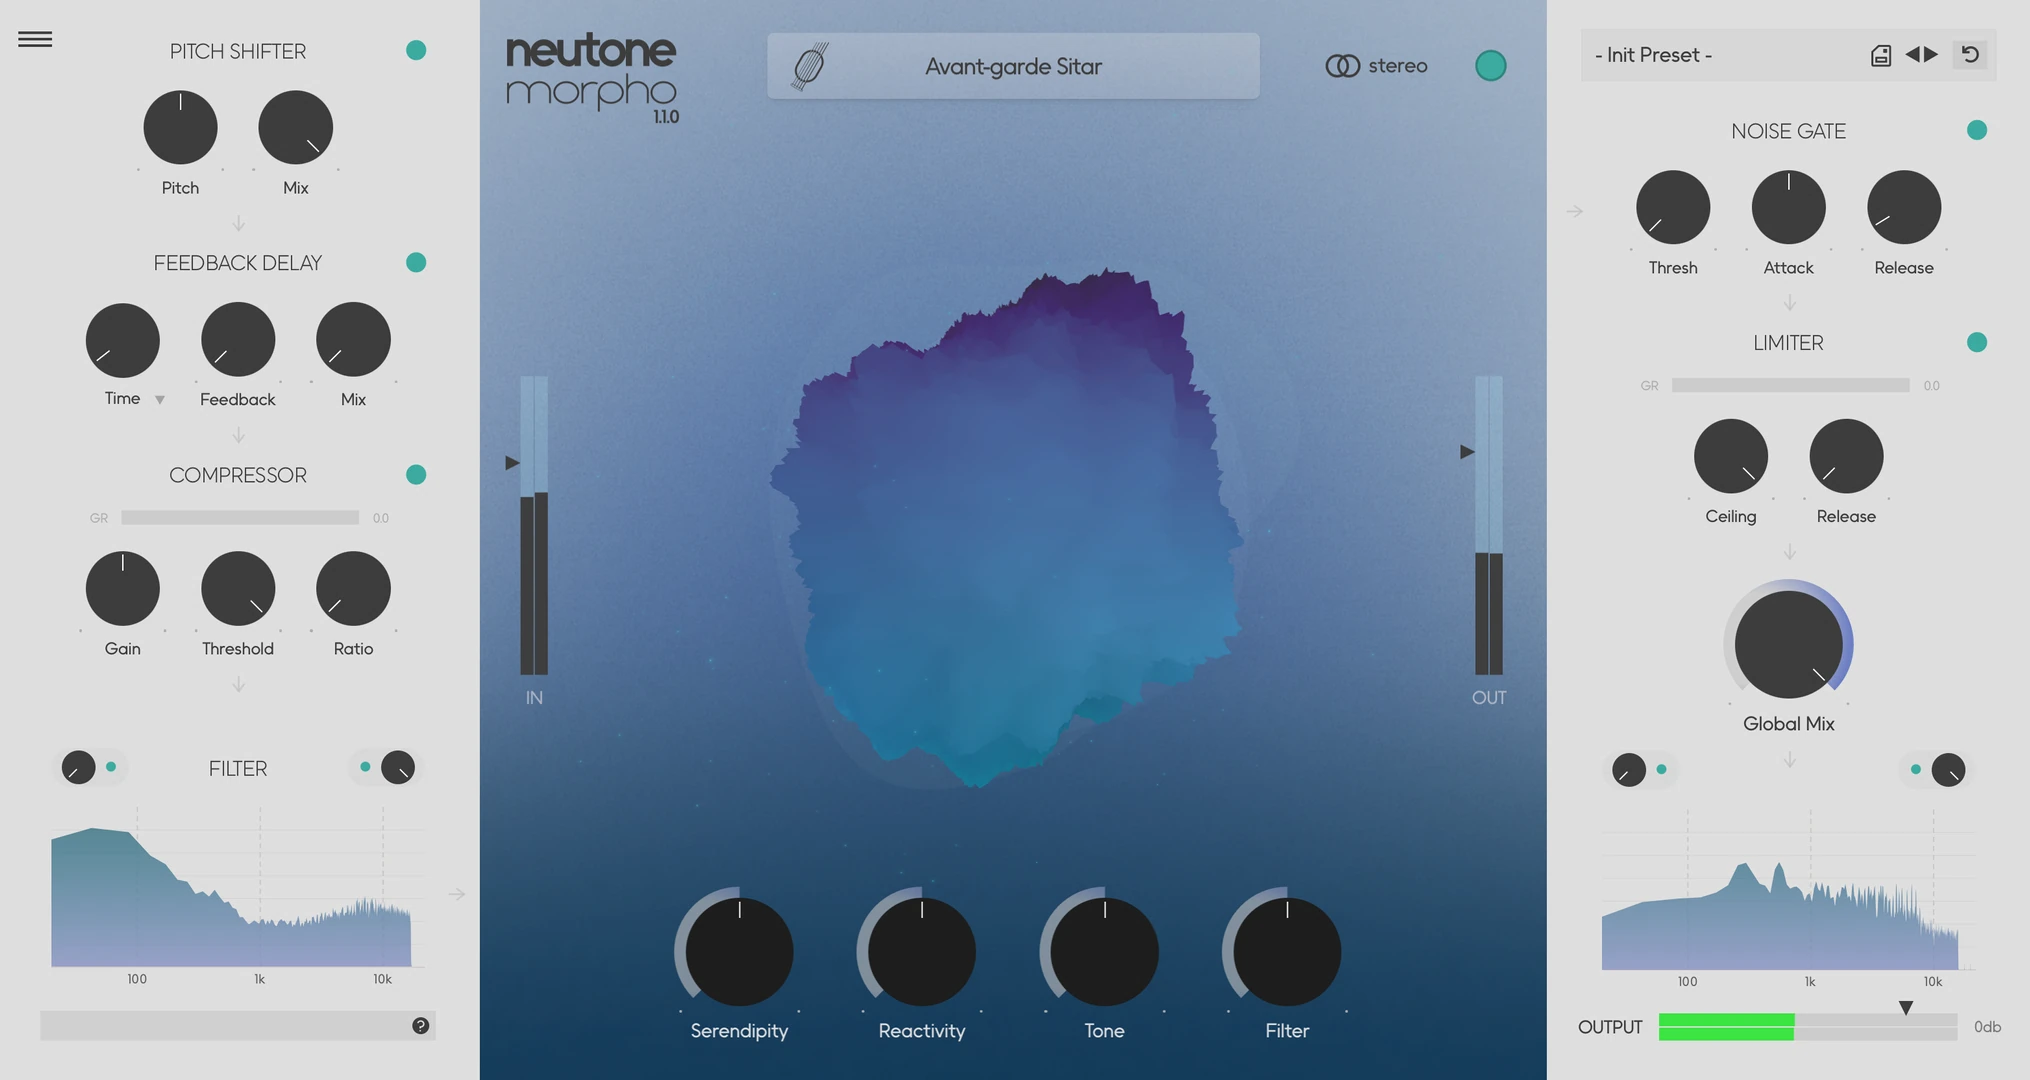
2024 年 2 月,Nao Tokui 领导的 Neutone 团队发布了 Morpho,作为其免费 FX 插件的商业后继产品。RAVE 是开源研究引擎。Morpho 将类似技术封装成面向音乐人和制作人的成熟产品,但牺牲了部分灵活性。
AFTER 模型:IRCAM 的扩散式替代方案
同一个 IRCAM ACIDS 团队还发布了 AFTER(Audio Features Transfer and Exploration in Real-time),一种基于扩散的模型。它旨在提供更多“可调性”,让您像操作传统合成器一样实时控制音色。
若想根据文本提示改变整首歌的风格,而非单个声音,AI 重混会保留人声分轨,并使用 Stable Audio 3 重新生成伴奏。
RAVE 常见问题
在哪里可以下载预训练的 RAVE 模型?
IRCAM 在 RAVE 官方模型页面上列出了流式模型。Neutone FX 和 RAVE VST 也可以在插件内下载模型。将模型用于商业发行前,请检查各模型的许可证。
训练 RAVE 需要多少音频?
请准备来自单一声源的 2 至 3 小时干净音频。RAVE 会学习录音中的所有内容,包括噪声和房间混响。DDSP 和 AFTER 的数据量要求,请参阅训练模型需要多少数据。
可以在 Mac 上训练 RAVE 吗?
并不适合。UAL Creative Computing Institute 的 RAVE 指南要求使用支持 CUDA、显存至少为 8 GB 的 NVIDIA GPU,并建议不要使用 macOS。请改用云端 GPU 或社区 Colab 笔记本。
为什么我的 RAVE 模型在 Max 中会发出咔嗒声?
模型导出时未使用 --streaming。请加上该标志重新导出。
该选 RAVE 还是 DDSP?
DDSP只需约 10 分钟音频,但只能建模一次演奏一个音符的有音高乐器。RAVE 可处理任何声音,包括鼓、人声和声音纹理,但需要几小时音频和数天训练时间。