Modelo RAVE de IRCAM: VST, modelos preentrenados y entrenamiento
El modelo RAVE de IRCAM es un modelo neuronal de audio en tiempo real que transforma cualquier sonido en el timbre con el que se entrenó. Puedes tocar modelos RAVE preentrenados en tu DAW con Neutone FX o RAVE VST, cargarlos en Max/MSP o Pure Data con nn~ o entrenar los tuyos con el paquete Python acids-rave.
Cómo usar RAVE: inicio rápido
| Objetivo | Herramienta | Qué necesitas |
|---|---|---|
| Tocar modelos RAVE en un DAW | Neutone FX (VST/AU gratuito) | Cualquier DAW. Los modelos preentrenados se descargan dentro del plugin. |
| Tocar modelos RAVE en un DAW | RAVE VST (beta) | Una descarga de IRCAM Forum. El repositorio de código se archivó en junio de 2023 y su versión Windows solo es autónoma. |
| Usar RAVE en Max/MSP o Pure Data | Objeto externo nn~ | Max o Pd y un archivo de modelo .ts |
| Descargar modelos preentrenados | Lista oficial de modelos RAVE | Exportaciones .ts en streaming para nn~ |
| Entrenar tu propio modelo | acids-rave en Python | Una GPU NVIDIA con entre 5 y 32 GB de memoria, unas horas de audio y unos 3 días |
Para instalar nn~, descarga la última versión y extráela en Documents/Max [your version]/Packages/ para Max o en Documents/Pd/externals/ para Pure Data. Pon tus modelos .ts en la carpeta nn_tilde/models.

¿Qué es RAVE de IRCAM para síntesis de audio en tiempo real?
RAVE significa Realtime Audio Variational autoEncoder, es decir, autoencoder variacional de audio en tiempo real. Publicado a finales de 2021 por investigadores de IRCAM en París, aprende a codificar sonidos en una representación compacta y después a decodificarlos como audio. Imagínalo como enseñar a un ordenador a dibujar un boceto de lo que oye y después convertirlo en una imitación convincente del sonido original.
Lo hace lo bastante rápido como para funcionar en tiempo real en tu DAW o en tu equipo para actuaciones en directo.
¿Quién creó RAVE y cuándo?
RAVE fue desarrollado por Antoine Caillon, que ahora trabaja en Google DeepMind, y Philippe Esling, del equipo ACIDS de IRCAM en París.
El equipo había explorado antes el modelo DDSP (Differentiable Digital Signal Processing) de Google y lo presentó en marzo de 2021, pero quería un modelo más flexible que pudiera tratar cualquier tipo de sonido, no solo instrumentos musicales.
Su objetivo era un modelo que funcionara en hardware estándar y produjera audio de calidad de estudio. Lo presentaron en su artículo de 2021, «RAVE: un autoencoder variacional para la síntesis neuronal de audio rápida y de alta calidad».
Arquitectura RAVE: cómo funciona este autoencoder variacional
RAVE es un autoencoder: una red neuronal que aprende a comprimir datos en un «espacio latente» compacto y después a descomprimirlos.
RAVE: entrenamiento en dos etapas
Etapa 1: aprendizaje de representaciones
Etapa 2: ajuste fino adversarial
Diagrama de entrenamiento adaptado del artículo original de RAVE. La etapa 1 entrena el encoder y el decoder con una pérdida espectral multibanda. La etapa 2 congela el encoder, bloquea los gradientes a través del código latente y entrena el decoder y el discriminador. El análisis y la síntesis PQMF permanecen fijos.
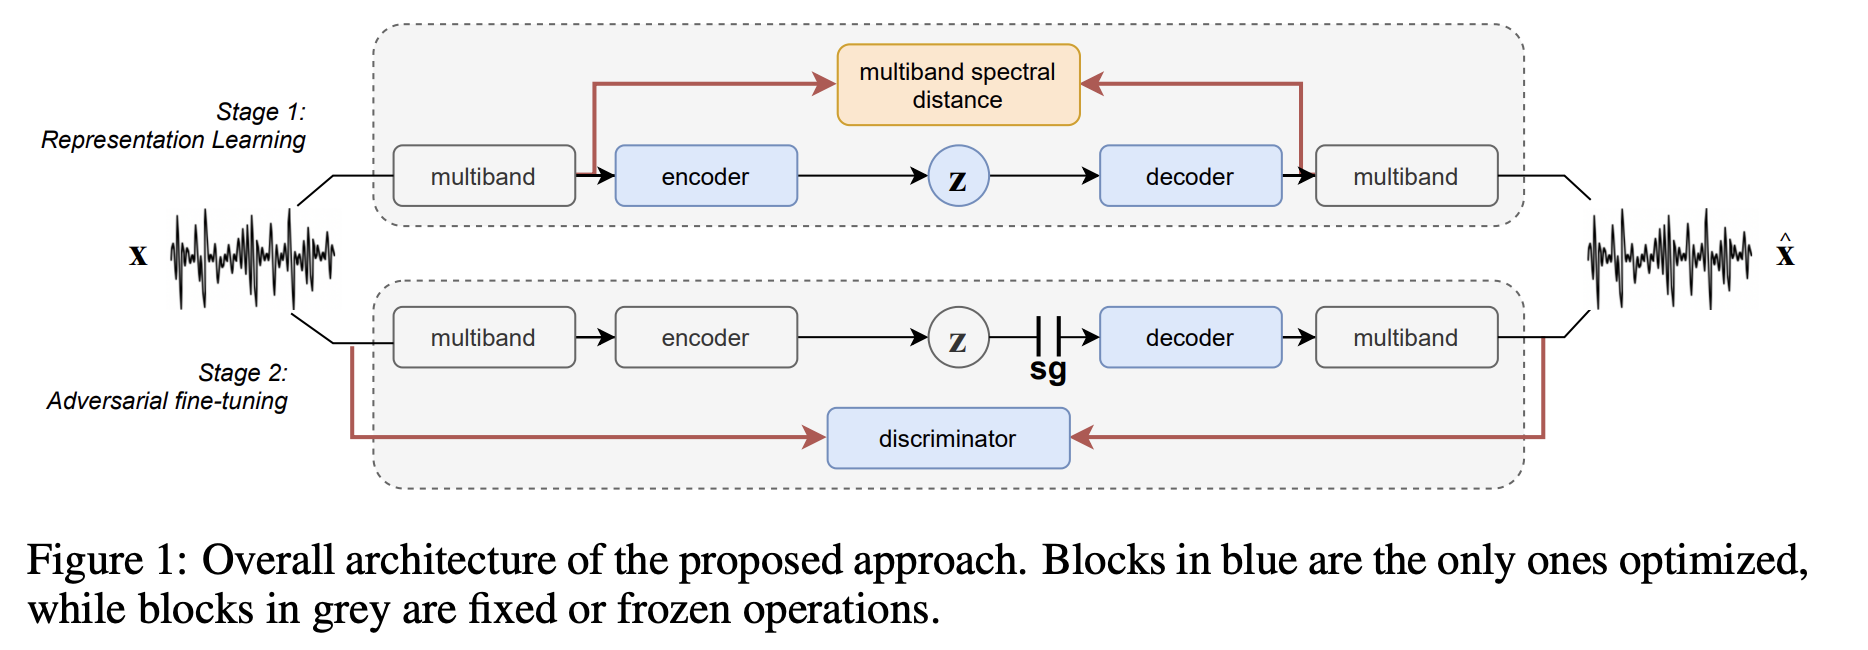
Figura original: RAVE: entrenamiento en dos etapas.
Cómo funciona el entrenamiento de RAVE en dos etapas
Piensa en formar a un músico en dos fases:
-
Fase 1: aprender a escuchar (aprendizaje de representaciones)
- El encoder aprende a condensar el audio en un conjunto compacto de números, el espacio latente
- El decoder aprende a reconstruir audio a partir de esos números
- El entrenamiento usa una pérdida espectral que compara el contenido frecuencial del audio original y del reconstruido
-
Fase 2: aprender a improvisar (ajuste fino adversarial)
- El encoder se congela, porque ya sabe escuchar
- Se añade una red «discriminadora»: un crítico que juzga si el audio reconstruido suena real
- El decoder aprende de esa información a producir un audio más convincente
Componentes técnicos principales
- Filtros PQMF: RAVE divide el audio en varias subbandas de frecuencia antes de procesarlo, lo que mejora la eficiencia
- Modos causal y no causal: el modo causal sacrifica algo de calidad para reducir la latencia en directo
- Varias configuraciones: desde la ligera "raspberry", que funciona en Raspberry Pi, hasta "v3", centrada en la calidad
Para detalles de implementación, consulta el repositorio oficial de RAVE en GitHub, que incluye los archivos de configuración y las definiciones de los modelos.

Cómo entrenar modelos RAVE con tus propios datos de audio
¿Quieres un modelo que transforme tu voz en un saxofón? Entrenar un modelo RAVE requiere conocimientos de Python y una GPU. El repositorio oficial de RAVE documenta el proceso completo.
Requisitos para preparar el conjunto de datos
Para entrenar un modelo RAVE necesitas:
- Entre 2 y 3 horas de audio limpio, cuanto más, mejor
- Grabaciones de calidad de estudio, porque RAVE aprende todo, incluido el ruido y la reverberación
- Sonidos variados si quieres versatilidad
Para crear un conjunto de datos a partir de mezclas completas, aísla primero el instrumento con la separación de pistas IA de alta calidad. Los artefactos de separación también acaban en el modelo, así que usa las pistas más limpias que puedas conseguir. La guía de separación de pistas explica cómo hacerlo en Neural Analog.
Instala RAVE y prepara tu conjunto de datos
Instala primero PyTorch y TorchAudio para tu GPU y después RAVE. También necesitas FFmpeg; en un entorno conda, instálalo con conda:
pip install acids-rave
conda install ffmpeg
El preprocesamiento convierte tus archivos de audio al formato de conjunto de datos de RAVE:
rave preprocess --input_path /audio/folder --output_path /dataset/path --channels 1Usa --channels 1 para mono o --channels 2 para estéreo. Añade --lazy para entrenar directamente con archivos comprimidos como MP3, pero espera una carga de CPU mucho mayor durante el entrenamiento. Consulta todos los parámetros en la documentación de preparación de datos de RAVE.
Proceso y configuraciones de entrenamiento de RAVE
Inicia el entrenamiento con un nombre de configuración:
rave train --config v2 --db_path /dataset/path --out_path /model/out --name my_model --channels 1Elige la configuración adecuada para tu GPU. La memoria GPU mínima procede del README oficial:
| Configuración | Memoria GPU mín. | Uso |
|---|---|---|
raspberry | 5 GB | Modelo ligero para tiempo real en Raspberry Pi 4 |
onnx | 6 GB | v1 sin ruido para exportar a ONNX |
v1 | 8 GB | El modelo continuo original |
v2_small | 8 GB | Transferencia de timbre en sonidos estacionarios |
v2 | 16 GB | El modelo continuo mejorado y una buena opción predeterminada |
discrete | 18 GB | Un modelo discreto similar a SoundStream o EnCodec |
v3 | 32 GB | La mayor calidad, con transferencia de estilo (AdaIN) |
Puedes combinar una configuración con opciones como causal para reducir la latencia o noise. Un cuaderno Colab comunitario para RAVEv2, enlazado desde el README, permite entrenar en las GPU de Google si no tienes una.
Qué esperar durante el entrenamiento:
- Fase 1 (~1M pasos): la calidad de audio empieza siendo pobre y mejora gradualmente
- Fase 2 (entrenamiento adversarial): la calidad mejora mucho
- Tiempo total: unos 3 días en una GPU RTX 3080
Los cuadernos de entrenamiento de RAVE de la comunidad explican el proceso paso a paso.
Exportar modelos RAVE para usarlos en tiempo real
La exportación importa para el uso en tiempo real. Usa la opción --streaming para activar convoluciones en caché, lo que evita los artefactos de clics:
rave export --run /path/to/your/run --streamingEl resultado es un archivo TorchScript .ts que nn~ puede cargar. Para los parámetros de exportación y la solución de problemas, consulta la documentación de exportación de RAVE.
Inferencia de RAVE y opciones de uso en tiempo real
¿No quieres esperar 3 días de entrenamiento? Puedes probar modelos RAVE preentrenados en varias herramientas. También cargan modelos que entrenes tú, y la FAQ sobre cómo usar un modelo entrenado en tu DAW indica el plugin de cada tipo de modelo.
Neutone FX: plugin VST/AU gratuito para modelos RAVE
Neutone FX es un plugin VST/AU gratuito que aloja modelos RAVE. Es el plugin Neutone original de 2022, ahora mantenido como plataforma abierta. Instálalo para cargar una colección de modelos preentrenados directamente en tu DAW (Ableton, Logic, Reaper y otros).

RAVE VST de IRCAM, en beta y archivado
IRCAM también publicó su propio RAVE VST, con versiones VST, AU y autónomas. Tiene dos modos: reconstruction, que procesa el audio de tu DAW, y prior, que genera sonido recorriendo el espacio latente por su cuenta. Su Model Explorer descarga modelos preentrenados y puedes importar los tuyos si los exportas con --stereo true.
El repositorio rave_vst se archivó en junio de 2023, así que no esperes correcciones. En Windows solo existe una versión autónoma experimental, y los usuarios de Mac M1 deben compilarlo por su cuenta. Los desarrolladores recomiendan nn~ para el uso en tiempo real.
Integración con Max/MSP y Pure Data mediante nn~
Para actuaciones en directo, el objeto externo nn~ carga modelos RAVE directamente en Max/MSP y Pure Data. Permite manipular directamente el espacio latente y usar Adaptive Instance Normalization para transferir estilos. También funciona en plataformas integradas como Raspberry Pi para instalaciones portátiles. Las mismas placas ejecutan plugins neuronales de amplificadores de guitarra como ToobAmp y Stompbox. Si tu placa es una NVIDIA Jetson Nano, recuerda que no tiene salida de audio analógica: añade primero una tarjeta de sonido I2S como Raspiaudio Audio+.
Limitaciones de rendimiento y precauciones técnicas de RAVE
Conoce estas limitaciones antes de depender de RAVE:
- Latencia: incluso en modo causal, espera un retardo perceptible, también en Apple Silicon de gama alta. Puede servir en el estudio, pero prueba RAVE con cuidado antes de usarlo como instrumento en directo.
- Aceleración GPU: el modelo usa muchas convoluciones pequeñas limitadas por el acceso a memoria, no por la capacidad de cálculo, por lo que no se paraleliza bien. En tiempo real, el coste adicional de la GPU suele superar la ventaja, salvo en procesamiento por lotes.
- Calidad de audio: RAVE puede sonar impresionante, pero quizá no alcance la fidelidad de la síntesis tradicional o de modelos neuronales más avanzados, como los basados en difusión.
- Dificultad de entrenamiento: entrenar RAVE requiere experiencia en aprendizaje automático y procesamiento de audio, además de hardware potente.
Después de RAVE: Neutone Morpho y el modelo AFTER
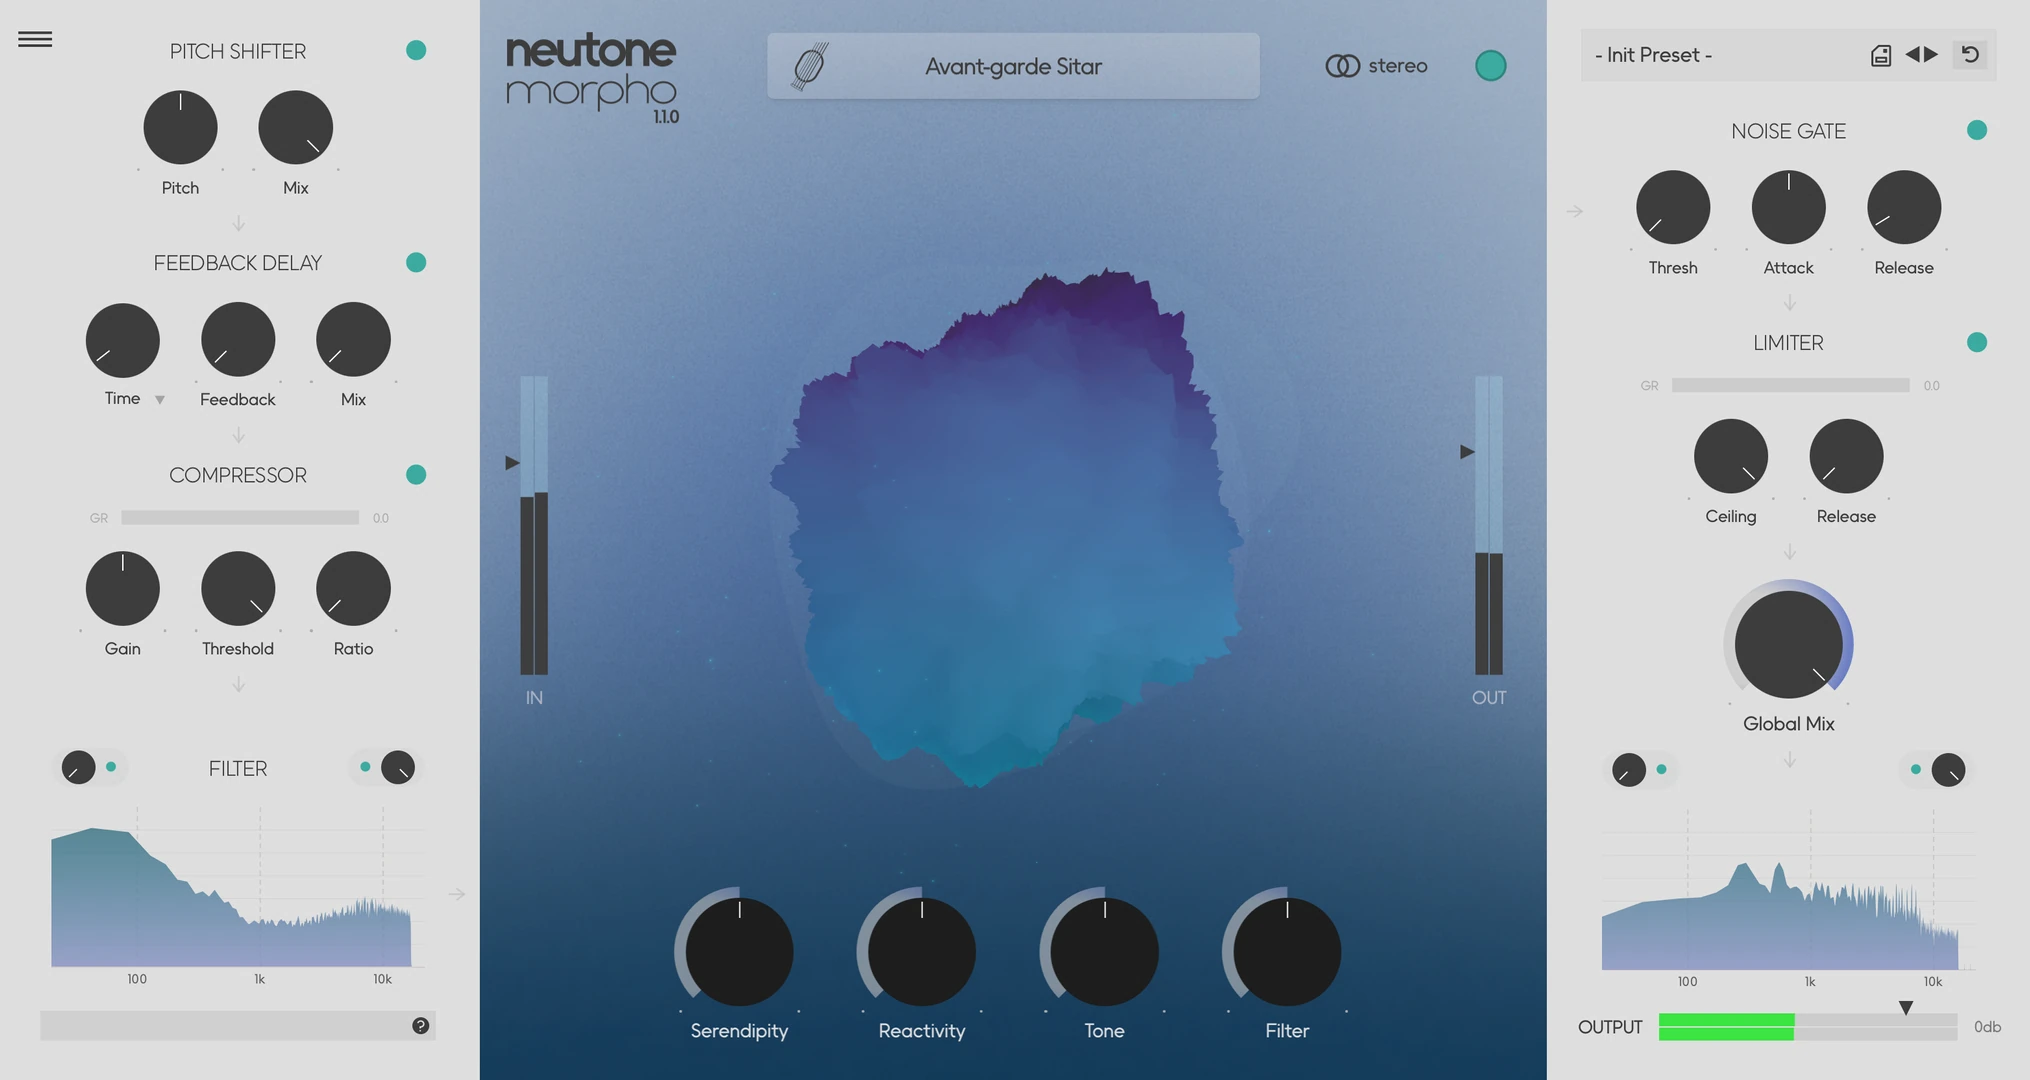
Neutone Morpho: evolución comercial de RAVE en 2024
En febrero de 2024, el equipo Neutone dirigido por Nao Tokui publicó Morpho, un sucesor comercial de su plugin FX gratuito. RAVE es el motor de investigación de código abierto. Morpho integra tecnología similar en un producto pulido para músicos y productores a cambio de menor flexibilidad.
Modelo AFTER: alternativa de IRCAM basada en difusión
El mismo equipo IRCAM ACIDS también publicó AFTER (Audio Features Transfer and Exploration in Real-time), un modelo basado en difusión. Busca ofrecer más posibilidades de ajuste, con control del timbre en tiempo real como un sintetizador tradicional.
Para cambiar el estilo de una canción completa a partir de un prompt de texto, en lugar de un solo sonido, el remix IA conserva la pista vocal y regenera el instrumental con Stable Audio 3.
Preguntas frecuentes sobre RAVE
¿Dónde puedo descargar modelos RAVE preentrenados?
IRCAM enumera modelos en streaming en la página oficial de modelos RAVE. Neutone FX y RAVE VST también pueden descargar modelos desde el plugin. Comprueba la licencia de cada modelo antes de usarlo en un lanzamiento comercial.
¿Cuánto audio necesito para entrenar RAVE?
Calcula entre 2 y 3 horas de audio limpio de una sola fuente. RAVE aprende todo lo que hay en las grabaciones, incluido el ruido y la reverberación de la sala. Para las cantidades de DDSP y AFTER, consulta cuántos datos necesitas para entrenar un modelo.
¿Puedo entrenar RAVE en un Mac?
No es una buena opción. La guía RAVE del UAL Creative Computing Institute pide una GPU NVIDIA compatible con CUDA con al menos 8 GB de memoria y desaconseja macOS. Usa una GPU en la nube o el cuaderno Colab de la comunidad.
¿Por qué mi modelo RAVE produce clics en Max?
El modelo se exportó sin --streaming. Expórtalo de nuevo con esa opción.
¿RAVE o DDSP?
DDSP solo necesita unos 10 minutos de audio, pero únicamente modela instrumentos monofónicos de altura definida. RAVE trata cualquier sonido, incluidas baterías, voces y texturas, pero necesita horas de audio y días de entrenamiento.