DDSP 指南:Magenta DDSP VST、训练与工作原理
DDSP(可微数字信号处理)是 Google Magenta 的开源库,让神经网络控制传统声音发生器:振荡器、滤波噪声与混响。Magenta 在 2024 年归档了 DDSP VST,但这款免费插件仍可下载,并在 Windows 与 macOS 上运行。您也可以用免费的 Google Colab 笔记本训练自己的乐器模型。
本指南先介绍这两个实用操作,再解释 DDSP 的工作原理、局限,以及后来取代它的新模型。
现在如何使用 DDSP:快速入门
下载并安装 DDSP VST
- 下载 macOS 或 Windows 版插件。两个链接都来自 DDSP VST 官方仓库。
- 解压文件。其中包含两款插件:DDSP Effect 将输入音频(例如您的声音)变成乐器音色;DDSP Synth 则通过 MIDI 演奏。
- 在 macOS 上,将插件复制到
/Library/Audio/Plug-Ins/Components(AU)和/Library/Audio/Plug-Ins/VST3。在 Windows 上,将 VST3 文件复制到C:\Program Files\Common Files\VST3。 - 在 DAW 中重新扫描插件。
没有官方 Linux 版本。若想不安装任何软件就试听 DDSP,可以尝试 Tone Transfer 网页演示。
训练自己的 DDSP 乐器
Magenta 的 DDSP VST 训练笔记本在 Google Colab 中运行,因此不需要本地 GPU:
- 在 Google Drive 文件夹中放入至少 10 分钟的
.wav或.mp3音频。使用来自同一次录音、同一支麦克风与同一房间的单音音频,即每次只演奏一个音符。 - 打开笔记本,运行安装单元格(约 5 分钟),再运行训练单元格并选择文件夹。
- 等待训练完成。免费 Colab 上约需 2 至 3 小时,Colab Pro+ 上则不到一小时。如果 Colab 断线,用同一文件夹重新运行单元格,训练会继续。
- 将下载的模型文件夹解压到插件的模型目录。在 Mac 上,该目录为
~/Documents/Magenta/DDSP/Models,也可从插件内部打开。
笔记本说明,通常训练 30,000 至 50,000 步后效果较好。步数太少,声音会平淡;太多则可能出现断续爆音与大幅音量跳变。
历史与演变:从 Magenta 到现代插件
Magenta 研究实验室(2016 至 2024 年)
Google 的 Magenta 于 2016 年推出,是一个用机器学习研究音乐与艺术的开源项目。它发布了许多音乐生成工具,但到 2024 年,大部分项目已归档。
Open NSynth Super(2017 年)
在 DDSP 之前,Magenta 推出了 Open NSynth Super,一款基于 NSynth 的硬件乐器。NSynth 数据集包含来自 1,006 件乐器的约 305,000 个单音采样。这台设备采用 Raspberry Pi 与定制 PCB,可让演奏者实时在不同乐器音色之间渐变。
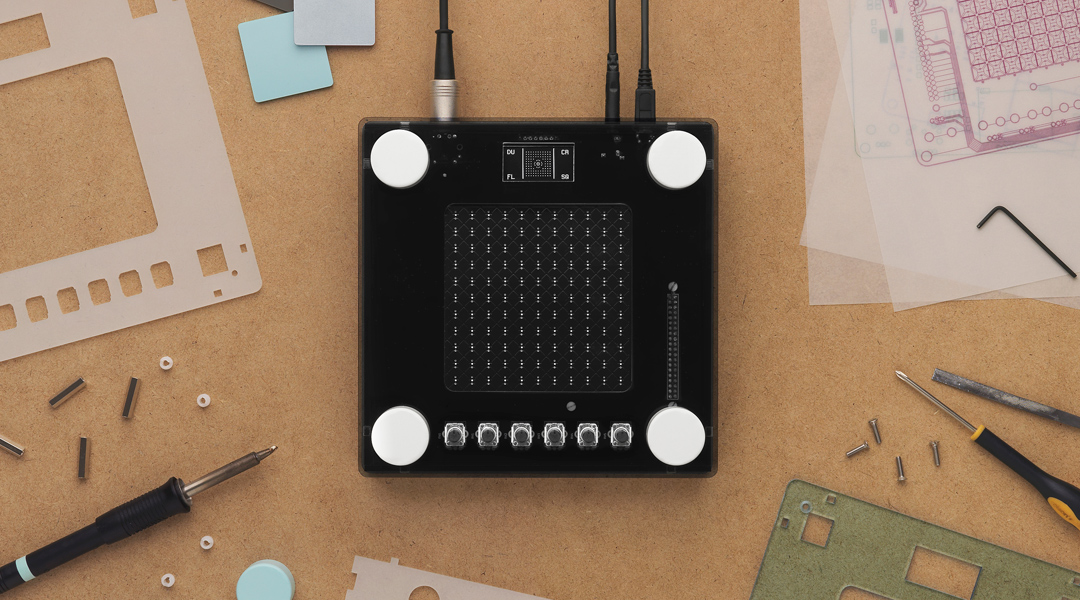
NSynth 模型是类似 WaveNet 的自编码器。由于计算成本高,音频被限制在 16-bit/16 kHz,因此输出有明显的低保真听感。音频工程师 Joe Boston 形容它有“颗粒感”,但也通过外部效果器找到了创意用途。该硬件项目于 2025 年 8 月归档。
DDSP 与 Tone Transfer(2020 年)
2020 年,Magenta 发布了 DDSP 库及其 ICLR 论文,引入常见信号处理模块的可微版本。Tone Transfer 网页演示让用户将歌声等录音转换为小提琴、萨克斯、小号或长笛音色。
这些模型是基于 RNN 的自编码器,每种乐器使用约 10 分钟的单音音频训练。演示可用,但 16 kHz 输出与有限的演奏细节建模限制了效果。
MIDI DDSP 与 VST 插件(2022 至 2024 年)
Magenta 于 2022 年 1 月推出 MIDI DDSP,扩展了 DDSP。它直接根据单音 MIDI 序列合成乐器音频。如果希望通过录制的采样而非神经模型演奏 MIDI,可以在免费的 sforzando 播放器中加载 SFZ 乐器。
2022 年 6 月,Magenta 发布了 DDSP VST 插件,可在 DAW 中实时迁移音色。两个项目都于 2024 年归档:MIDI DDSP 在 2 月,VST 在 10 月。

MAWF 音频插件(2023 年)
Hanoi Hantrakul(yaboihanoi)曾任 Tone Transfer 技术负责人,自 2020 年起在 ByteDance 工作,于 2023 年推出 MAWF。这款免费 VST/AU 插件可进行 48 kHz 实时神经音频合成,突破早期 DDSP 实现的 16 kHz 限制。

DDSP 如何工作?自编码器与 DSP 的结合
DDSP是一种自编码器,其解码器驱动模块化 DSP 组件,而不是直接生成波形。
DDSP 自编码器架构
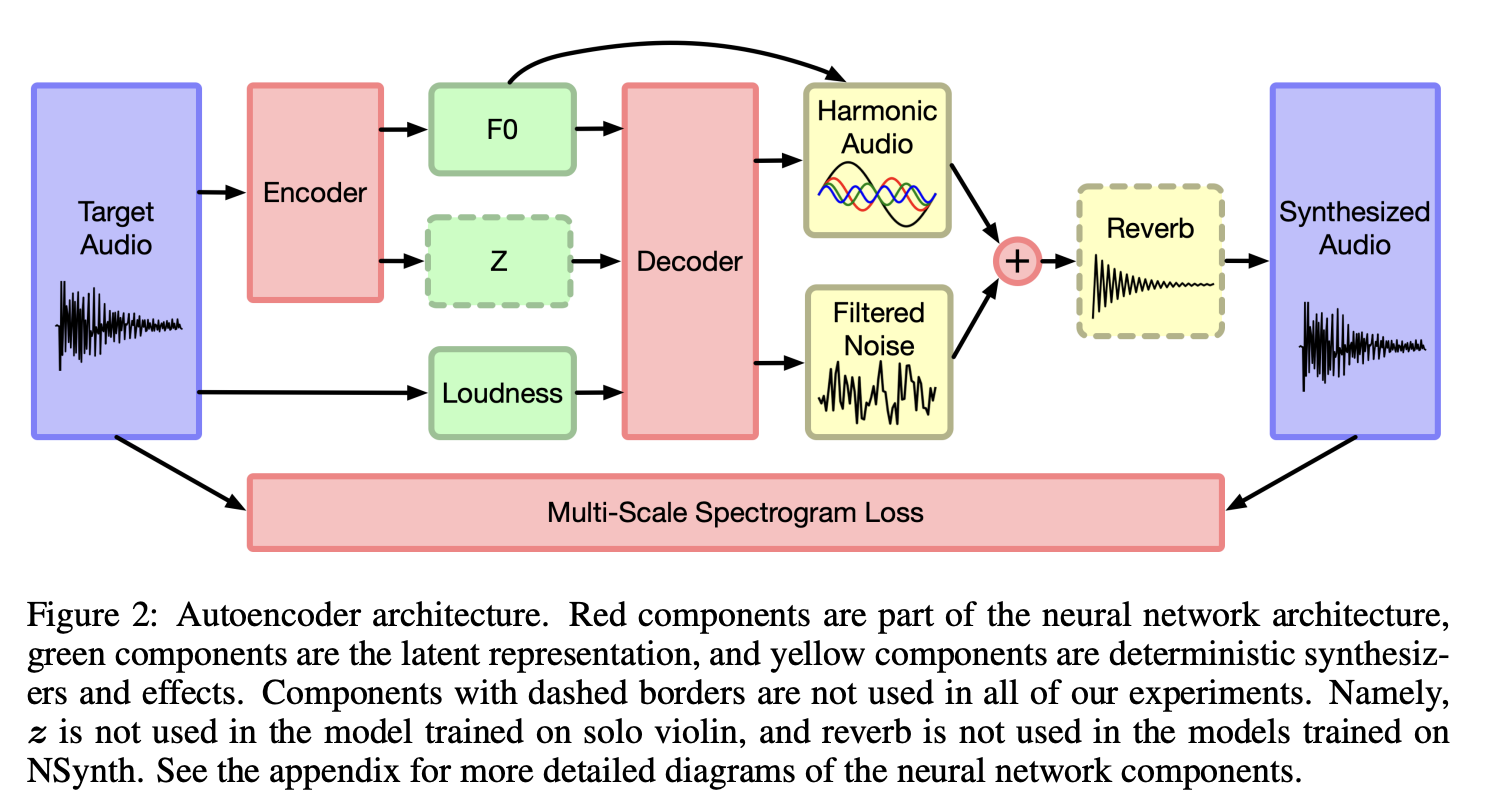
原始图示: DDSP 自编码器架构。
编码器
编码器将输入音频转成两条控制曲线:**基频(f0,即音高)**由预训练的 CREPE 音高跟踪器估计;响度则直接从信号计算。可选的残差编码器(对 MFCC 序列运行 GRU)添加一个潜在向量,描述音高与响度无法捕捉的音色细节。这些低维信号描述了演奏。
解码器与合成模块
循环解码器(GRU)将控制信号映射为三个 DSP 组件的参数:
- 谐波加法合成器:在基频的整数倍频率上生成最多 100 个正弦分音,用于声音中具有明确音高的部分。
- 滤波噪声合成器:使用随时间变化的 FIR 滤波器塑造白噪声,以模拟呼吸与弓擦噪声。
- 可微混响:通过学习得到的脉冲响应加入房间声学特性。
每个组件都可微,因此整个模型可通过多尺度频谱损失进行端到端训练。它预测每帧数百个合成参数,而不是逐个采样点生成音频。
为研究训练 DDSP 模型
如果模型要在 DDSP VST 中演奏,请使用前文快速入门介绍的 DDSP VST 训练笔记本。若要修改架构或损失函数,可从库中的 Colab 教程开始。教程需要基本 Python 技能,涵盖预处理、配置与 Colab GPU 训练。
实时使用 DDSP 的插件
Magenta 的官方项目已归档,但仍可用以下工具在 DAW 中运行 DDSP:
1. Magenta DDSP VST(已归档)
DDSP VST 官方插件仍可用于实验,安装步骤见前面的快速入门。它包含五种乐器模型,支持 MIDI 与音频输入。用户反馈输出带有较重混响,似乎用来掩盖伪影。
2. Neutone FX 平台
Neutone FX提供一款免费插件,可加载社区训练的模型,包括基于 DDSP 的音色迁移网络。制作人可以使用数十种模型,而不局限于 Magenta 最初的乐器。

3. yaboihanoi 的 MAWF(推荐)
MAWF 插件在 DAW 内以 48 kHz 进行 DDSP 合成。它内置多种乐器模型,是目前完成度最高的 DDSP 实现。

不过,MAWF 下载网站自 2025 年 11 月起一直无法访问。如果找到其他插件来源,我会更新本文。
DDSP 有哪些局限?
DDSP 的限制来自其架构与合成方式:
- 仅支持单音:DDSP 模型无法生成复音音频。它们以单音录音训练,谐波合成器假设每个时间步只有一个基频。
- 音质:MAWF 的 48 kHz 模型听感更好,但最初的 16 kHz 实现有金属感伪影,高频内容很少。音频超分辨率模型可以为旧渲染结果重建缺失高频:请参阅如何从 GitHub 安装并运行 AudioSR,或 UniverSR 如何将 22 kHz 的 RPG Maker 音效修复为 48 kHz。
- GPU 并行能力有限:循环层按顺序逐帧处理,因此不像卷积模型那样可在 GPU 上沿时间维度并行。
DDSP 之后:RAVE、DDSP-CNN-Tiny 与 AFTER
RAVE(2021 年)
RAVE使用因果 CNN 而非 RNN,带来更快训练与 48 kHz 合成,也更善于建模音色。它是一种通过对抗训练(判别器)进一步改进的变分自编码器,使用相近的数据量达到更高保真度。
DDSP-CNN-Tiny(2022 年)
DDSP-CNN-Tiny以轻量 CNN 替换 DDSP 的 RNN,缩小模型并加快推理。音质仍相近,且可在 CPU 上实时运行。NAM 与 AIDA-X 等免费神经吉他音箱插件同样通过在 CPU 上运行小型网络工作。Václav Volhejn 在 ETH Zurich 的学位论文中开发了它,他关于实时 DDSP 的论文值得作为技术资料阅读。
AFTER(2024 年)
AFTER 模型在神经音频编解码器之上运行潜在扩散,达到录音室级音频合成。它比 DDSP 需要更多计算,但音色迁移的伪影少得多,因此更适合专业制作。
DDSP 常见问题
Magenta DDSP 还在维护吗?
部分项目仍在维护。ddsp 库并未归档,仍有提交。Magenta 于 2024 年 2 月归档 MIDI DDSP,于 2024 年 10 月归档 DDSP VST,所以插件不再更新。本指南于 2026 年 10 月更新时,插件下载与训练笔记本仍可使用。
DDSP VST 支持 Linux 吗?
没有官方 Linux 版本。您需要自行从源代码构建。
DDSP 能演奏和弦吗?
不能。DDSP 模型是单音的,每次只跟随一个音高。若需要复音 MIDI 控制,可以了解 AFTER。
DDSP 与 RAVE:应该训练哪一个?
如果只针对一种有明确音高的乐器,只有约 10 分钟音频和免费 Colab GPU,请选择 DDSP。若要处理任何声音,包括鼓、纹理与人声,请选择 RAVE。RAVE 需要几小时音频和数天 GPU 训练。常见问题比较了 DDSP、RAVE 与 AFTER 分别需要多少训练音频,以及哪个插件能在 DAW 中播放各自训练的模型。