IRCAM AFTER 模型:安装、预训练模型与训练
IRCAM 的 AFTER 模型是一款神经音频合成模型,音乐人可以使用熟悉的输入,实时进行复音控制:输入 MIDI 音符,或另一段音频信号的音高和响度。
要试用它,请从 IRCAM 共享文件夹下载预训练模型和 Max 补丁,安装 nn~ 外部对象,然后在 Max 中打开补丁,或在 Ableton Live 中打开 Max for Live 设备。要训练自己的模型,请安装 GitHub 上的 Python 包,并按照下文的训练步骤操作。

AFTER 模型是什么?
AFTER 是 Audio Features Transfer and Exploration in Real-time 的缩写。它将音乐表现(结构)与声音身份(音色)分开,让您可以独立改变二者。
早期“黑箱”模型通过难以操控的抽象潜在坐标生成声音。AFTER 则使用明确的控制信号。您可以将一种乐器的演奏表现(例如人声的音高曲线)应用到模型学到的另一种音色,也可以完全通过 MIDI 演奏模型。与一次只能跟随一个音高的 DDSP不同,如果使用复音数据训练,AFTER 可以通过 MIDI 演奏和弦。
如果想改变已完成歌曲的风格,而不是单次演奏的音色,AI 混音会保留人声分轨,并根据文本提示词重新生成器乐部分。
历史与起源:ACIDS 团队
AFTER 源于 Nils Demerlé 在巴黎 IRCAM(声学/音乐研究与协调研究所)的博士研究。他在 ACIDS 团队与 Ninon Devis、Philippe Esling、Guillaume Doras 和 David Genova 合作,解决变分自编码器(VAEs)的一项局限。
RAVE 模型等 VAE 能很好地压缩音频,但音高和音色往往混在相同的潜在维度中(“纠缠”),因此难以分别控制。团队于 2024 年 8 月在论文 “利用潜在扩散结合音频控制与风格迁移” 中介绍了解决方案,目标是将扩散模型的音质带到现场音乐演奏中。

AFTER 如何工作?潜在扩散架构
AFTER 使用条件潜在扩散。它不会缓慢地逐个生成原始音频采样,而是在预训练自编码器提供的压缩“潜在”空间中工作。

结构与音色
AFTER 将声音拆成两路:
- **结构(局部特征):**明确且随时间变化的控制信号。
- **音频输入:**音高(f_0)和响度(A 计权)。
- **MIDI 输入:**复音钢琴卷帘表示。
- **音色(全局特征):**学习得到的嵌入向量,随时间保持固定,代表声音身份(例如“大提琴”“失真吉他”)。
处理步骤
- 压缩(编解码器): 神经音频编解码器(通常是 RAVE 自编码器)将输入音频压缩为低维潜在向量。
- **条件构建:**系统使用 CREPE 或 Basic Pitch 等工具提取音高和响度曲线,构建结构条件。
- **潜在扩散:**条件 U-Net 根据结构与目标音色预测音频潜在表示。
- **解码:**音频编解码器将预测的潜在表示解码回原始波形。
如何训练 AFTER 模型?
训练分为三个阶段。AFTER GitHub 仓库提供完整脚本。请在 Python 3.12 环境中安装 AFTER:
git clone https://github.com/acids-ircam/AFTER.git
cd AFTER/
pip install -e .1. 准备数据集
您需要音频数据集;为了获得良好结果,通常需要超过 1 小时的音频(DDSP、RAVE 和 AFTER 各需要多少数据)。如果目标乐器与其他乐器混在一起,请先通过高质量 AI 分轨分离将它隔离出来。
- 预处理:
after prepare_dataset脚本会分析音频,并提取真实参考特征。 - **工具:**使用 Spotify 的 Basic Pitch 进行 MIDI 转录,并为音频提取响度。数据存储在 LMDB 数据库中,以便训练时快速访问。
- **先检查转录:**在开始长时间训练之前,想听听素材转成音符的效果,可以先对短音频片段使用音频转 MIDI。音频转 MIDI 指南介绍了 Studio 中的步骤。
请先为自编码器准备波形数据集:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_audio --save_waveform True2. 训练自编码器(编解码器)
训练扩散模型之前,您需要一个压缩音频的“编解码器”。
- 方案 A:训练新的因果自编码器,使用多尺度频谱损失和对抗铰链损失。
- **方案 B:**使用 IRCAM 共享文件夹中的预训练编解码器,或以 RAVE 模型作为后端。如果已有适合该类音频的模型,这种方法更快。
方案 A 需要训练并导出自编码器:
after train_autoencoder --name AE_model_name --db_path /dataset/path_audio --config AE_4096 --gpu 0
after export_autoencoder --model_path autoencoder_runs/AE_model_name
导出会生成用于非实时处理的 export.ts 和用于实时运行的 export_stream.ts。
3. 训练扩散模型
这一阶段让模型学习控制信号如何映射为声音。
- 目标:模型最小化噪声预测误差(MSE)。也就是说,它学习逐步移除噪声,直到剩下目标声音。
- **解耦:**当音色编码器提取到音高信息时,对抗准则会惩罚模型,从而保持两种控制独立。
先使用编解码器编码音频,再训练扩散模型:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_latent --emb_model_path AE_model_run/export.ts
after train --name diff_model_name --db_path /dataset/path_latent --emb_model_path AE_model_run/export.ts --config audio
4. 导出以供实时使用
通过 after export 为 Audio-to-Audio 设备导出,或通过 after export_midi 为 MIDI-to-Audio 设备导出:
after export --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
after export_midi --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
导出还会生成一张 .png 潜在空间图。README 要求将它与 .ts 文件保存在一起。
如何实时使用 AFTER:Max for Live 与 Max/MSP
Max for Live(M4L)集成
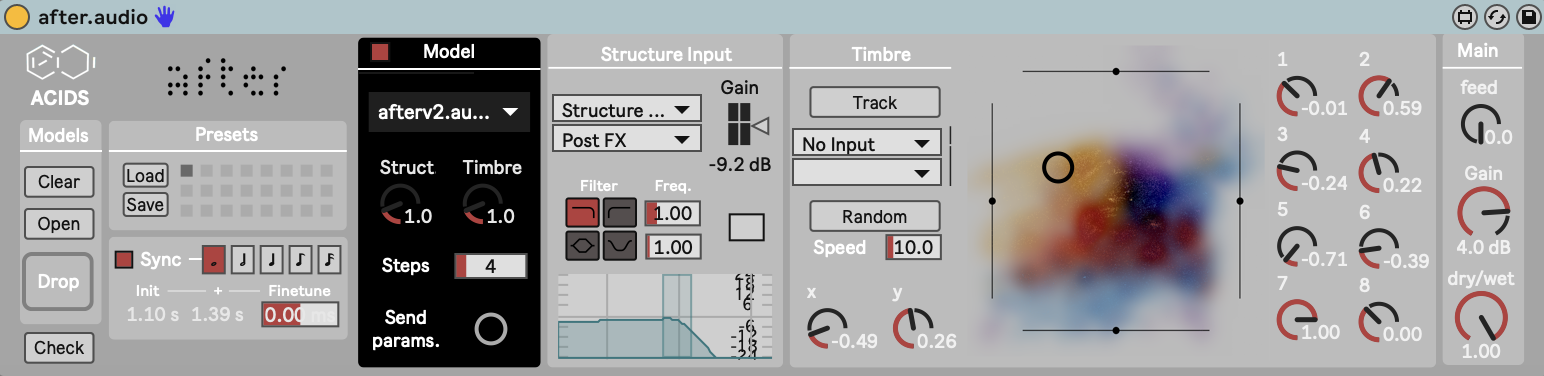
对于 Ableton Live 用户,AFTER 提供两个 Max for Live 设备,将 Live 连接到模型。
第一个是 **Audio-to-Audio。**它使用侧链输入(例如您的声音)来控制神经网络模型的音高和响度。
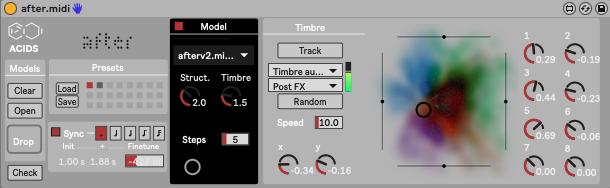
第二个是 MIDI-to-Audio。它以钢琴卷帘结构输入的形式,将 MIDI 音符送入模型。得益于潜在扩散架构,当模型使用复音数据训练时,它支持复音。如果想通过录制的采样演奏相同 MIDI,可在 sforzando 中加载 SFZ 乐器。
Max/MSP 与 nn~
对于开发者,AFTER 通过 nn~ 外部对象在 Max/MSP 中运行,可将导出的 TorchScript 模型(.ts 文件)直接加载到补丁中。
AFTER 的延迟是多少?
AFTER 与 RAVE 等单次前馈模型的行为不同,因为扩散需要多个步骤。
**延迟:**每一步去噪都会增加计算量,因此实时实现通常有 200 至 500 ms 的延迟。AFTER 会随演奏生成音频,但演奏时更像经过可预测的延迟,而不是立即响应的乐器。在现场演出中,一些音乐人改用“循环播放”的方式:AFTER 在下一个循环周期回放每个乐句。如果需要立即响应的乐器,免费神经网络吉他音箱插件中的小型网络更合适。
**GPU 利用率:**推理通过 nn~ 运行,该外部对象支持 GPU 加速,但实际使用中,用户感受到的差别不大。由于扩散是迭代进行的,CPU 占用率仍比标准 DSP 高。
AFTER 常见问题
AFTER 有 VST 插件吗?
没有。官方仓库提供适用于 Ableton Live 的 Max for Live 设备,以及通过 nn~ 运行的 Max 补丁,并未提及 VST 或 AU 插件。
AFTER 的预训练模型在哪里?
IRCAM 在共享文件夹中提供预训练模型、预训练编解码器和 Max 补丁,链接可在 AFTER README中找到。
AFTER 与 IRCAMAX 相同吗?
不相同。IRCAMAX 是 IRCAM 开发、由 Ableton 销售的商业 Max for Live 设备包。AFTER 则是 IRCAM 的 ACIDS 团队开发的研究模型,在 GitHub 上公开代码。
AFTER 还是 RAVE?
RAVE是延迟更低的单次处理模型,但它的控制项是抽象的潜在维度。AFTER 在编解码器之上加入明确的音高、响度和复音 MIDI 控制,代价是更高的延迟与 CPU 占用。